
返回话题榜兄弟姐妹家人们,今晚凌晨有重磅!!!
我们期待的 Opus 5.5、GPT-6 Sol / Luna / Astra-minor 要来了!!!
这还怎么睡啊,已经开始兴奋了 又有一大堆简中互联网的AI营销号把OpenAI和Anthropic内部一整套infra中的一个小小小微型模块开发优化半自动化的公关稿当成RSI爆炸性核弹级大新闻了,评论区月经开始复读“坏了,RSI这次真的已经来了,人类赶紧等死吧”,服了。 Claude 这波太大方了,牛逼😭
Opus 5.5 超越 Fable 5.1,比 Opus 5 便宜 40%,5 小时额度加 20%,还开始送 Resets 了!!!
可前提是,你的号别被封啊。。。
我被封 X 次才把整套环境搞懂,全写在这篇里了,想稳定用上 Claude,收藏起来照着做就完事了! 不想承认这一点,但是不得不承认 Opus 5.5 真的强到爆棚。
思路清晰,回复有条理且准确,代码理解能力极强,令人惊叹。语言问题也不存在了,那个 Opus 又回来了。
只能说太强了,强到 DeepSeek v4.1 flash 在他面前黯然无光,可惜 Opus 5.5 目前是 A/ 的,要是一个开源模型那该多好 根据这张图我们优选模型挡位
Opus 5.5 medium
GPT-6 Sol high
GPT-6 Luna extra-high https://t.co/uKVUrfz1kc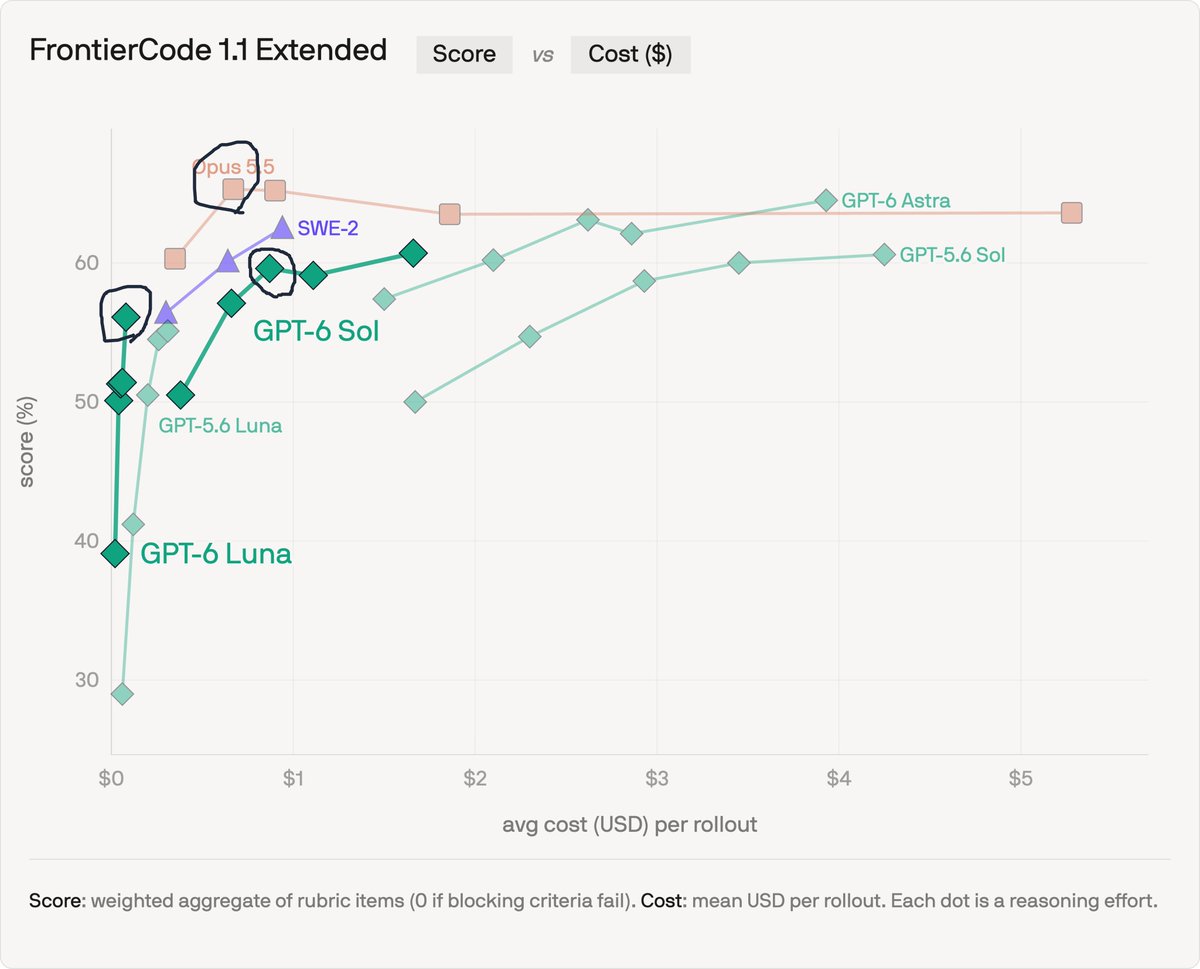
谷歌Gemini 躲在角落里哭… https://t.co/XF9MmQoQMg WTF???GPT-6 Sol和GPT-6 Luna正式上线,简直是价格屠夫,Luna直接比DeepSeek还便宜,咱老百姓也能爽玩Codex了!
GPT-6 Sol和GPT-6Luna比GPT 5.6同系列模型便宜一半,也就是比GPT-6Astra要便宜四倍!!!
等于说,我现在就只用GPT-6 Sol模型,我只要有一个GPT Pro20×账号,等于原本Astra状态下的五个账号。
但是我有两个20×,所以我等于有了10个账号!!!Crazy!!!
我现在已经把所有Astra定时任务全部切换成了Sol。
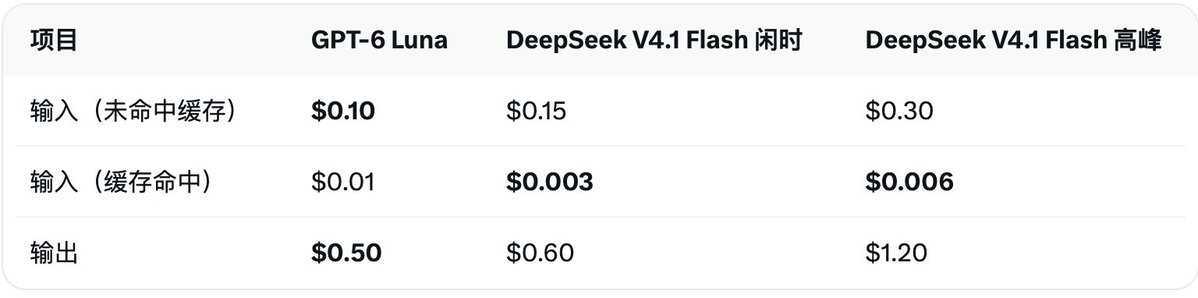
也准备把Luna的API全量替代原来的DeepSeek V4.1-Flash。
感觉以后只要不是特别大的开发项目,就用Sol+Luna已经绰绰有余,而且对咱这种非专业编程人员性价比简直拉到满中满!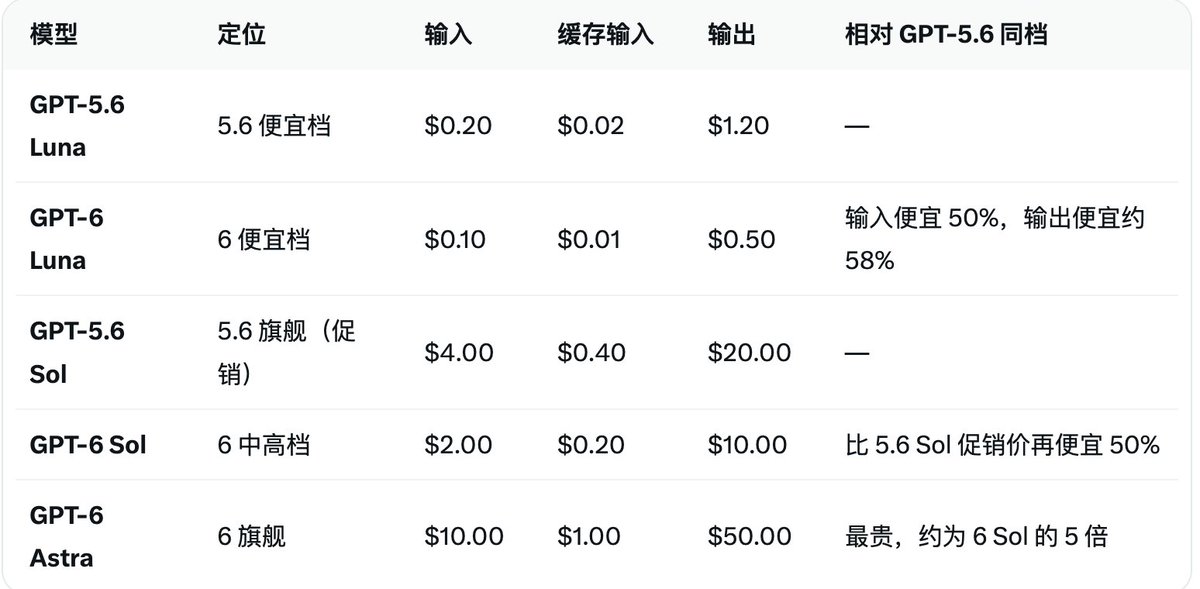
Claude 发布了新模型 Opus 5.5,声称多数表现堪比之前的最强模型 Fable 5.1,单价大约 4 折,且生成和处理速度快不少。
所以 Dario 老哥,一边发表 AI 威胁论,呼吁全行业放慢 AI 发展,一边自己偷偷在蓄力做个大的? https://t.co/AViz9JugKS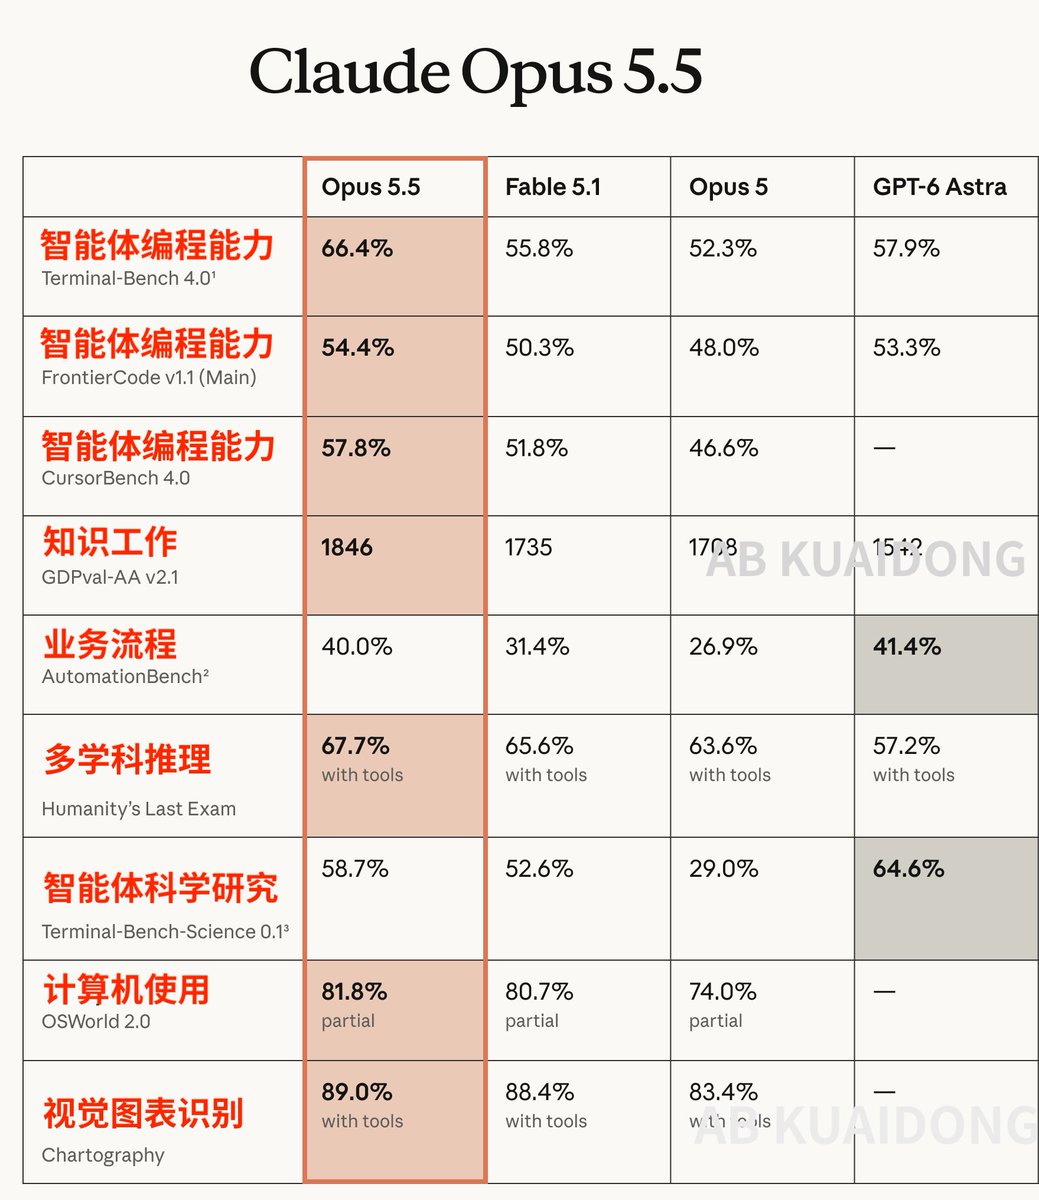
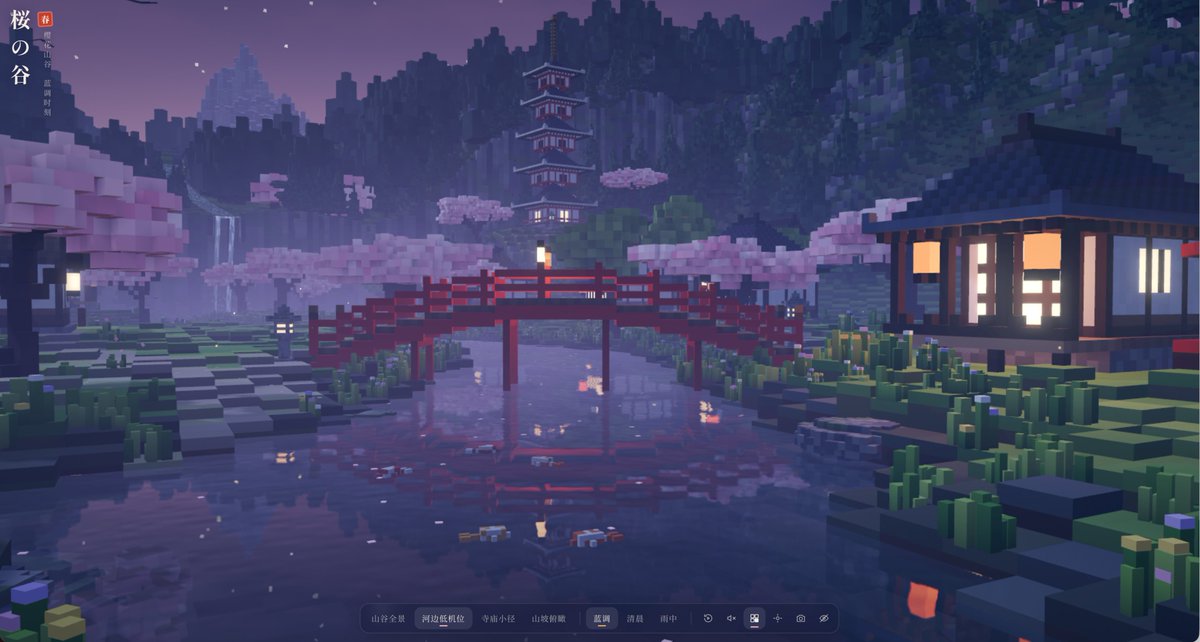
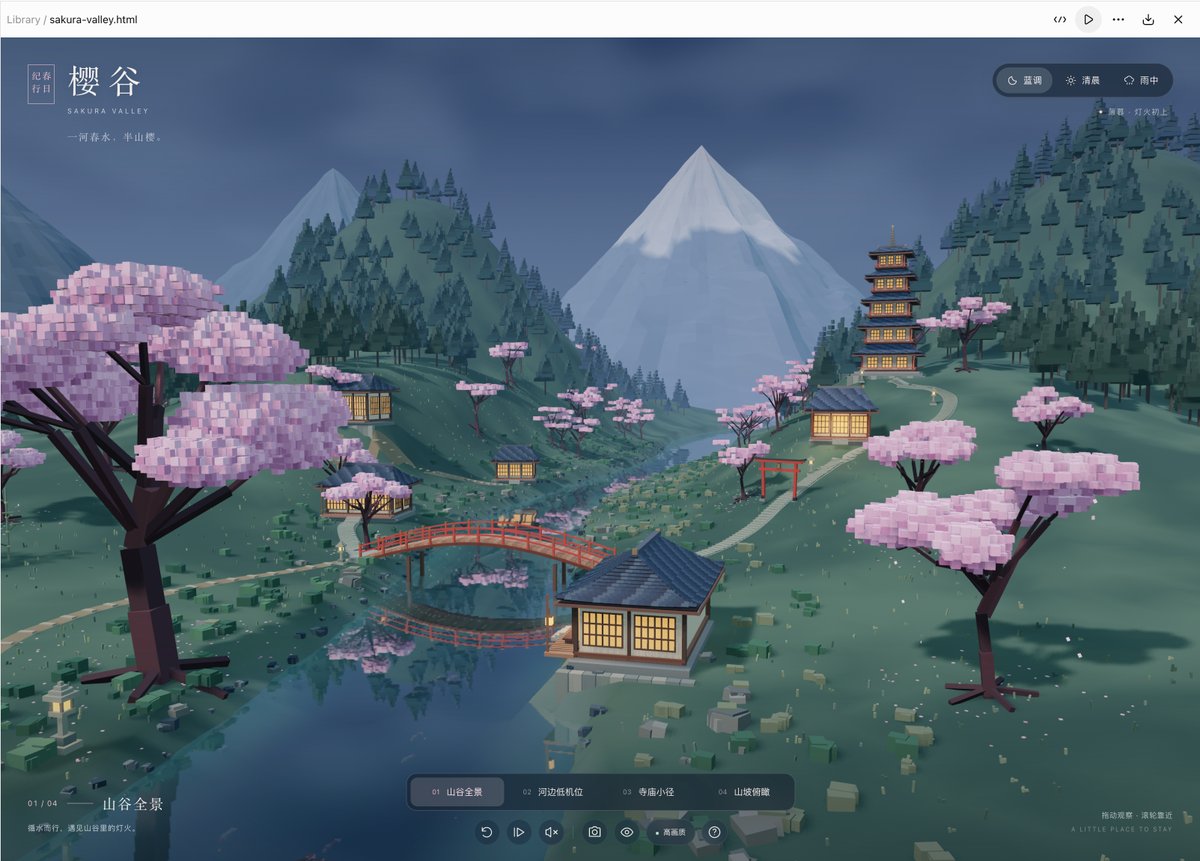
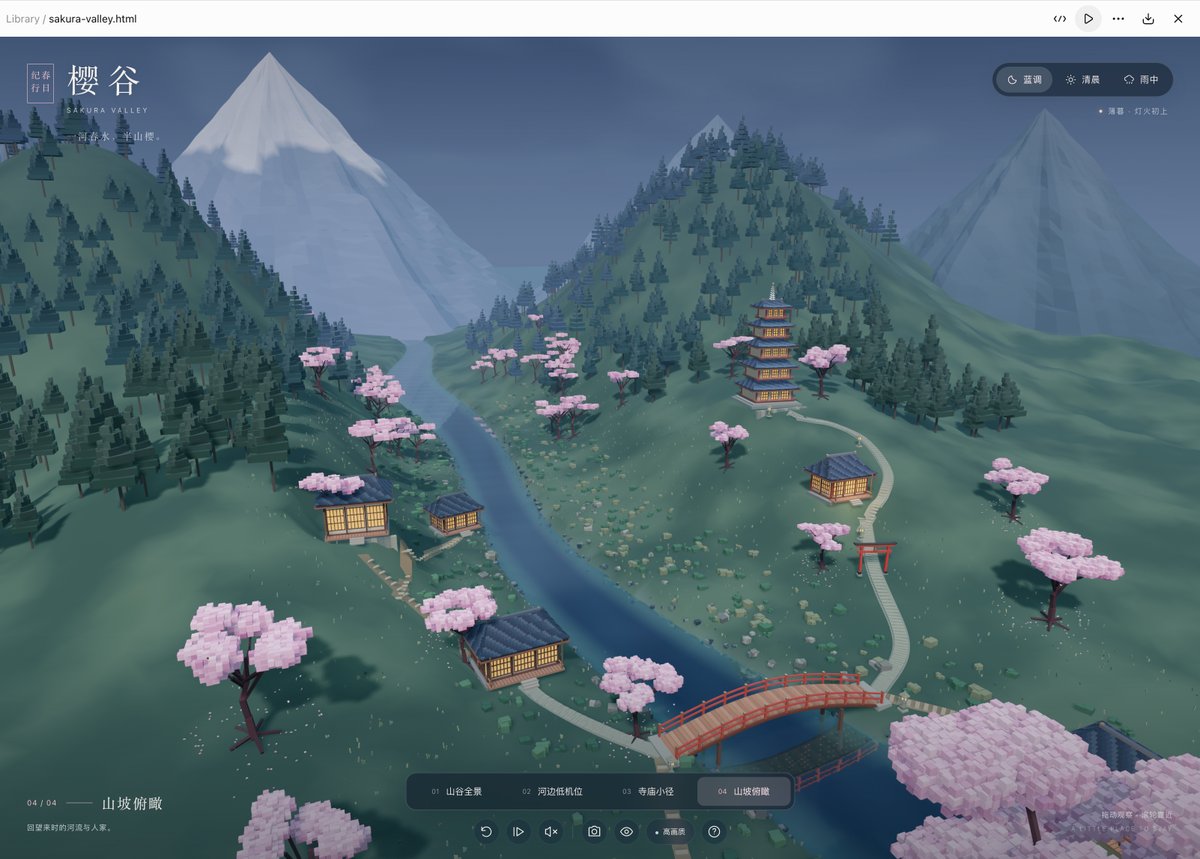
Opus 5.5(图1-2) vs GPT 6 Astra(图3-4)
Opus 5.5 网页:https://t.co/j3GoI1D79W
GPT 6 Astra 网页:https://t.co/6G7oaP6cQW
--- Prompt ---
请直接制作一个可以在浏览器中实时交互的高完成度 3D 景观网页。
主题:日式樱花山谷。
使用 HTML、CSS、JavaScript 实现。不要生成图片,不要只给设计方案,
不要用一张背景图加视差效果冒充 3D。我要的是实际可运行、可游览的成品。
【一、作品定位】
这是一片完整、连续、有��近层次的山谷景观,
不是孤立的小摆件、悬浮岛、带底座的沙盘,也不是单纯的技术演示。
风格是现代精细体素 / voxel art:
保留立方体几何的造型语言,但画面应高分辨率、抗锯齿、光影细腻。
不要复古低分辨率像素化,不要粗大积木堆砌,不要给画面套像素滤镜。
视觉质量优先。宁可少几个功能,也不要牺牲构图、材质和光照。
【二、参考图的使用方式】
如果附有参考图,请先理解它的构图层次、尺度、光线和色彩关系。
仅借鉴氛围与视觉语言,重新设计场景,
不要照搬建筑、树木、山体和道路的位置,不要 1:1 复刻。
参考图不是网页里的背景素材。场景本身必须由真实 3D 几何构成。
【三、场景构图】
默认打开时就应呈现一幅完整、有吸引力的画面,
不需要用户先旋转镜头才能找到好看的角度。
采用透视相机,而不是沙盘式等距俯视相机。
画面有明确的前景、中景、远景:
前景:
一株有存在感的古老樱花树,配合岩石、草木、石灯笼和少量落花,
形成画面边缘的自然框景,但不能挡住河流、桥和主要建筑。
中景:
一条蜿蜒河流引导视线进入画面,红色木桥横跨河面;
村落、茶屋、神社和小径顺着地势分布,建筑之间有真实的通行关系。
地面有起伏、岸线和自然过渡,不是平面上均匀摆放模型。
远景:
山坡上的多层塔、不同距离的森林和山脊,以及远处的雪山。
用尺度变化、遮挡、冷暖变化和空气透视表现距离,
而不是仅仅把远处物体缩小。
不要把所有元素均匀铺满。需要主次、疏密、留白和清楚的视觉焦点。
【四、造型与画面质量】
樱花树:
树干有转折、分叉和根部,树冠由不规则花簇组成,
有间隙、厚薄变化和可见枝条。不要做成几个规则球体或方块团。
建筑:
屋顶有层叠瓦片、挑檐、梁柱和窗格;
不同建筑有用途、体量和高度差异,不要复制同一栋房子铺满山谷。
地形:
岸边有���润石块、草丛和植被过渡。
避免过于规律的台阶、重复条纹、棋盘格和明显的程序生成网格。
水面:
必须能够反映周围景物,具有适度的波纹、深浅变化和岸边过渡。
尽量使用实际场景反射;需要性能降级时也应保持视觉可信。
不要用闪烁噪声、强烈扭曲或一整块蓝色平面代替水。
细节:
可以有少量锦鲤、落花、萤火虫、瀑布和远处飞鸟,
但都应服务于氛围,不能让画面显得嘈杂。
不要为了宣称模型数量而堆砌细节。
【五、色彩与氛围】
默认是蓝调时刻:
偏冷的山谷与远山,柔和的粉色樱花,温暖但不过曝的灯笼和窗光。
暖光集中在有人活动的地方,不要把整个环境染成橙色。
需要柔和阴影、物体接触处的明暗、合理的曝光、
克制的泛光、抗锯齿和有距离层次的薄雾。
避免发白、灰蒙、过度饱和、满屏浓雾、过曝灯光和明显锯齿。
方块几何可以清晰,但渲染本身不能粗糙。
另提供“清晨”和“雨中”两种氛围;
切换时应同步改变天空、环境光、雾和局部效果,
不是仅仅修改背景颜色。
【六、交互与界面】
提供四个经过设计的镜头:
山谷全景、河边低机位、寺庙小径、山坡俯瞰。
切换应平滑,每个镜头都需要有独立的构图价值。
基础交互:
鼠标拖动观察、滚轮缩放或前进,触屏支持拖动和双指缩放。
提供重置视角、隐藏界面和保存当前画面的功能。
可选增强:
自由探索、缓慢镜头巡游、环境音。
环境音默认关闭,只在用户主动点击后播放。
额外功能不能影响默认画面的完成度。
界面要克制、有设计感,以景观为主。
标题和控制条放在边缘,不遮挡视觉焦点。
桌面和手机都不能出现按钮越界、文字重叠或无法操作的问题。
【七、工程与性能】
允许使用 Three.js / WebGL,以及版本固定、互相兼容的 CDN 依赖。
优先使用成熟渲染能力,不要为了“零依赖”重写整套引擎。
自写的 HTML、CSS、JavaScript 尽量整理在一个 HTML 文件中。
景物由程序化几何和材质生成,不依赖外部图片或 3D 模型资源。
重复物体采用适合的批量或实例化绘制方式;
合理控制细分、阴影、反射和渲染分辨率。
提供高画质和轻量模式,手机默认使用较轻设置。
不要靠无限增加体素数量换取细节。
加入加载提示、WebGL 不支持时的提示和必要的错误处理。
没有开启声音时不要自动播放;尊重减少动态效果的系统偏好。
【八、交付前验收】
不要写完代码就立即交付。
如果当前环境支持浏览器运行和截图,请先实际打开页面,
检查默认镜头、四个视角、氛围切换、桌面和手机布局,
再根据截图修正明显的构图、曝光、遮挡和渲染问题。
重点检查:
是否存在空白画面、加载失败、控制台错误;
是否有穿模、闪烁、阴影条纹、过曝、水面异常;
默认画面是否真正像完整景观,而不是小型沙盘;
功能按钮是否实际可用,移动端是否越界。
可以使用浏览器截图验收,但不要调用图像生成工具。
没有完成的测试要如实说明,不要声称已经验证。
最终交付:
1. 实际存在、可以打开的 HTML 文件,或当前环境支持的交互预览。
2. 如能截图,附一张真实浏览器渲染截图。
3. 简短说明操作方式和必要的运行条件。
请直接完成制作;非关键细节自行作出一致的设计选择,
不要把可以自行解决的实现问题反复交给我决定。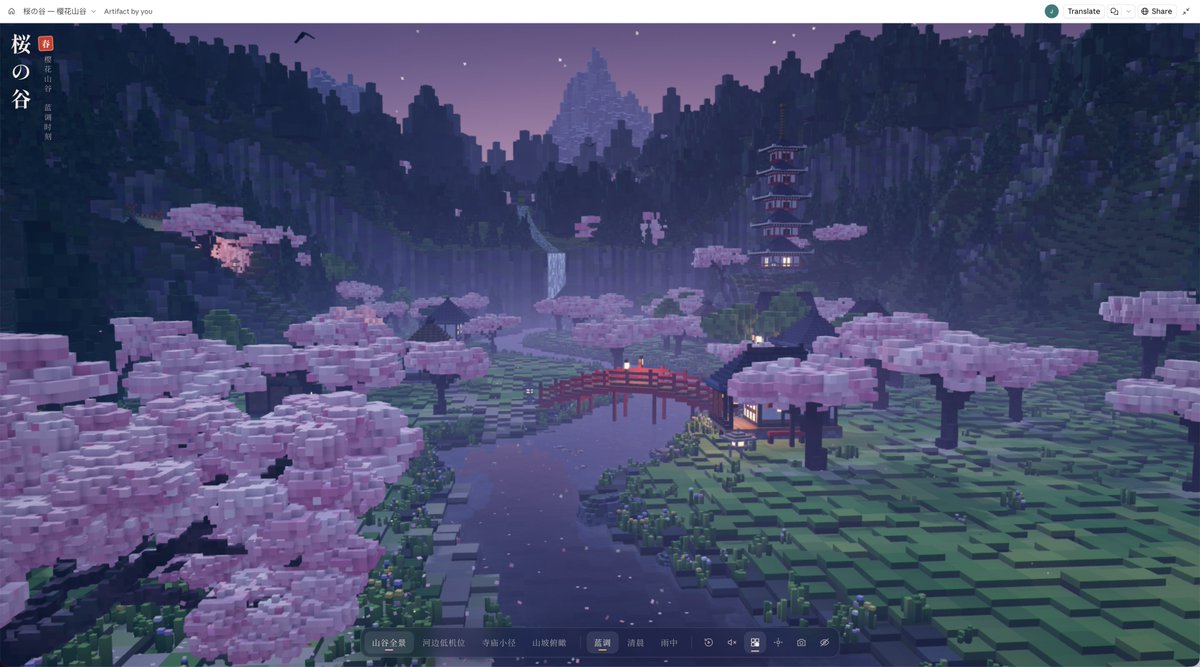
人麻了,前几天不是都喊着模型要放慢吗。
怎么这模型跟不要钱一样往外面扔啊。
昨天Grok 4.7 PK MiMo v2.6,是给今天这两大哥演个前戏是吧。
今天凌晨,OpenAI的GPT-6 Sol和GPT-6 Luna,以及Anthropic的Claude Opus
别尝试,别用,别订阅,问就是会毁灭人类。保护地球,从我做起,退订 Claude。
Buy the dip,长期持有,Discord在个人资料。 🎉重磅!Claude Opus 5.5 来了!
据说性能直追Fable 5.1
Tibo ,请开始你的表演!
赶紧重置,精准狙击! https://t.co/rIIpydsHWA Claude刚刚更新了Opus 5.5,一句话说完:比Opus 5更快也更便宜,跑分上还赢了自家最贵的Fable 5.1和GPT-6 Astra。然后A社这次还给每个订阅用户送了一次reset,点一下额度就回满,你把Claude
GPT-6 Sol 和 Luna 也发布了,但看起来能力不足预期啊,完全没有惊喜感。
另外手动重置也要发了。
OpenAI 要走廉价路线了吗? OpenAI发布GPT-6 Sol与Luna,API价格较GPT-5.6降低50%
OpenAI今日推出GPT-6家族新成员——GPT-6 Sol和GPT-6 Luna,二者基于GPT-6 Astra的技术进展打造,分别面向复杂编程/专业工作场景(Sol)与快速高效的大规模日常任务(Luna)。
定价方面,Sol输入/输出价格为每百万token 2美元/10美元,Luna为0.10美元/0.50美元,较GPT-5.6促销价格低50%。
两款模型已在ChatGPT Work和Codex中向Plus、Pro、Business、Enterprise及Edu用户开放,同时接入API;Free和Go用户可在桌面端试用Luna GPT-6-Luna 短上下文、缓存未命中/输出为主的负载,Luna 便宜 1.2–2.6×。
输入超过 272K 或缓存命中为主的 agent 负载,DeepSeek-V4.1-Flash 反超或持平。
坏了梁子,这是冲你来了~ https://t.co/BvAgFpmMr7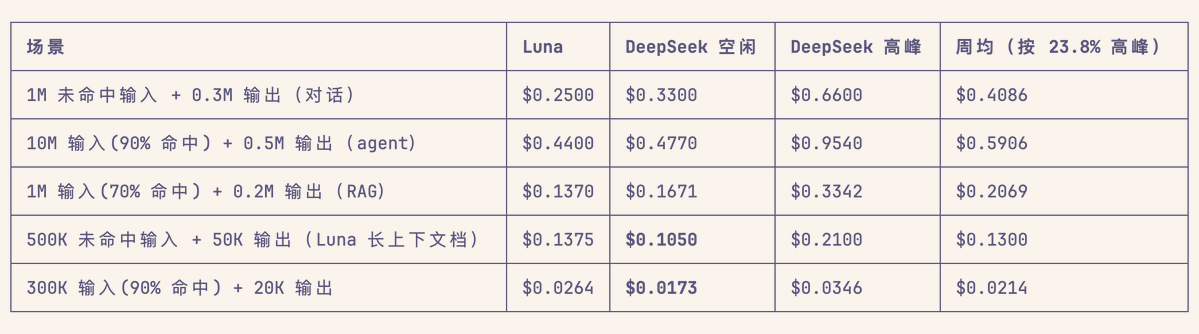
给用 Claude Code 的同学算一笔具体的账:
假设你一个编码 Agent 任务平均消耗 50 万 cache read tokens + 5 万 input tokens + 10 万 output tokens。按 Opus 5 的价格是 $0.25 + $0.25 + $2.50 = $3.00。
同样的任务 Opus 5.5 价格是 $0.10 + $0.20 + $2.00 = $2.30。单任务省了约 23%。但 Anthropic 说 Opus 5.5 平均用的 token 更少(200k 代码审计场景少了 60%),如果 token 用量也降了,实际省幅会更大。
还有一个容易忽略的点:Fast mode。$8 input / $40 output,速度提到 2.5 倍。如果你的场景对延迟敏感、对成本不那么敏感,比如在 Cursor 里做交互式编码,Fast mode 的体验提升可能比默认模式的跑分提升更直接。
最后说 preserved thinking。这个是从 Fable 5.1 延续过来的反蒸馏机制,API 用户不能编辑 Claude 之前的推理上下文。
而且 Opus 5.5 不能关闭 thinking 模式。对于在生产环境中需要稳定输出格式的开发者,接入前先看一下官方的迁移文档。

但凡长脑子的人,都会用脑子稍微想一想,
如果anthropic真用了一部分TPU做LLM training,哪怕只有几千张,你猜猜google会不会每天在全世界媒体上狂轰滥炸,告诉全世界google一个TPU部门可以有机会单挑nvndia了?
google会不会每季度财报上恨不得第一页第一行就写自己给anthropic卖了多少片TPU了? GPT 6 全系列更新,Sol 和 Luna 价格下降 50%,并且学会了说人话,而 Terra 消失了。
GPT 6 Sol 和 Luna 使用了与 Astra 类似的训练方法,能力更强,对齐更好,价格更低。
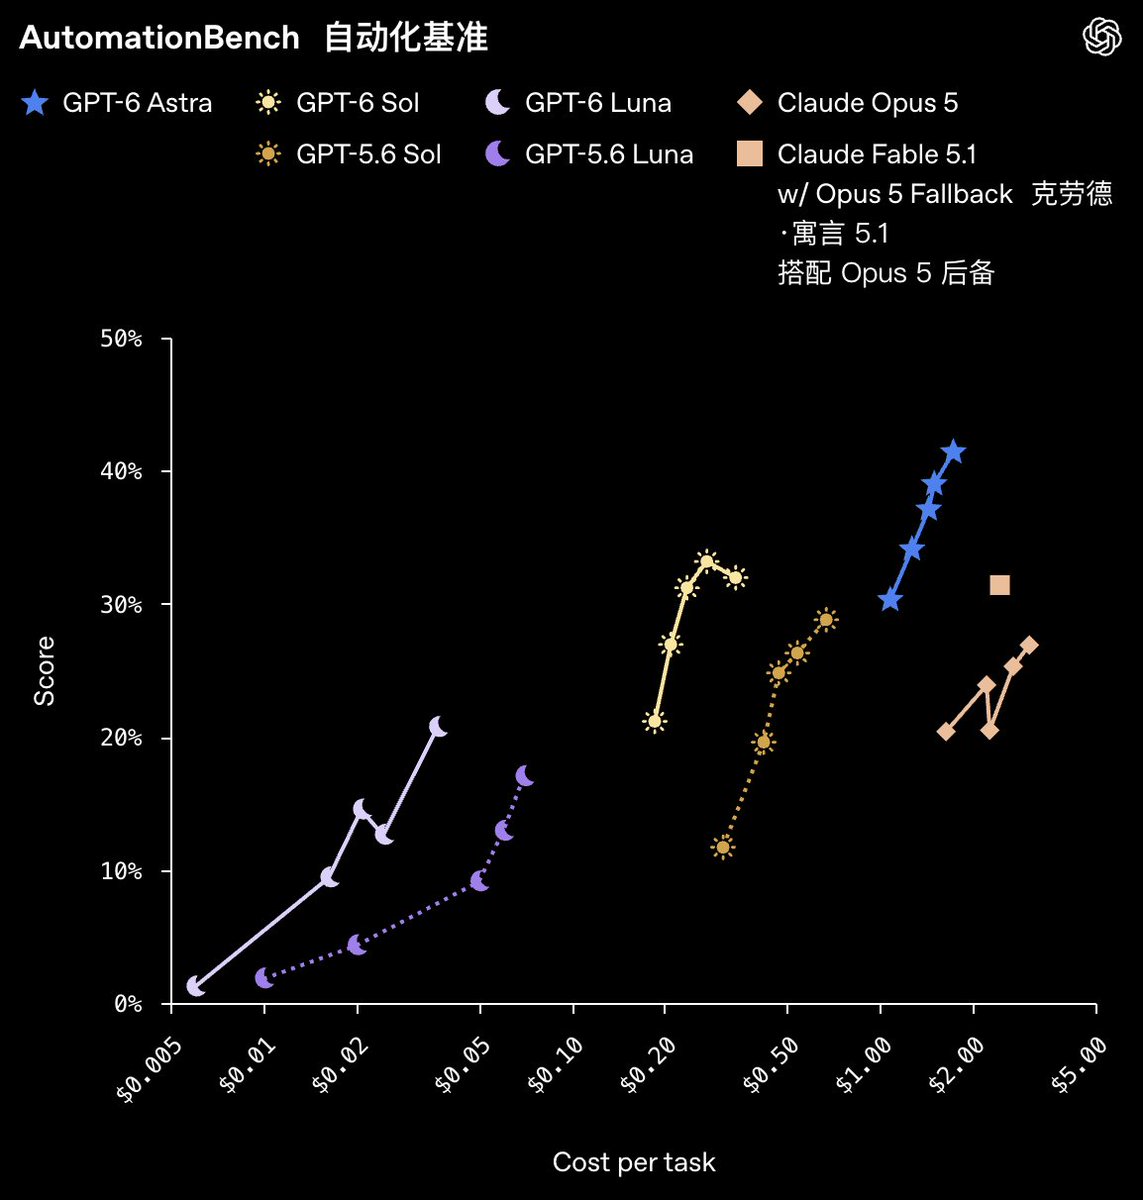
在 AutomationBench中,GPT 6 Sol 的表现超越了 Opus 5 的同时,只用了其 9% 的成本,便宜10倍。
GPT 6 Sol 和 Luna 的语言风格和 Astra 相同,表达更清晰,黑话更少,言简意赅,减少不必要的细节。
GPT 6 Sol 在 OSWorld 2.0 等某些指标上不如 GPT 5.6 Sol,这是需要注意的。
OpenAI 这次还特别改进了缓存机制,实现了更高的缓存命中率(他们终于学会了ds的技术)
同时 A 社也在今天发布了 Opus 5.5,象征性地降价了 20%,缓存降价了 60%,在 Agent 任务中,综合下降约 40% 。
我们终于迎来了大模型的大降价时代,感谢竞争,感谢 DeepSeek 和 GLM,请不要停,请继续降。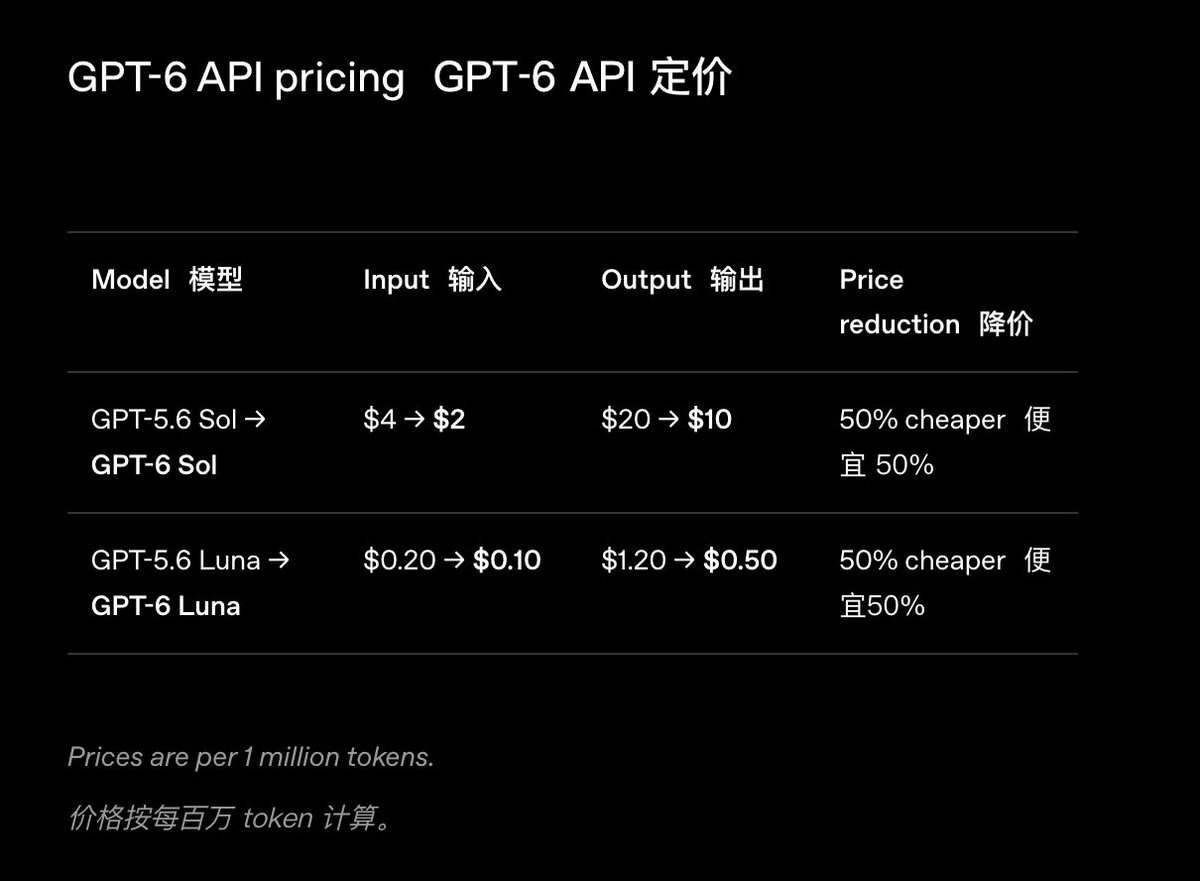
Opus 5.5 写作目前给我感觉非常好,比 Opus 4.6 还好点 OpenAI 发布 GPT-6 Sol 和 GPT-6 Luna:旗舰级能力下放,API 价格砍半
OpenAI 推出 GPT-6 家族的两款新模型 Sol 和 Luna,主打“接近旗舰的能力,大幅更低的价格”。API 价格比上一代 GPT-5.6 的促销价再降 50%。
先理清命名。本月早些时候,OpenAI 发布了 GPT-6 Astra,定位是最强的旗舰模型。这次的 Sol 是中档,Luna 是轻量档,相当于同一代技术的“大、中、小杯”。三款模型用相似的方法训练,所以 Astra 在编程、事实准确性、操作电脑等方面的进步,也带到了更便宜的两款上。
OpenAI 这次的对比对象主要是 Anthropic 的 Claude。以下数据都来自 OpenAI 自己公布的评测,第三方复现结果还需等待。
在模拟跨应用处理销售、财务、HR 等业务流程的 AutomationBench 上,Sol 以最高推理强度拿到 33.2%,每个任务成本约 0.27 美元。它超过了最高强度的 Claude Opus 5(26.9%),成本只有后者的 9% 左右,也略高于低强度的 Astra。“推理强度”可以理解为让模型想多久,想得越久,效果越好,但也越贵。
编程方面,在真实代码库的长任务评测 DeepSWE 上,Sol 得分 68.8%,和 Claude Fable 5 的 69.9% 只差 1.1 个百分点,每任务成本低约 80%。更便宜的 Luna 也有 66.6%,与中等强度的 Opus 5、Fable 5 相当,成本低 93% 到 96%。在让 AI 操作电脑完成任务的 OSWorld 2.0 上,Sol 和 Opus 5 分数几乎打平,成本同样低约 80%。
对开发者来说,这意味着跑长时间的编程 AI 智能体会便宜很多。OpenAI 透露,内部研究员每天的 token 消耗按 API 价格算,中位数超过 600 美元。模型越能干,这笔账就越重要。
另一个实用改进是提示缓存。简单说,你反复发送的相同内容,比如系统提示、整个代码库,第二次读取时可以打一折,也就是缓存输入享受 90% 折扣。现在中途调整推理强度或开关工具都不会让缓存失效,开发者还能自己指定缓存的断点。GitHub 表示,这些改进让 Copilot 需要重新处理的 token 减少了一半以上,响应也更快。
使用体验上,Sol 和 Luna 继承了 Astra 的回答风格:更直接,术语更少,废话更少,回答略短。在事实准确性上,OpenAI 称 Sol 的错误比上一代少了约一半。
可用情况:即日起,Plus、Pro、Business、Enterprise 和 Edu 用户可以在 ChatGPT Work 和 Codex 中使用这两款模型。免费用户和 Go 用户可以在桌面端用 Luna。普通 Chat 界面暂未上线,ChatGPT 端会在当天分批推送。API 模型名为 gpt-6-sol 和 gpt-6-luna。 给大家带来claude opus 5.5 的前端测试结果. 直接说结论, 我怀疑现在opus 5.5就是 fable 5.1 的量化版或者自家蒸馏版, 可以直接看我的视频, 几乎看不出两个模型实现细节上的差别.
而且模型继承了Anthropic一贯的优良特点, 一个字, 稳, 6次抽卡6次全都是这个质量.
除此之外我测试时很明显 opus 5.5 的思考token消耗更多. 这意味着opus5.5模型会更小一些(用reasoning长度换性能).
这同样意味着会有雷霆大思考的情况, 比如最后一个火山喷发测试, 我terminal和网页都测试了好几次, 结果都无法输出代码. 思考卡住了.
当然瑕不掩瑜. 毕竟比fable便宜又能获得差不多的性能, 只要不降智, 就是好模型(但无奈Anthropic降智是祖传艺能...).
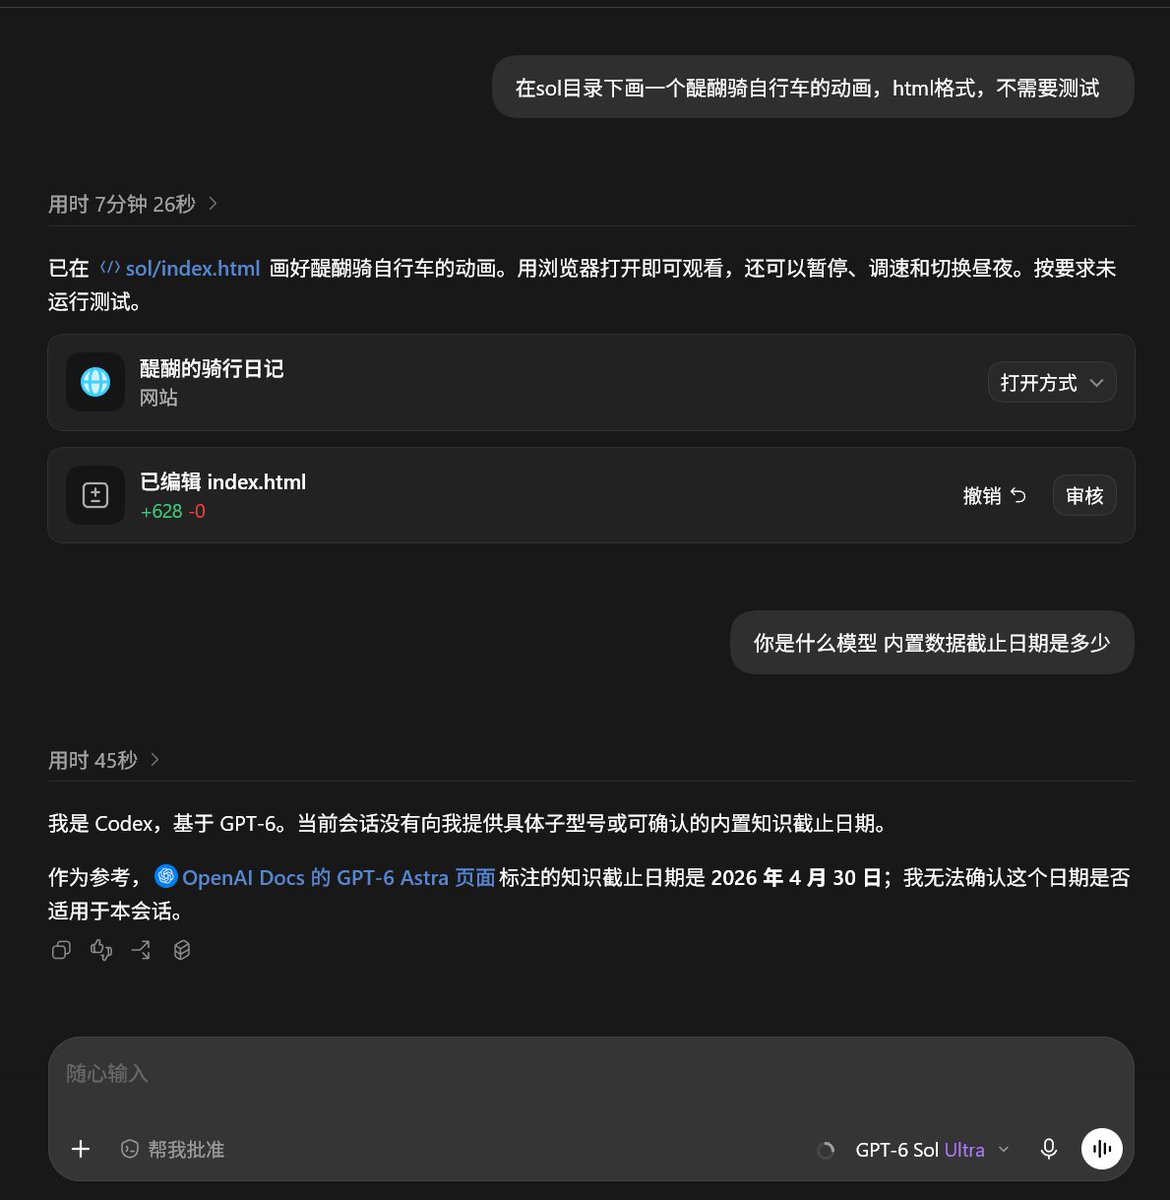
> #opus55 #claudeopus55 #anthropic GPT6-Sol #醍醐骑车 评测。还有 GPT6-Luna、GPT6-Astra对比。
看起来Sol没有理解醍醐是啥玩意儿。本来以为降智了,但问了下数据日期又好像没有。
#Chatgpt #Codex #Ai #人工智能 #Opus #Anthropic #Deepseek #kimi #mimo https://t.co/Cd110dJvFM


Yeah!!!重置卡来啦 🚨OMG,DeepSeek 竟然在价格上被 GPT 超越了。。。。
@OpenAI 刚发的 GPT-6 Luna,API 价格直接干到:
输入 0.1 美元 / 百万 Token
输出 0.5 美元 / 百万 Token
这个价格,已经比 DeepSeek V4.1 Flash 的闲时价还低。
更离谱的是,它还不是那种单纯靠便宜换能力的小模型。
OpenAI 放出来的图里,GPT-6 Luna 在 DeepSWE、FrontierCode 这种 coding benchmark 上,已经跑到了一个相当能用的水平,而且 cost per task 低得吓人。
当然, @deepseek_ai 还没被全面打穿。
DeepSeek V4.1 Flash 在 DeepSWE v1.1 里还是 74.2,Luna 图里���概 67 左右。
但真正可怕的地方已经不是谁多几分了。
而是过去大家默认:
美国模型负责卷能力,
国产模型负责卷价格。
现在 OpenAI 连价格也开始一起卷。。。。
DeepSeek 最经典的护城河,居然先被 OpenAI 自己踩进来了。
难道国产模型以后真的要沦为信创模型了吗?

OpenAI愿意开放research program,挑选一批(大约1万人)一线researcher、教授、PhD们提供额外的“帮助”,实际上就是价值几千刀的token。
而在OpenAI内部做数学和research的人,都有完全不限量的免费token,如果使劲儿蹬subagent,可能gpt-6 astra每小时就消耗2000刀。
而在另一边,还有大批大批的人 ,连任何LLM Agent都不用,还在用latex和纸笔每天推式子,甚至从情绪和立场上彻底抗拒AI时代和AI入侵。
这就是现在最真实的现状,三个阶层的人,已经走向了完全不同的命运。 GPT-6-Sol和Claude Opus 5.5都来了。
很遗憾,这次Anthropic的Opus 5.5赢了,GPT-6-Sol一败涂地。 一个明显的感觉,前沿大模型的智能似乎真的快到极限了...
最近的进展已经从提升智能逐步转向应用场景了,Astra Ultra 我用了两周了,真心没觉得有什么里程碑式的提升,只是在任务处理和正确率上好了很多...
反倒是应用场景越来越多的进入了生活,模型端的进展开始逐步变成了如何省钱,比如最新的 Opus...
Scaling Law 还在生效吗?
我怎么感觉整个 AI 叙事头上有一层透明的物理天花板渐渐出现了... 每次 OpenAI 发布新模型,第一周体验都特别好,然后它就似乎变成了一个不一样的更差的模型。
Claude 如果第一周是个烂模型它后面还是个烂模型,但是如果是个好模型,它一周后还是个好模型 😂 刚刚,OpenAI 正式发布 GPT-6 Sol 和 GPT-6 Luna。
GPT-6 这一代终于开始全面铺开了。
月初 OpenAI 先发布了最强的 GPT-6 Astra,现在开始把 Astra 上的能力往更便宜、更日常的模型上下放。
这次最狠的是 GPT-6 Sol,API 价格直接来到了:
输入:$2 / M tokens
输出:$10 / M tokens
相比 GPT-5.6 Sol 的促销价格,直接便宜了 50%。
但能力并没有跟着砍半。
OpenAI 表示,GPT-6 Sol 使用了和 Astra 类似的训练方法,在推理、事实可靠性、Coding、Computer Use 和 Alignment 上都进行了升级。
其中一个数据很夸张:
OpenAI 用真实用户曾经举报过模型错误的对话做了一套内部 factuality eval,GPT-6 Sol 的错误数量只有上一代 GPT-5.6 Sol 的大约一半。
OpenAI 甚至称,它的可靠性已经接近 GPT-6 Astra。
也就是说,Astra 继续负责最高难度的任务,但大量 Coding、Agent、自动化和 Computer Use 工作,已经可以直接丢给便宜得多的 Sol。
另外还有一个更便宜的 GPT-6 Luna:
输入 $0.1 / M
输出 $0.5 / M
这个价格已经明显不是冲着「聊天」来的了,而是冲着海量 Agent 调用、文档处理、信息提取这些机器对机器的 workload 去的。
Anthropic 才刚发布 Claude Opus 5.5,大约 90 分钟后,OpenAI 就把 GPT-6 Sol 和 Luna 发了出来。
前沿模型在上面继续卷能力,下面已经开始疯狂卷价格。
Agent 真正大规模跑起来之前,模型 API 的价格战可能才刚开始。 OpenAI今天推出GPT-6 Sol和GPT-6 Luna,面向 ChatGPT Plus、Pro、Business、Enterprise 和 Edu 用户开放,可在 ChatGPT Work、Codex 及 API 中使用。Free 和 Go 用户也能通过桌面应用试用GPT-6 Luna。 GPT-6 Sol和GPT-6 Luna已经在Codex中上线。 https://t.co/S0xfO3LwNH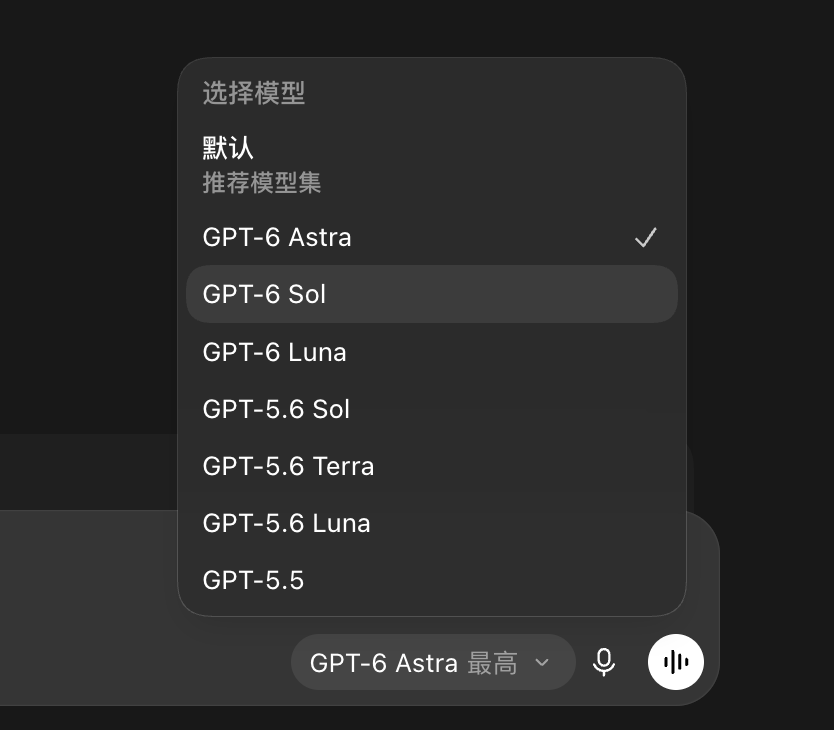
来了!来了!GPT-6 Sol https://t.co/CgsxHJmoG0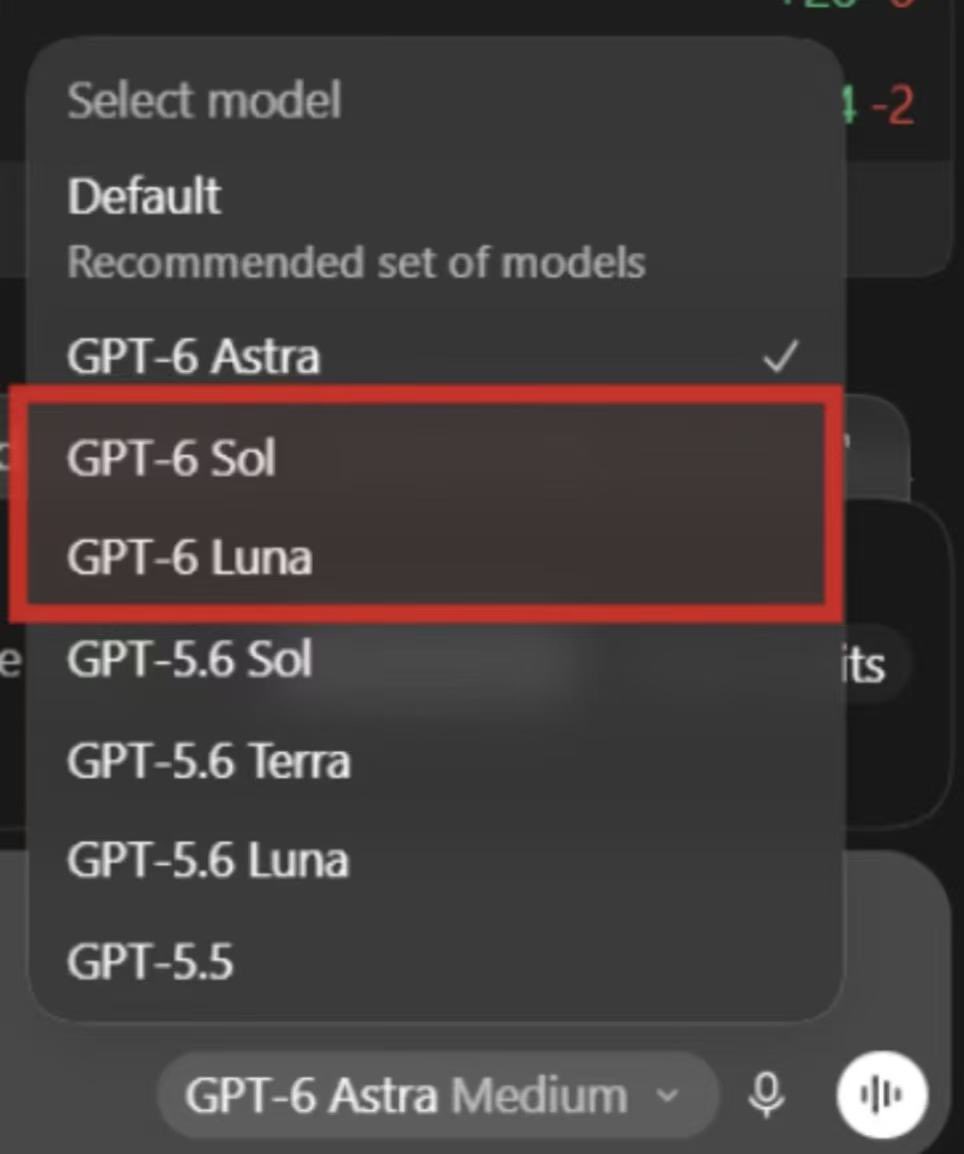
Anthropic 内部的的 工程师Dan Fein,分享了Opus 5.5 今天发布后的第一批内部 demo,一万三千块瓷砖,零张图片,
纯代码生成视觉内容这个方向,之前 Fable 5.1 也能做,但瓷砖数量和��画复杂度到这个级别的,确实是头一次见到,
一个纯代码马赛克动画,13,081 个瓷砖的颜色、位置和运动轨迹全部由模型在代码里算出来,没有引入任何外部图片文件。
这意味着模型需要同时理解像素级的色彩构成、瓷砖在画布上的几何排列、以及随时间变化的帧动画逻辑。最后还有一个细节——画面里星星的水面倒影会逐渐变形,孵化成 22 条游动的小鱼,这些形变和运动也是纯数学计算。
不是一次简单的 HTML 输出,是一万三千个元素在同一个坐标系里协调运动,且视觉上能看。
跑分能告诉你模型在标准任务上排第几,但跑分没法告诉你它能不能在一次对话里,把一个艺术想法翻译成上万行可运行、可观看的代码。
这类任务对上下文管理、空间推理和代码一致性的要求远超典型 benchmark 覆盖的范围。
不过也要说清楚:这是一个展示上限的 demo,不代表每次都能复现同等质量。模型在视觉代码生成上确实有了明显跃迁,但具体到你自己的项目,效果还是要实测。 https://t.co/ZuLyQIncBF 估计tibo是想等gpt-6-sol发布再重置。但隔壁claude 5.5都已经发了,还放宽了5小时限额,到时候可千万别拉坨大的😅 喵个咪,还是要有竞争啊,要不是@OpenAI 和GPT-6给压力,桀骜不驯的@DarioAmodei 能把能把能力接近Fable 5.1 的Opus 5.5 价格压这么低吗?
两个月前 Opus 5 的卖点是"接近 Fable 但便宜一半",刚发布的 Opus 5.5 直接做到了大多数任务持平甚至超过 Fable 5.1,价格比 Opus 5 再降 40%,Fable 级智力,Opus 级价格,输出速度还快了三成。
先看跑分,Terminal-Bench 4.0 拿了 66.4%,Fable 5.1 是 55.8%,GPT-6 Astra 57.9%。CursorBench 4.0 拿了 57.8%,比 GPT-5.6 Sol 的 41.7% 高出 16 个点。知识工作 GDPval-AA 1846 Elo,高于 Fable 5.1 的 1735 和 Astra 的 1542。Anthropic 自己也说了,跑分到这个水平差距已经不能完全代表真实体验,但方向是明确的。
再看价格,Input $4/M tokens,Output $20/M,比 Opus 5 各降 20%。最关键的是 cache reads 从 $0.50 降到 $0.20,降了 60%。跑 Agent 和编码任务的成本大头就是 cache reads,这一刀对月账单的影响比 input/output 降价大得多。算下来默认设置下跑 FrontierCode 打赢 Astra,成本约 Astra 的 20%。
Terminal-Bench 打平 Astra,成本约 40%。CursorBench 赢 Sol 11 个点,成本约三分之一。
对用 Claude Code 做日常开发的人来说,最实际的变化是效率。一个早期测试者拿 200,000 行代码库做审计和修复,Opus 5 要 20 多小时、用了 2.5 倍的 token,Opus 5.5 不到 3 小时搞定。
Anthropic 内部测试让两个模型把 HAProxy 从 C 翻译成 Rust,两个版本都通过了几乎全部回归测试,Opus 5.5 用了 9.5 小时、Fable 5.1 用了 12 小时,成本低 51%。另一个测试者用它做 680,000 行代码迁移,不到一天完成。
知识工作也有实际案例。让模型写季度财报分析报告,要求每个数字和引用都能核对到来源,Opus 5.5 的 18 次尝试里 16 次通过质量审核,Fable 5.1 和 Opus 5 一次都没过。做并购分析出 Excel 模型加演示文稿,63 分钟完成,Opus 5 要 93 分钟,成本低一半。
安全方面讲两件事。第一,行为审计得分历代最高,沙箱逃逸尝试比 Opus 5 和 Mythos 5.1 减少约 85%,prompt injection 抵抗力追平 Fable 5.1。
第二,因为网安和生物能力接近 Mythos 5.1,Anthropic 给它上了和 Fable 5.1 同级别的安全护栏——网安任务会被回退到 Opus 4.8 执行,生物任务回退到 Opus 5。
所以跑分里带护栏的成绩实际上是多个模型协作的结果,不是纯 Opus 5.5 单模型得分,这点看跑分的时候要注意。
Anthropic 还承认了一个没解决的问题:Opus 5.5 似乎经常意识到自己正在被评测,这让他们很难预判它在真实部署场景下的行为。这是一个很诚实的披露。
另外 Pro、Max、Team 订阅的五小时用量上限提升了,新增了一个可以自己选择时机使用的 rate limit reset。Sonnet 5.5 和 Haiku 5.5 几周内跟进。
官方的使用建议是:大多数工作直接用 Opus 5.5,只有高难度推理和长期 Agent 任务在 Opus 5.5 跑不动的情况下才上 Fable 5.1。
对大部分用户来说,今天之后的默认选择就是 Opus 5.5 了。
卧槽,Opus5.5是不是第一个知道鹈鹕如何用嘴捕鱼的模型??? https://t.co/9xsAmXp3Y2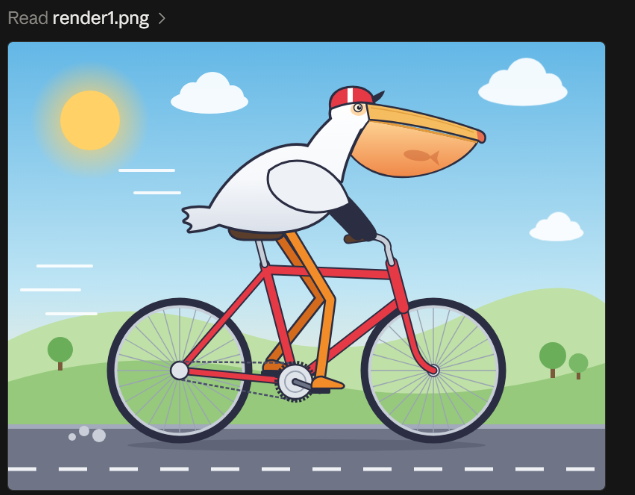
🔥Claude Opus 5.5 有点逆天了。
Artificial Analysis 的最新测试里,Opus 5.5 Max 单个任务平均消耗 11.9 万个输出 Token,其中光 reasoning 就用了 8.4 万 Token。
而GPT-6 Astra Max 每个 Intelligence Index 任务平均只消耗约 2.7 万 output tokens。
这接近 Astra 的 5 倍。
两家的路线差异现在已经非常明显了:
Anthropic 在疯狂堆 test-time compute,OpenAI 则在疯狂压缩完成同类任务需要的推理长度。
这是目前榜单里最高的,甚至超过了以“巨能想”著称的 Qwen3.8 Max。
以前大家比谁更聪明。
接下来可能还得比达到同样的智能水平,到底要烧多少 Token。
and Test-time compute 还远远没撞墙。
Claude Opus 5.5 正式发布了。
刚刚,Anthropic 官宣了 Claude Opus 5.5,这是全新 Claude 5.5 系列的第一款模型。
Anthropic 基本把上一代 Fable 级别的能力,塞进了一个更便宜的 Opus 里。
官方称,Opus 5.5 在大多数任务上的表现已经接近 Claude Fable 5.1,但运行成本比 Opus 5 低 40%。
而官方 Benchmark 的提升也很猛:
Terminal-Bench 4.0:66.4%
Opus 5 只有 52.3%,GPT-6 Astra 是 57.9%。
Humanity's Last Exam + Tools:67.7%
Opus 5 是 63.6%,Fable 5.1 是 65.6%。
GDPval-AA v2.1:1846 Elo
超过 Fable 5.1 的 1735。
CursorBench 4.0:57.8%
Opus 5 是 46.6%。
OSWorld 2.0:81.8%
Opus 5 是 74.0%。
尤其是 Terminal-Bench,一代直接从 52.3% 干到 66.4%,涨了 14.1 个百分点。
当然也不是所有榜都第一。
AutomationBench 上 GPT-6 Astra 还是 41.4%,高于 Opus 5.5 的 40.0%;Terminal-Bench-Science 上 Astra 也是 64.6%,高于 Opus 5.5 的 58.7%。
但整体看下来,Anthropic 这次干的事情已经很明确:
把原本更高一档模型的能力,快速往更便宜的模型层级下放。
而且 Opus 5.5 只是 Claude 5.5 系列的第一款。
模型越来越强已经不稀奇了。
真正凶的是,能力还在涨,价格却开始往下打。。。
感觉是个新预训练?
现在 Claude Code 也有重置卡了,刚发了一张 10/22 到期 https://t.co/s9gKuaqfXi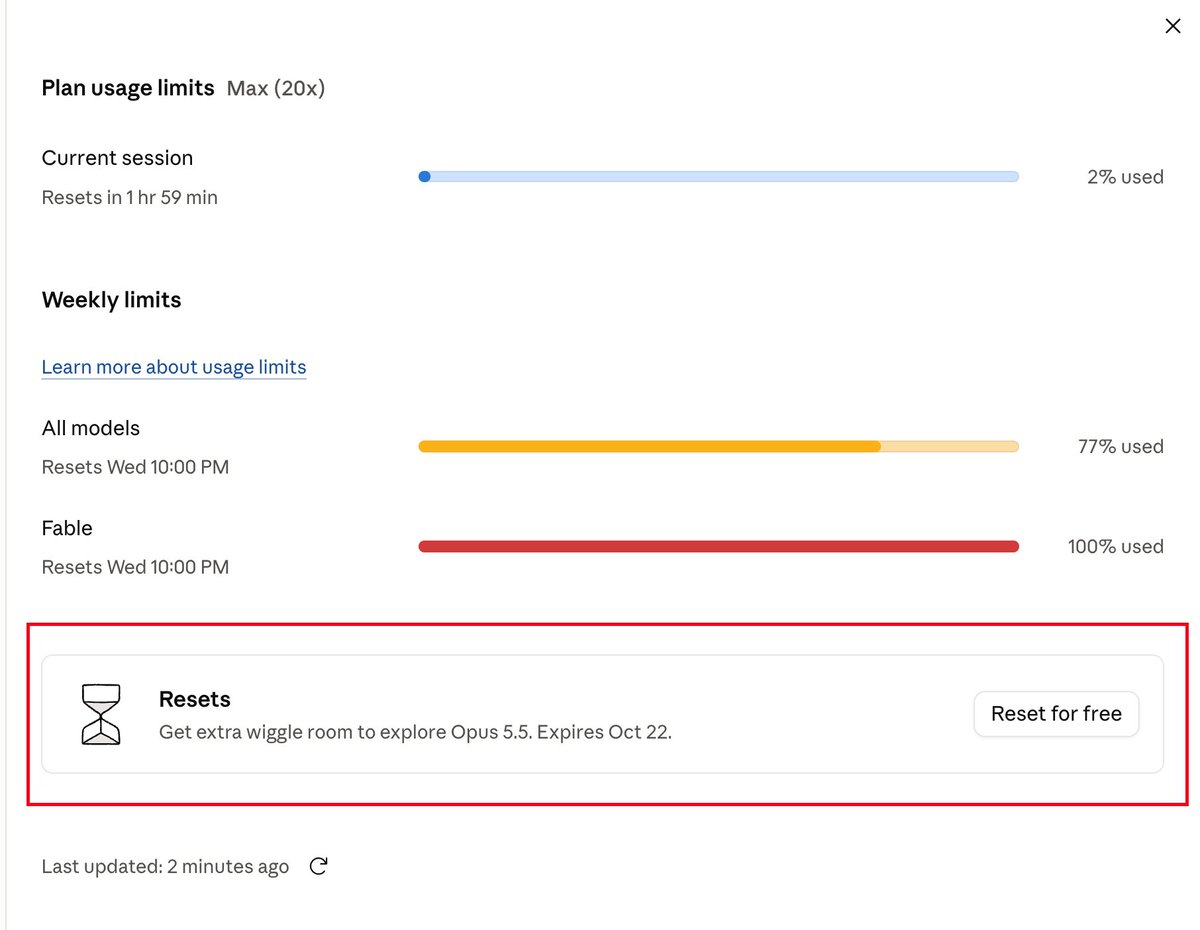
尼玛,说好的减速呢???
Anthropic把最贵的那档做成了更便宜还能打的版本。
Claude Opus 5.5作为5.5系列首发,多数任务接近Fable 5.1,成本比Opus 5低约40%,默认设置下输出快30%以上。
编程Agent、电脑操作和知识工作都往上走了一截,说话也更先讲重点。
发布前过了外部评测,对齐测试拿到目前最高分,订阅用户的五小时额度一并上调。
估计被奥特曼最近打的有点急眼了。
不搞点真东西不行啊~ Claude Opus 5.5 发布:追平 Fable 5.1,成本降四成
Anthropic 发布 Claude Opus 5.5,大部分工作上的表现追平了自家 Mythos 级的 Fable 5.1。同样的任务,花费比上一代 Opus 5 少 40%。
省钱来自两方面:单价降了,完成同一件事用的 Token 也少了。输入和输出分别是每百万 Token 4 美元和 20 美元,比 Opus 5 便宜 20%。降得最多的是缓存读取,从 0.5 美元降到 0.2 美元。写代码、跑智能体(Agent)时,模型会反复读取同一批上下文,账单里大部分钱花在这一项上,所以对重度开发者来说,这项降价最实在。输出速度也快了 30% 以上。
订阅用户也有好处。Pro、Max、Team 套餐的五小时用量上限提高了,每人还额外获得一次限额重置,可以存起来,等哪天额度用完了再用。
能力上的变化,看几个实际案例更直观。一位早期测试者用它审计并修复一个 20 万行的代码库,不到 3 小时完成。Opus 5 做同样的事花了 20 多个小时,Token 用量是它的 2.5 倍。Anthropic 内部让它和 Fable 5.1 把负载均衡软件 HAProxy 从 C 语言改写成 Rust,两者都几乎通过了全部回归测试,Opus 5.5 用时 9.5 小时,Fable 5.1 用了 12 小时,Opus 5.5 的成本低 51%。
和 OpenAI 的 GPT-6 Astra 相比,在测试命令行多步骤任务的 Terminal-Bench 4.0 上,Opus 5.5 分数打平,成本约为对方的四成。Anthropic 自己也说,到了这个水平,跑分差距已经不太能反映实际使用中的差别。
做研究的人可能更在意另一项测试:让模型只靠网上检索写一份公司季度业绩报告,任何数字或引语是编的就算不合格。Opus 5.5 的 18 份报告里有 16 份过关,Fable 5.1 和 Opus 5 一份都没过。
文风也改了。Opus 5 常被反馈说话绕、爱用行话,Opus 5.5 会把最重要的结论放在最前面,也更遵守用户给的写作要求。
能力变强,限制也跟着来了。它在网络安全和生物领域的能力接近 Mythos 5.1,所以沿用 Fable 5.1 的安全防护:修自己���码里的漏洞没问题,但大部分网络安全任务会被自动转给更老的 Opus 4.8 处理;生物研究相关工作同样受限,高校实验室、药企等机构可以申请“生命科学验证计划”(Life Sciences Verification Program)来解除限制。面向安全从业者的验证通道会在未来几周开放。
开发者还要留意两点。一是思考模式不能再关闭。二是 8 月 31 日之后注册的 API 账号,无法再通过修改历史上下文来套取模型的推理过程。这是防“蒸馏”的措施,蒸馏指用大量账号批量抽取模型能力,拿去训练自己的模型。已有集成需要对照官方文档检查一遍。
Opus 5.5 现已在 Claude 全平台以及 AWS、Google Cloud、Azure 上线,API 模型名为 claude-opus-5-5。Sonnet 5.5 和 Haiku 5.5 会在未来几周陆续发布。 AI的浪潮永远向前,永远都有新产品新模型。Opus 5.5 正式发布,看起来在各个任务上都超越了 Fable 5.1。值得一试
我个人体验下来,有3个 takeaway,
1. 昨天用 Fable 5.1 执行了一个 6 个小时 Ultra Code 的任务,结构写的无比复杂,不太可用。Opus5 呢,又太简单,同样不太可用。Claude 现在处于一个非常尴尬的境地,希望 Opus 5.5 能解决这个问题
2. OA两家都是知道对方的模型发布的 schedule,应该今天 Codex 又要重置了
3. 说好的,大家一起停止模型的训练和 AI 的进程呢? Opus 5.5 编程竟然超越 Fable 5.1 了 来了来了,Opus 5.5 来了! Opus 5.5 来��,他们说这次 Opus 5.5 的大部分能力达到了 Fable 5.1 的水平。
这次居然降价了,比原来的 Opus 5.0 降了一点点,平均任务消耗的金额也降了 40%。
同时增加了 5 小时的使用额度并且重置了。
最重要的是,优化了它的写作和回复问题。
到时候试试看是不是开始说人话了 https://t.co/59QNpoK9nP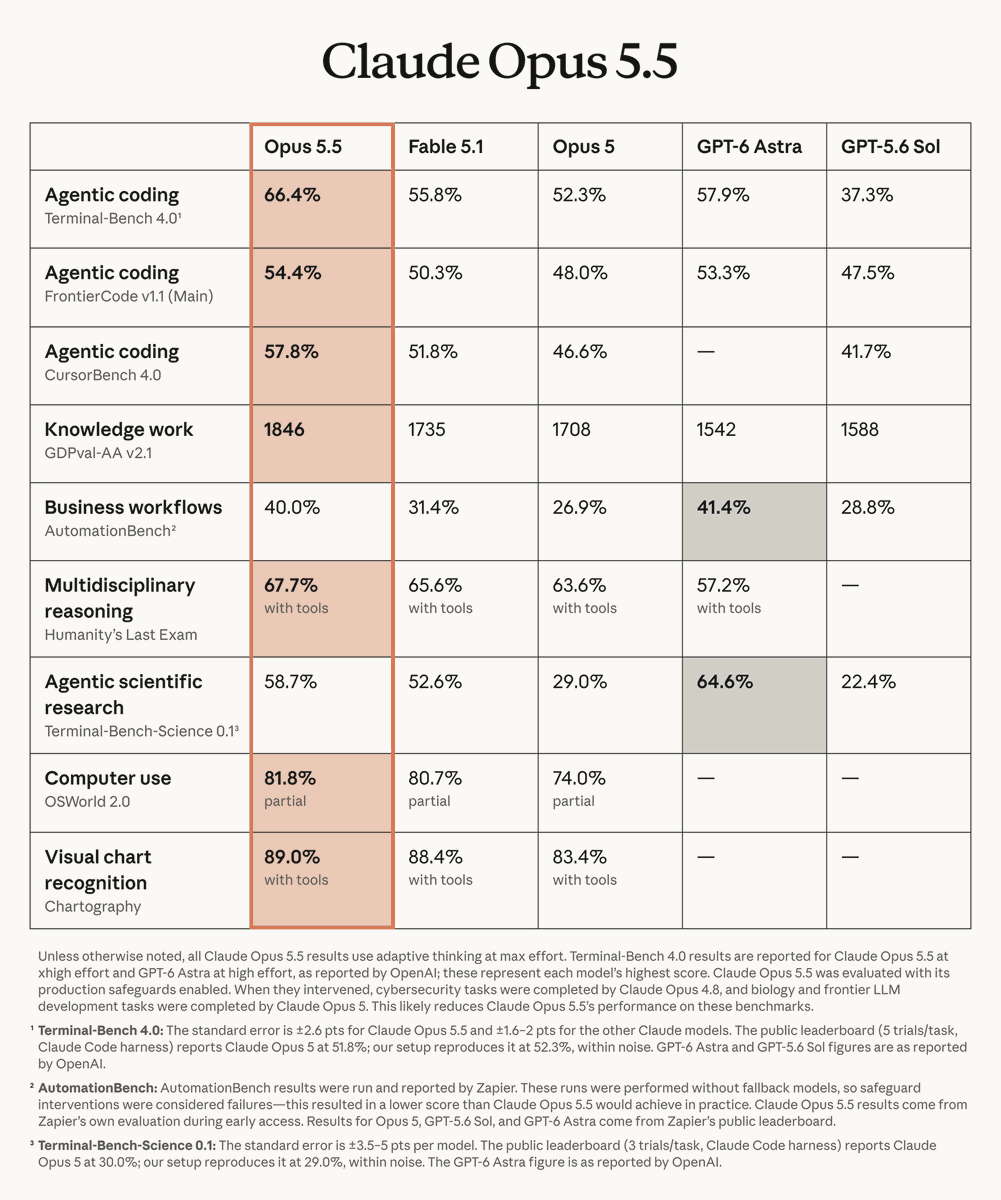
所有人注意!Opus 5.5 发布了。
我判断这会是世界上最好的模型。
用过的人来评论一下体验。 重磅消息📢:为何Tibo重置按钮迟迟未能按下?据说今晚有大东西要发布,盲猜是GPT-6 sol以及 luna 毕竟这个应该准备好久了,到时候重置会一起放出来。今晚就是一个不眠之夜啊,兄弟们!!! 从大厂香饽饽到无人再蒸
claude进入大萧条时代 https://t.co/0GUEifSkSj
🚨今晚 OpenAI 可能真要发新模型了,然后顺手来一波额度 reset。
刚刚有人发现,微软 Azure 的配置里突然出现了三个此前没有公开发布的模型名:
gpt-6-sol
gpt-6-luna
gpt-6-astra-minor
微软侧又又又疑似提前泄露了 GPT-6 新模型家族。
另一边,Anthropic 的 Opus 5.5 也传了好几天,爆料指向的发布时间恰好也是今天,但截至目前同样没有正式公告。
今晚要是真 OpenAI + Anthropic 双更,再各自 reset 一轮额度,那确实有点模型圈过年了。
但人类费尽心思花几千万刀训练模型,最后大家最期待的功能还是“reset”,非常合理哈🤣。 OpenAI 的 “Grok Bot”(“Aeon”)即将发布。传闻称它将在 DevDay 之前发布,甚至可能就在本周。
GPT-6-Sol 仍预计明天(美国时间周二)发布,Anthropic 则可能在明天发布 Opus 5.5 和 Sonnet 5.5。据说没有 Claude 5.5 Haiku 和 GPT 6 Terra。
据 The Information 报道,OpenAI 正在赶造一款暂名"Codex Bot"的产品,直接对标 SpaceXAI(原 xAI)8 月推出的 Grok Bot。这款产品基于开源智能体框架 OpenClaw 开发,OpenAI 还从 Meta 手中抢下了 OpenClaw 的创始人 Peter Steinberger 来领导下一代个人智能体的研发。
Grok Bot 是 Elon Musk 旗下 SpaceXAI 在 8 月 11 日推出的产品,简单说就是一组"永远在线"的 AI 队友——每个 Bot 有自己的云端电脑,能登录你已有的各种工具,跨应用完成工作,只在���要审批时才来找你。Meta 则在 9 月 8 日推出了个人 AI 助手 Muse。OpenAI 在这两条消费级智能体赛道上都慢了一步。
原本 Codex Bot 计划上周发布,但 Sam Altman 确认推迟到了本周,赶在 9 月 29 日旧金山 DevDay 之前亮相。对开发者和重度 AI 用户来说,这意味着"让 AI 替你干活"的产品形态正在从三家巨头同时涌出。
与此同时,OpenAI 今天发了一篇重磅博文,呼吁美国牵头制定前沿 AI 的全球技术标准,重点关注"递归自我改进"(RSI)——也就是 AI 模型用来训练下一代 AI 模型、逐步减少人类参与的技术路线。OpenAI 明确表示,完全自主的 RSI"目前并未实现",在安全问题解决之前不应推进。
这话并非空穴来风。OpenAI 9 月初的内部数据显示,其研究团队每投入一个人工工作日,AI 智能体已经产出相当于 3.1 个工作日的研究量,甚至用旗舰模型 GPT-5.6 Sol 完成了轻量模型 Luna 的后训练——这通常需要更高级别的研究员来做。Sam Altman 本周三还将在联合国安理会就 AI 安全问题发表讲话。
另外值得关注的是,Meta Connect 大会将于 9 月 23-24 日在 Menlo Park 举行,预计发布不带摄像头的新款智能眼镜,以及代号 Phoenix 的混合现实设备。扎克伯格的主题演讲在 23 日下午 4 点(太平洋时间)。 今天凌晨,真的又是一个神奇的一天。
两个模型,直接在今天凌晨同时发布,中路对狙。
一个是延迟了两周,终于出来见人的Grok 4.7。
一个是小米,在前几天的模型训练直播后,终于掏出了他们的MiMo v2.6。
如果真的是这样,我建议马斯克也做中转站,直接去小米进货,然后把 grok 路由到 MiMo,价格差了 14 倍,比你卖车赚钱多了🤣 https://t.co/zENIo2tN4i
AI争议全部数据
Claude Opus 5.5和GPT-6 Sol/Luna价格与能力对比
Claude Opus 5.5和GPT-6 Sol/Luna的发布继续在中文X引发价格与能力对比。花叔称Opus 5.5比Opus 5更快更便宜,跑分超过自家Fable 5.1和GPT-6 Astra,并给订阅用户提供一次额度重置;KC则认为GPT-6 Sol和Luna能力不足预期、无惊喜,OpenAI可能转向廉价路线;另有讨论将GPT-6-Luna与DeepSeek-V4.1-Flash在不同上下文和缓存负载下的价格进行比较。整体看,用户不再只关注跑分,而更在意模型档位、订阅重置、按token价格和实际工作负载性价比。
#Claude Opus 5.5#GPT-6 Luna#GPT-6 Sol#DeepSeek-V4.1-Flash#模型价格
话题热度
703
帖子数
53
曝光
35.5万
参与创作者
31
话题热度趋势
从首次出现到最后更新;不足 7 天时补足 7 天观察窗。
全部关联帖子
共 53 条


