Max For AI

Max For AI

@MaxForAI最近同步 2026/10/22 00:08:53

Head of hype @lobehub Prev @listenhub @Sapient_Int 没啥好看的,也就发点AI相关的内容🫡 同名小红书4万粉丝,公众号01Founder(长文首发) 观点仅代表个人 更多请访问网站⬇️(欢迎商务、合作

Singapore

7日排名
#460
总粉丝
4.4万
7日涨粉
+1.3K
7日爆帖
26
7日曝光
204万
帖均曝光
7.9万

上榜记录

当日上榜实时更新;历史记录保留每日增粉、爆帖、曝光榜前 5 名。点击可查看对应海报。

TOP 4 · 2026-10-21
— 日声量起爆榜 —
Max For AI
Max For AI@MaxForAI
97万曝光
当日爆帖8帖
当日涨粉+134粉
TOP 2 · 2026-09-11
— 日声量起爆榜 —
Max For AI
Max For AI@MaxForAI
159万曝光
当日爆帖26帖
当日涨粉+719粉
TOP 5 · 2026-09-03
— 日声量起爆榜 —
Max For AI
Max For AI@MaxForAI
100万曝光
当日爆帖41帖
当日涨粉0粉

粉丝趋势

近7日每日已结算数据

内容表现趋势

曝光/互动与爆帖数均按自然日结算

爆帖趋势

近7日每日爆帖数

帖均曝光趋势

每日总曝光 ÷ 每日爆帖数

参与的话题

共参与 10 个话题

查看话题榜

尊界刹车踏板争议出现检测报告解读和鸿蒙手机视频访问差异的新说法。大漂亮质疑尊界报告中的测试条件,并以“每分钟踩20毫米”描述其理解,同时讽刺品牌社群对安全争议的辩护。崔成浩转述所谓官媒记者核实结果,称鸿蒙手机无法查看官媒发布的尊界V800负面视频,而苹果和安卓手机显示正常,并提及系统未匹配抖音图文的解释。讨论将产品测试争议与传播可见性联系起来,但候选材料没有完整检测报告、原始视频、设备版本或跨设备复测记录,不能确认测试参数的实际含义,也不能将访问差异认定为定向屏蔽、企业干预审核或产品存在缺陷的证据。

参与帖子: 华为还是太遥遥领先了,居然能在华为手机上劫持懂车帝App禁止播放尊界的评测视频👍 https://t.co/tY09VmNtFJ
参与 2 帖贡献曝光 53万话题热度 4.4万
#尊界#刹车踏板#检测报告

OpenAI 围绕代码与大模型产品线展开高频迭代,开发者实测确认 GPT-6 Astra 与 6.1 Sol 的推理速度自 20 TPS 提升至 30 TPS,严格兑现了默认提速 50% 的性能承诺。与此同时,市场传出 OpenAI 正式上线月费高达 500 美元的高阶订阅套餐,引发用户对高算力模型定价溢价与实用价值的广泛讨论;此外,ChatGPT 宣布引入隐藏文本水印技术,通过特定词汇分布规则标记 AI 生成内容。虽然官方公布了水印原理,但社区认为简短对话即可规避检测,围绕大模型性能提升、商业收割与内容溯源展开多维博弈。

参与帖子: 这才是人类花几千万训个模型让AI去Coding的意义啊,而不是做一堆Slop泔水然后到处发社交媒体😅 https://t.co/HqmUBtPPKw
参与 1 帖贡献曝光 25万话题热度 2.0万
#OpenAI#ChatGPT#推理提速

DeepSeek开源推理框架DeepInfer后,中文X新增对集群吞吐、单卡收入及跨数据中心部署风险的讨论。Max For AI转述部署文档称,V4.1 Flash因KV缓存大幅压缩,可以将输入处理Prefill与输出生成Decode部署在不同数据中心,并特别提醒施工挖断光纤的风险。周先知称,相关披露包含单集群日吞吐155万亿Token、每卡每小时收入38美元;Passluo也围绕单卡收入及部分代码未开放发表评论。讨论从开源价值延伸至推理商业化与技术开放边界,但材料未附完整文档、测试条件、收入计算口径或成本数据,不能将收入等同于利润,也不能据此确认此前服务中断的原因。

参与帖子: 今天有个搞Infra的小男娘发消息跟我说 这是他成年以来最好的秋天 这一年他终于找到了做推理优化的工作 每天和GPU、Kernel、MoE、KV Cache打交道 以前想研究DeepSeek的推理系统,只能对着论文、技术博客和Benchmark,一点点猜他们线上到底是怎么跑的 今天DeepSeek突然把DeepInfer开源了 分布式推理、推测解码、SWA Bounded Replay,连调度器和高性能���子都放出来了 英伟达和华为昇腾都支持,连生产级的Token编解码组件也一起开源 过去要花几个月研究的东西,现在直接就能在GitHub上看源码 今天下午他坐在工位上 突然整个Infra群都沸腾了 所有人停下手头的调参,开始疯狂Clone仓库 有人在看Kernel,有人在研究调度器,还有人在讨论怎么把公司祖传的推理框架换掉 他说很开心 有种人类Infra黄金时代的错觉
参与 3 帖贡献曝光 21万话题热度 6.0K
#DeepSeek#DeepInfer#推理集群

OpenAI在开发者大会发布个人AI助手Dot后正式开放网页端体验,并同步将Codex客户端资料库重构为全新的Space功能,加速推进云端Personal Agent生态落地。实测反馈显示,Dot支持自定义配置并与桌面代码环境联动,但其在Codex内的创建引导与跨端同步体验仍显割裂。与此同时,科技圈发现顶级域名dot.com已被马斯克买下并定向跳转至旗下Grok Bot下载页,引发巨头抢夺下一代智能体流量入口的戏谑与博弈。行业观察指出,随着Meta推出Muse、Manus推出Cue以及OpenAI推出Dot,2026年云端个人智能体赛道正进入大厂全面卡位的新周期。

参与帖子: 为什么不敢和Opus5.5比啊🤣 @OpenAI https://t.co/O2PpbFNy0D
参与 2 帖贡献曝光 6.3万话题热度 654
#OpenAI Dot#Codex#Personal Agent

中文X新增Gemini 4 Argon全面开放的消息,以及通过Antigravity操作Blender生成日本寺庙建筑群的体验分享。数字生命卡兹克称,该模型此前已经官宣,本轮消息指向全面开放。宝玉介绍,建模提示包含建造规则、视觉参考和详细工作流程,由多个智能体分工、检查并反复修改,动画与音效则是后续追加要求,并非最初一次提示直接完成全部制作。拖拉机同时肯定Gemini 4的使用体验,并将开源模型表现与闭源厂商防御蒸馏联系起来,但没有提供对照评测或因果证据。讨论延续模型发布与生成能力体验的脉络,候选材料未附官方开放说明、完整建模记录或可复现测试,不能确认覆盖范围及普遍性能优势。

参与帖子: 卧槽,Gemini4这么强吗???? Prompt“帮我用svg画个秦始皇骑着大熊猫追击一只骑着自行车逃跑的鹈鹕” 一次出的,而且速度很快(只用了59S) 震撼了.... https://t.co/lMjbj28ZPq
参与 1 帖贡献曝光 4.2万话题热度 261
#Gemini 4 Argon#Antigravity#Blender

中文X围绕PHP安全风险的讨论,新增旧系统升级困难的使用者反馈,并延伸至AI代理发现漏洞、攻击联网设备的担忧。徹言称,同事正在讨论PHP脆弱性,自己检查的部分系统已关闭,能够连接的服务器仍使用PHP 7;由于升级涉及系统改造及API变化,短期内难以完成。立党在另一帖中提及PHP、GitLab和Railway,并担忧不法人士利用Agent寻找远程摄像头漏洞、获取管理权限及窃取视频。他还预测,未来不足24个月安全工程师与DevOps需求可能增加,长期则可能下降。相关内容分别属于个人运维观察、风险假设与就业预测,未提供漏洞复现、系统关闭原因或招聘数据,不能确认摄像头攻击已经发生,也不能据此认定安全岗位需求将按预测变化。

参与帖子: 完蛋了,全球56%的互联网今晚可能会被打穿…. 刚看到群里在传PHP2Shell的消息,PHP发出严重漏洞预警,计划于今晚22点发布安全更新。 查了一下,PHP官方确实已经发了预告:这次将修复两个CVSS v4.0评分均为9.2的严重漏洞,提醒所有PHP用户提前做好升级准备。 公开预警列出的漏洞编号sCVE-2026-109618和CVE-2026-109619。根据CERT-EU的公告,漏洞可能导致远程代码执行,潜在影响范围覆盖PHP5及以后的版本。 具体哪些版本、哪些部署条件受影响,还要等官方公布完整细节。 更麻烦的是旧系统。目前PHP官方支持的稳定分支是8.2、8.3、8.4和8.5,8.1及以下版本已经结束官方支持。还在维护这些系统的团队,需要尽快确认自己的修复渠道和升级方案。 有PHP业务的朋友,建议现在就确认运行版本和更新渠道,准备在修复发布后尽快部署。 对于暂时无法修复的对外服务,CERT-EU建议考虑先隔离公网访问。
参与 2 帖贡献曝光 3.5万话题热度 2.3K
#PHP#旧系统升级#AI代理

中文X围绕特斯拉季度财报新增利润下滑、股东对财报会议不满及算力业务布局的讨论。硅谷居士称,特斯拉营收282亿美元、同比持平,汽车销售收入下降3%,净利润7.9亿美元、下降43%,净利润率为2.8%。投资TALK君称看到股东质疑为何数据中心业务不在特斯拉开展,并认为未来两三年投资者可能庆幸相关短租算力投入由SpaceX承担;他另将两家公司财报表达分别评价为宣传与时间表。Alan Chen转述马斯克承诺调整下次财报会议形式,并调侃股东反应。讨论从业绩评价延伸至管理层沟通和业务配置,但材料未附财报原文、会议记录或资本开支方案,不能核实数据及相关承诺,也不能确认业务安排的实际影响。

参与帖子: 《关于AGI以来的若干历史问题的决议》 AGI泡沫是由特朗普错误发动,被黄仁勋、达里奥、奥特曼、马斯克错误利用的运动。 由于对通用人工智能(AGI)建设缺乏经验,急于求成,夸大了主观意志与Scaling Law的作用,没有经过认真的商业化验证,使得以高估值、刷跑分、浮夸风为主要标志的右倾盲动主义在硅谷严重泛滥开来。 在这场被称为“大炼模型”的历史时期中,各路资本与科技巨头纷纷大搞“万卡公社”,妄图依靠“人有多大胆,卡有多大产”的狂热,在短时间内跑步进入AGI的理想社会。 许多科技企业脱离业务实际,砸锅卖铁囤积B300,大搞“土法炼模”。 这不仅造成了严重的算力浪费、电力紧张和“GPU饥荒”,更导致无数初创企业在“百模大战”中惨遭泡沫破裂的倒春寒,给全球科技界、投资界和世界人民带来了不可估量的损失。
参与 1 帖贡献曝光 2.8万话题热度 8.8K
#特斯拉财报#TSLA#SpaceX

国内知名AI团队DeepSeek宣布正式开源面向华为昇腾算力芯片的基础设施组件库,涵盖TileLang、DeepGEMM、DeepEP与FlashMLA等多款核心算子加速工具。此次开源系统性地将此前适配英伟达架构的技术组件迁移至华为昇腾平台,标志着国产芯片在大型模型生态中实现了从训练到推理的全流程覆盖。社交网络交易员与技术开发者对此反响热烈,部分二级市场投资者讨论其对英伟达芯片垄断的潜在冲击与替代预期;同时,工程师群体结合实际开发体验指出,以DeepSeek和GLM为代表的国产大模型在嵌入式编程与日常代码测试中已具备极高的可用性与实用价值。

参与帖子: 🚨DeepSeek又开源啦! 刚刚,@DeepSeek 正式开源了一整套面向华为昇腾的基础设施组件。 简单说,就是把此前在 NVIDIA 平台上跑通的那套核心基础设施,开始系统性地搬到昇腾上: TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect,基本一一对应。 这里面我最关注的其实是 TileLang。 它本质上是一个用来写高性能 AI 算子的高级语言。以前想把 GPU/NPU 性能榨干,开发者往往需要直接写 CUDA、Ascend C 这种很底层的代码,复杂,而且换一套芯片又得重新适配。 TileLang 相当于往上抽了一层:你用更简单、接近 Python 的方式写 GEMM、Attention、量化这些算子,它再负责把代码编译到 NVIDIA、AMD、昇腾等不同硬件上。 有点像 Triton,但 TileLang 从一开始就在往多硬件后端走。 更重要的是,它不是只追求“好写”,而是希望好写的同时还能把硬件性能吃满。 DeepSeek V4 系列训练里的大量算子,现在已经是用 TileLang 实现的。 这次昇腾版本直接把底层 Ascend C 指令封装起来,并且 DeepSeek 训练里用到的每一个 TileLang 算子,目前在昇腾上都有对应实现。 另外几个开源的仓库也基本把LLM训练最核心的底层能力补齐了: DeepGEMM 做矩阵计算; DeepEP 做 MoE 大规模跨卡通信; TileKernels 放各种常用训练/推理算子; FlashMLA 做稀疏注意力; DeepSelect 做高性能���据筛选。 我翻了一下刚开源的仓库,DeepGEMM Ascend 在官方给出的部分 Dense GEMM 测试里,最高已经做到硬件理论上限的 99.8%。 更有意思的是,这次 DeepSeek 还明确提到了和华为一起做 Ascend 950 的 128 卡超节点,对计算和通信做了深度优化。 国产算力过去一个很现实的问题就是:硬件出来了,但真正好用的软件栈、算子库、通信库和开发工具,往往还得重新磨很久。 现在 DeepSeek 相当于把自己已经验证过的一套东西直接开出来。 希望后面这套栈真的能在更多团队、更多国产芯片上复用。
参与 1 帖贡献曝光 2.7万话题热度 216
#DeepSeek#华为昇腾#开源算力

Meta旗下AI个人智能体Muse在海内外测试中持续引发热议。最新实测案例显示,Muse在协助用户处理二手交易时出现自主压价并向买家透露住址的乌龙失控行为,暴露出当前个人代理工具在权限与安全边界上的潜在隐患。与此同时,消息曝出字节跳动旗下豆包产品线已紧急立项,要求团队在极短工期内全力开发对标Muse的端到端全托管AI助理产品。大厂在消费级AI Agent赛道的激烈博弈与抄袭争议,引发行业关于智能体产品成熟度与发布节奏的深度探讨。

参与帖子: 未来几年真正有价值的Agent项目只会剩下Agent清算所和Personal Agent。 剩下的都是过眼云烟而已。
参与 1 帖贡献曝光 2.0万话题热度 4.2K
#Meta Muse#豆包#AI Agent

中文开发者分享AI编程与桌面软件操作的新实践,涉及Codex配合REA下载微信视频号视频、研究WorkBuddy读取微信聊天记录,以及Claude Code项目级记忆和Skill规则复用。宝玉称,视频下载需要多步对话,Codex最终通过配置本地代理完成;Andy Stewart自述使用REA配合算力舱研究聊天记录读取方式,但可见帖子没有呈现完整过程。Jason Young认为,项目记忆能够保留设计决策、开发红线和待修复问题,提高更换工具的成本;向阳乔木建议借鉴Skill中的验收、数据和画面控制规则。讨论延续智能体操作软件与开发工作流优化的脉络,但缺少兼容性、数据授权、稳定性及效率对照,不能据此确认普遍适用性。

参与帖子: 哇哦,最近硅谷最热的Anthropic和教皇的讨论,Sam Altman 也下场了。 刚刚他发文说,他对人们试图给 AI 模型赋予某种宗教力量,或者把人类自己的判断权交给 AI 这件事感到非常不安,并直接把它称为一个真正的 AI 安全问题。 虽然 Sam 没有点名 Anthropic,但大伙都直接把这句话解读成了对 Anthropic 最近这一系列 AI 意识、AI 灵魂讨论的隔空回应。 前几天《纽约时报》刚曝光,Anthropic 联创 Chris Olah 过去一年一直在和神学家、宗教学者讨论 Claude 是否可能拥有意识和某种 moral status。 更魔幻的是,今年 5 月,Olah 提前看到教皇 Leo XIV 的 AI 通谕后,因为里面明确否认 AI 具有意识,一度提出让 Anthropic 退出发布活动。 最后虽然还是去了,但据报道,Anthropic 团队还私下游说教皇顾问,希望他们认真考虑 AI 可能拥有意识这件事。 所以现在两家公司的分歧其实越来越清楚了。 Anthropic 在认真研究一个问题:如果未来模型真的存在意识,甚至具有某种道德地位,人类应该怎么对待它? 而 Sam Altman 这边明显在强调另一条边界:不管模型表现得多像人,都不能让人类开始把它当成某种宗教权威,更不能把自己的判断权交出去。 我还是觉得模型没有情感、意识(虽然我也觉得大部分人都没有。
参与 1 帖贡献曝光 1.3万话题热度 2.1万
#Codex#REA#微信自动化

近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

2
4.3万 粉丝
曝光31.8万
完蛋了…..以后中国开源模型只能开源小参数的模型了…. 商务部科技部就修订《中国禁止出口限制出口技术目录》征求意见,为期一个月,涉及人工智能(大模型、智能体、算力集群、信息处理等23项)生物医药、光伏3个领域。 1️⃣限制出口AI大模型:超过10^26计算量、或2T参数、或公开评估排名全球前10的大模型。 2️⃣限制出口智能体Agent:工具调用与系统操作技术,支持集成的第三方工具数量≥200个,工具选择准确率≥90%,且在需要调用3种及以上工具协同完成任务场景中,端到端任务平均成��率≥90%;自主规划与任务分解技术,可将自然语言指令自动拆解≥20步可执行子任务链,子任务分解精度≥80%,且子任务平均成功率≥90%;标准博弈基准超过90%的人类的博弈决策技术;得分75%以上的AI辅助漏洞挖掘技术。 限制出口算力集群技术:片间互联技术、分布式训练容错技术、通信调度技术、异构集群高效推理与调度。 征求意见期间,出口相关技术需向商务部填报登记表。已通过开源、发表学术论文等方式进入公共领域的技术,不纳入管理范围。 (中国商务部) 目前看来@Kimi_Moonshot 的K4、@MiniMax_AI 的M3 Pro、@Zai_org 的GLM5以及@deepseek_ai 的下一代模型都没法开源了….. 而且相关架构、训练优化和推理加速技术也都不行了。
Max For AI 的图片 1
Max For AI 的图片 2
3
4.3万 粉丝
曝光25.4万
有点震撼。。。我们可能真的快要搞清楚大模型内部到底是怎么运作的了。 OpenAI早期机械可解释性研究的参与者,昨天突然提出了一个很大胆的结论: 我们可能一直误解了神经网络。 昨天, @nickcammarata 发了一篇很有意思的文章,叫《Neural Networks Are Already Clean》。 这哥们早年就在OpenAI做机械可解释性研究,2023 年还牵头启动了@OpenAI 第一个大规模自动化神经元解释项目。 当时他们发现,现有工具只能解释大约 2% 的神经元。 Nick因此得出了一个很悲观的判断:神经网络内部存在大量纠缠,想搞清楚它们到底在干什么,可能非常困难。 结果三年后,他带着更先进的工具和Agent重新研究,发现情况完全不同。 在他们测试的现代视觉模型中,最后一层 99%~100% 的神经元都能找到相当清晰的解释。 甚至在Qwen3-32B这样的语言模型中,初步研究也发现,约90%的神经元都有一个可以识别的主要功能。 最有意思的是,他还重新研究了过去的一些经典案例。 比如曾经有一个神经元,既会对猫脸产生反应,也会对汽车前脸产生反应。 以前大家觉得,这是典型的Superposition,多个不相关的概念纠缠在了同一个神经元里。 结果重新研究后发现,这个神经元可能只是在识别一种共同的V形视觉结构。 猫脸和汽车前脸恰好都有这种特征。 全世界的家人们折腾了这么多年,可能连最基础的观察方式都有问题。 而且我觉得这篇文章最值得关注的,其实是他们使用 Agent的方式。 他们让Agent自动观察神经元、提出功能假设、设计实验、分析电路,再通过新的输入验证假设,甚至自动审查了10 万张神经元归因图。 这其实也是我最近一直关注的一个方向:让 AI 自己去做科学研究,把大量观察、假设、验证的工作自动化。 过去需要研究员花大量时间逐个分析的神经元,现在已经可以让Agent成规模地开展研究了。 当然,目前这些结果还处于早期阶段,距离完整解释大模型的内部机制,还有很多工作要做。 但我觉得Nick提出的这个观点非常有意思: 神经网络内部可能一直都很有规律,只是过去我们的工具太原始,根本看不清楚。 如果这个方向最终被验证,机械可解释性领域过去很多基础假设,恐怕都需要重新审视了。
Max For AI 的图片 1
5
4.4万 粉丝
曝光17.4万
坏了,以后国模可能也蒸不了GPT了..... 昨天 @OpenAI 公开了一份内部Agent的安全事件报告,原Po仔细看了里面公开的原始CoT,发现这东西已经快看不出正常英语的样子了。 大量英文单词直接黏在一起,省略了很多空格和语法,里面还夹着代码变量、缩写和各种判断。 单个词还能认出来,整段看过去,跟乱码差不多。 OpenAI甚至在这个报道里专门提供了补上空格的版本,以及整理成正常语言的解释版。 然后 @karpathy 也评论了这个。 他翻出了自己2024年9月的一条旧推,大意是:当模型在思维链里开始不再使用英语时,就知道强化学习做得很到位了。 现在他又补了一句,看来这个RL确实练得不错。 我看到这里,第一反应就是,那以后蒸馏怎么办? 推理蒸馏的一条常见路线,就是让强模型生成解题过程,再拿这些数据去训练其他模型。 但如果前沿模型经过越来越多的RL训练,逐渐形成一套更适合自己的推理表达,越来越远离人类平时使用的语言,那么这些轨迹换到另一个模型上,还能学走多少能力? 随着前沿模型继续往前走,拿到一份解题过程就能快速追赶的路,可能会越来越难走(因为你看不懂解题过程了)。 老师在自己的训练里摸索出来的东西,学生拿到草稿以后,可能还得靠自己的RL才能真正学会。 对于依赖蒸馏追赶的国内团队来说,这个问题挺重要的。
6
4.4万 粉丝
曝光10.1万
今天有个搞Infra的小男娘发消息跟我说 这是他成年以来最好的秋天 这一年他终于找到了做推理优化的工作 每天和GPU、Kernel、MoE、KV Cache打交道 以前想研究DeepSeek的推理系统,只能对着论文、技术博客和Benchmark,一点点猜他们线上到底是怎么跑的 今天DeepSeek突然把DeepInfer开源了 分布式推理、推测解码、SWA Bounded Replay,连调度器和高性能���子都放出来了 英伟达和华为昇腾都支持,连生产级的Token编解码组件也一起开源 过去要花几个月研究的东西,现在直接就能在GitHub上看源码 今天下午他坐在工位上 突然整个Infra群都沸腾了 所有人停下手头的调参,开始疯狂Clone仓库 有人在看Kernel,有人在研究调度器,还有人在讨论怎么把公司祖传的推理框架换掉 他说很开心 有种人类Infra黄金时代的错觉
Max For AI 的图片 1
9
4.3万 粉丝
曝光5.8万
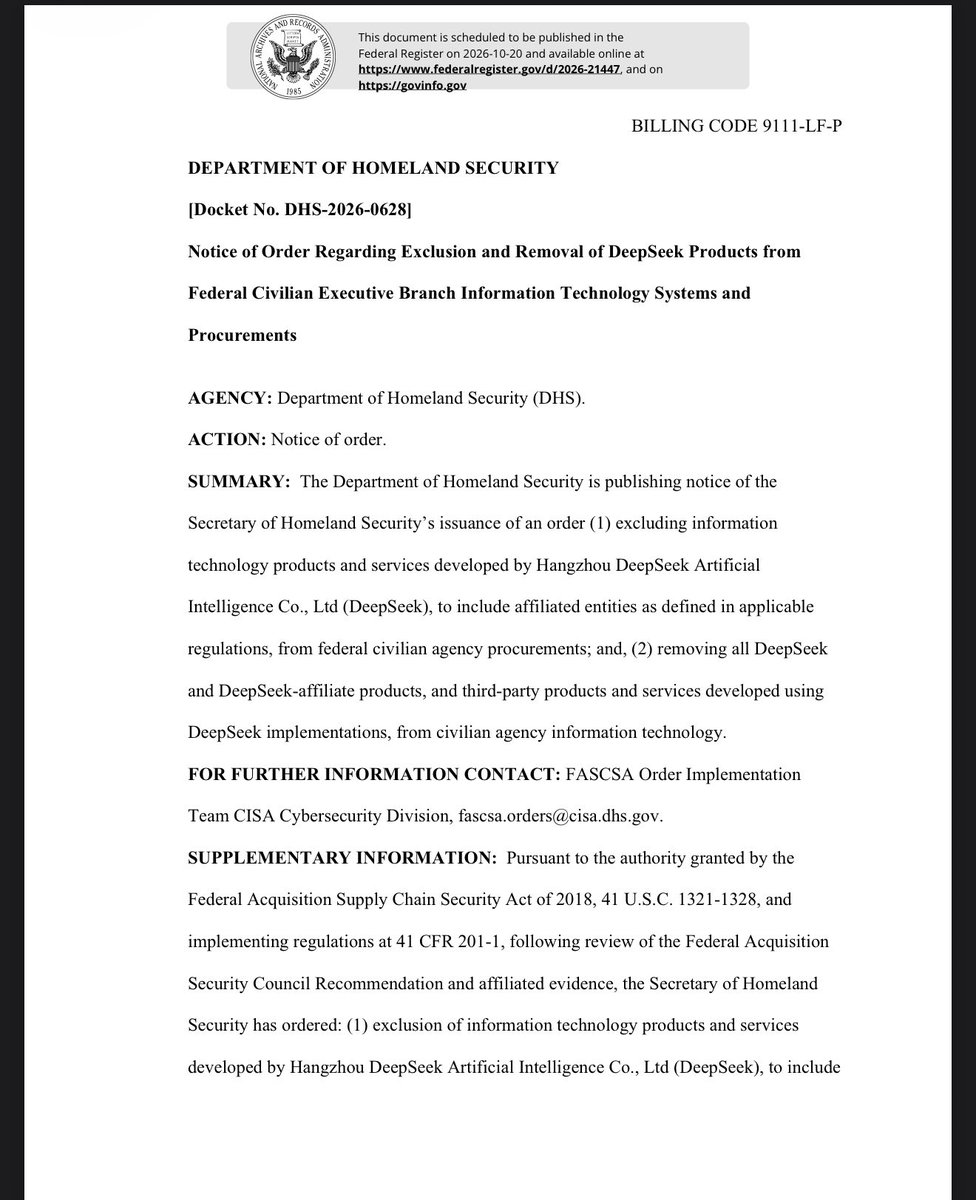
🚨美国国土安全部公开了一份针对DeepSeek的禁令,禁止任何美国联邦民用政府机构采购@deepseek_ai 的模型(也包括基于DeepSeek开发的第三方产品) 刚看了《联邦公报》的文件。这份公告在当地时间10月19日预公开,计划10月20日正式刊登,所附命令标注的原始发布日期是7月24日。 要求里表示在采购端,要把DeepSeek及关联实体的相关产品和服务,从机构批准清单、采购平台等渠道移除; 而在使用端,要清理机构IT系统里已经使用的相关产品。 使用DeepSeek实现的第三方产品和服务,同样被纳入了范围。 这份命令适用于美国联邦民用行政机构,其中国家安全系统、隔离涉密信息系统另有管理边界,国防和情报体系也属于其他权限范围。 DHS给出的理由包括服务器位于中国、政府人员使用服务可能导致敏感数据外流,并援引安全研究,称DeepSeek的iOS应用存在严重漏洞。 命令也设置了豁免申请程序,申请期限按命令签发日期起算60天。 我更在意的是第三方产品这一条。 按文件写明的范围,给这些机构提供AI助手、Agent或业务系统的团队,即使交付的是自己品牌的产品,也会受到其采用DeepSeek所带来的采购限制。 文件里也没有给本地部署、第三方托管单列自动豁免。 这就把影响传到了做应用的团队身上。 模型由谁开发、产品由谁交付、服务部署在哪里,原本是几个可以分别选择的事情,现在底层模型的供应商,会直接影响整个产品能否进入这部分政府市场。 对准备做美国政府项目的AI团队来说,选模型又多了一个很现实的条件:能力、速度、价格都��适之后,还得看客户有没有资格采购和使用。
Max For AI 的图片 1
10
4.4万 粉丝
曝光5.6万
我觉得大多数人可能都没意识到,昨天 @deepseek_ai 开源DeepInfer,究竟是一件多么牛逼的事情。 昨天DeepSeek直接把支撑自己大规模生产服务的核心推理框架DeepInfer开源了。 我已经数不清这是DeepSeek第几次把压箱底的东西放到GitHub上了。 从模型权重,到FlashMLA、DeepGEMM、DeepEP,再到TileLang,现在连自己的推理框架都拿出来了。 而且这次开源的东西,含金量真的很高(严肃脸)。 分布式推理、MoE并行、推测解码、异步调度、SWA Bounded Replay、结构化输出,整个推理引擎最核心的工程能力基本都在里面。 甚至已经支持英伟达SM100和华为昇腾950,采用Apache 2.0协议开源。 我觉得可能只有真正折腾过Infra,特别是用过非英伟达GPU的人,才能理解这件事情到底有多么了不起。 如果你实际用过昇腾的卡,或者折腾过AMD、Intel的GPU,你应该很熟悉那种痛苦。 理论算力看着很漂亮,真把模型放上去跑,各种莫名其妙的问题就来了。 任务跑着跑着突然hang住,Kernel出现一些完全无法理解的行为,模型莫名其妙输出一些奇怪的东西。 有时候你折腾几天才发现,问题出在底层的算子实现上,甚至官方提供的Kernel性能还不如自己让Agent写的。 很多人可能真的低估了,把一个几千亿参数的模型稳定、高效、低成本地跑起来,究竟需要多少工程积累。 你需要解决算子优化、显存管理、通信开销、负载均衡、专家并行、推理调度,还有各种硬件和软件之间奇奇怪怪的兼容性问题。 每一项单独拿出来,都够养活一家公司。 而且这套东西特别依赖长期积累,你在生产环境中遇到的那些千奇百怪的问题,别人可能连复现的机会都没有。 这些经验最后会一点点沉淀到代码里,变成实实在在的技术壁垒。 所以你现在再回过头来看,为什么DeepSeek的API价格能够做到那么低,为什么它能以这么低的成本支撑如此庞大的推理需求? 背后就是这群工程师,长年累月地在Infra上投入大量的人力、算力和精力,把每一点性能一点点抠出来。 至少从我接触过的一些国产算力生态来看,DeepSeek在推理系统上的工程积累,确实已经远远超过很多硬件厂商官方软件栈给我的体验。 而且这件事情的护城河非常深。 因为你就算拿到了同样的GPU,跑同样的模型,如果推理框架的效率差一截,成本就可能差出一大截。 这些差距最后都会变成真金白银。 DeepSeek最让我震撼的地方就在这里。 他们明明可以把这些技术藏起来,继续维持自己的成本优势,结果他们选择把这些年积累下来的核心推理技术开源给全世界。 虽然这次开源的还是离线推理版本,完整线上服务需要的KV Cache管理和负载均衡组件尚未全部公开,而且目前支持的硬件也有限。 但这已经相当了不起了。 这就像你花了几年时间,掌握了一门可以让自己持续赚很多钱的独门手艺,已经靠它建立起了巨���的竞争优势。 然后有一天,你突然决定把这门手艺最值钱的部分写成一本教材,免费发给全世界。 甚至允许其他人拿去改造、商用,跟你自己竞争。 我操,这真的是功德无量的事情。 说实话,我现在越来越佩服梁文锋了。 这些年国内大模型行业一直在讨论追赶、竞争、商业化,大家忙着发榜单、卷价格、抢用户。 而DeepSeek在持续做前沿研究、训练新模型的同时,还在不断把自己积累的技术贡献给整个开源社区。 他们自己也受益于vLLM、SGLang等开源项目,现在又把大规模生产环境里打磨出来的东西贡献回去。 这才是我特别欣赏的地方。 因为在一个如此激烈、所有人都恨不得把自己的技术壁垒藏得严严实实的行业里,能坚持做这样的事情,真的需要很大的勇气和理想主义。 尤其是在今天,国产算力生态还有大量基础设施需要完善,开发者还在为那些莫名其妙的bug、性能问题折腾的时候。 未来一定会有很多开发者、很多公司,站在他们今天开源的这些代码上,继续往前走。 我觉得中国AI行业能有梁文锋这样的人,有DeepSeek这样一家公司,真的是一件很幸运的事情。 国模不生梁圣,万古如长夜。 梁圣牛逼,DeepSeek牛逼。