
Back to topic rankings怎么感觉 Anthropic 和 OpenAI 对调了😂
OpenAI 宣布断供 Cursor 后不到两小时,Anthropic 联合创始人、首席算力官(Chief Compute Officer)Tom Brown 在 X 上回应:Cursor 从 2024 年的 Sonnet 3.5 时代起就是 Anthropic 信任的合作伙伴,Anthropic 会继续增加算力支持 Cursor 里的 Claude 模型,也期待 Cursor 在 SpaceX 的下一步。 比较好奇,为啥这个月国产模型像寒武纪大爆发一样。
每家模型都进展飞速,懂行的讲讲背后原因啊。 吴恩达讲了一个我很认同的判断。
Agentic Coding 时代,软件工程的基本功并没有过时,反而更重要了。
以前学软件工程,是为了自己把代码写对。
现在学软件工程,是为了知道 AI 写得对不对,以及该让它怎么写。
Agentic Coding 真正淘汰的是大量把基本功消耗在具体执行上的时间,并非基本功。
语法、API、样板代码会越来越便宜,但架构、数据、可靠性、安全、成本这些判断反而越来越贵。
AI 降低写代码的门槛,同时却在不断抬高做判断的上限。 Claude 新的一篇博文《How Warp builds self-improving agents on Claude》 https://t.co/CsyjaGY8TC ,看了后还是挺有收获,它解决的是 Skill 的进化问题。
这个问题我以前也研究过,我写了一个反编译 JS 代码的 Skill(https://t.co/y6kA8TDnZ3),每次 Agent 反编译的时候遇到新的场景解决了就自己更新自己的 Skill,效果还不错,能一直优化,就是 Skill 文件越来越大。
我还研究过写作的自我进化 Skill,那个就一言难尽,因为它其实没有自己统一的标准,经常负优化,越写越糟糕。
说回来 Warp 这个,Warp 是一个挺有名的终端工具,内部尝试借助 AI 做 Code Review。一开始让 Agent review 代码,效果并不理想,主要问题体现在 Agent 不了解你的项目,不知道你的团队规范,不知道历史经验教训,就算你指出来问题它下次还记不住。简单来说就是没有记忆。
初期他们采取了很多补救措施:
- 手动根据失败案例改系统提示词
- 完善项目的 AGENTS.md 文件(有意思的是这篇文章是 Claude 发的,但是用的是 AGENTS.md 而不是 CLAUDE.md,我记得 Claude 默认不支持 AGENTS.md 的😅)
但效果并不理想,一方面它依赖于人主动去做,成本较高;另一方面团队成员在 Code Review 时人工在 PR 写的高质量评论完全没用上。
所以他们搞了个解决方案,一个基础 Skill 负责做代码审查,一个改进 Skill 负责定期收集人类工程师在代码审查时的评论,尤其是对 Agent 审查结果的评论,根据人类工程师的评论去更新代码审查的 Skill。
换句话说,它不是依赖于模型自己去改进自己,而是 Agent 根据人类对模型结果的标注(人类对代码审查的评论),去改进技能。
只不过它把这个事做的摩擦力极低,不需要人手工去收集整理评论,不需要填写调查问卷,人只要自然的去代码下写评论,后面的事情都是 Agent 自动完成。
这可能正是 Agent 的最佳实践方案之一:人负责高纬度的标注、评论、反馈这些事情,Agent 去做执行的工作,Agent 根据人类的反馈去改进 Skill。
除此之外,他们还总结了一些最佳实践:
1. 写原则,不要写死规则。
编写 skill 时,要像在指导一个聪明人,而不是在给计算机编程。在 Skill 中写“寻找重复代码”,比列出详尽的变量命名规则更有效。
2. 解释为什么。
说明规则背后的理由,能让智能体针对问题进行推理,而不是机械执行僵化指令,也因此更容易举一反三。
3. 让反馈没有摩擦毫不费力。
在人们原本工作的地方收集反馈,例如直接评论 PR 或 issue。同时让收集过程自动发生,不要增加额外的提交步骤。低摩擦才能让信号持续流动。如果反馈太麻烦,你就收不到反馈,也就无法改进 Skill。
4. 保持 Skill 精简,并使用渐进式披露。
优秀的 skill 文件不会很庞大;它会引用资源文件和脚本,而不是一次性把所有内容都塞进上下文。
5. 反馈质量大于数量,但数量也有帮助。
一位资深工程师给出的少量、详细且与领域相关的反馈,可能比大量草率反馈更有价值,因为简单的赞成/反对并不能说明“为什么”。
即使样本量相对较小,只要反馈来自掌握领域知识的人,而且足够详细,你也能得到非常好的信号——这些知识是智能体通过其他方式根本无法获得的。话虽如此,优质信号的语料越多,效果越好。
6. 做好改进 Skill 的 Skill,可以用来改进其他 Skill。
把改进 Skill(也就是前面提到的一个代码审查 Skill 一个改进 Skill)做好,收益不��限于眼前这套 Agent 循环,因为改进 Skill 在不同用例之间具有很高的复用性。除了领域专用知识这一部分,它其实是一套相当通用、可复用的机制。代码审查 Agent 的改进 skill,也可以应用到其他 Skill 的改进上。
可能有人会担心:如果反馈本身是错的呢?
Warp 的做法是永远不让 Agent 盲目接受反馈。给它足够的上下文来做基本的合理性检查,限制谁的反馈有权影响技能更新(不是所有人的意见都同等重要),最后始终保留人在循环中审核改动。
对于那些有明确标准答案的领域,比如代码是否通过了测试、部署是否成功,可以先建一个验证基准,让 Agent 自己对着基准跑。没有标准答案的领域,比如代码风格、文档质量,就靠领域专家的判断,不要开放给所有人随意反馈。 判断一个公司是不是AI Native
我认为有一个指标及其关键
就是这个公司有多少数据是可以被Agent获取使用的
我称之为:智能数据比率
如果一个企业里
各种生产数据,进销存数据,营销投放数据,销售数据,客服数据,全部散落在四处
甚至有的数据还是纸质化的
那么势必会影响Agent获得上下文
如果Agent没有这些上下文
那么就会限制Agent的能力,就很难谈得上「使用」
所以AI Native的第一步,是数字化这些数据
数据的数字化程度越高,就越容易AI Native
互联网公司,数据大部分在系统里
实体公司,可能还需要一些终端设备来收集现实世界数据
如果你公司内的数据,Agent都可以轻松获取
那么你大概是步入AI Native公司的行列了 这就是我不愿意用 drawio,而是建议用 PlantUML 的原因。
我��个模块都有一组设计文档,每次改���代码,agent 就会随手修改文档和框架图 流程图,根本不用管。最多定期在让它全面对齐一下。
换做 drawio,修改图表就成了主要工作,占用时间,还占用上下文。 当你还在纠结 Cursor 的 Tab 键好不好用的时候,
前 Cursor 员工、现 SpaceX 和 xAI 工程师,已经一个人带着 20 多个 GrokBot 代理,
单月提交了 1000 多个 PR,这个月还要直接翻倍。
妹子这套打法最狠的地方,在于彻底抛弃了坐在屏幕前等 AI 回复的低效交互,
直接在 pstack 里用 loop、goal 和 swarm 三个指令把任务完全交给 Agent 蜂群,
从需求拆解、代码编写到本地环境验证、自动化测试、最后发起 PR,整个闭环 24 小时全自动运转。
这其实就是下一代软件工程最真实的缩影,
以前我们以为的 AI 编程是给你配一个打下手的实习生,现在直接演变成了你是一个技术总监、底下管着 20 个不知道疲倦的离线工蜂,
程序员的核心能力不再是敲代码的速度,而是定义目标边界、设计验证沙箱、以及做最终 Code Review 的架构判断力。
一人软件公司的分水岭已经极其清晰了,
未来能拉开十倍效率差距的,从来不是单个模型的智商,而是你能不能把任务彻底解耦成离线 Agent 蜂群的能力啊。 https://t.co/hIkkrCxJEC 我觉得判断一家公司是不是 AI Native,看他们做事的流程,是围绕人做事设计流程还是围绕 AI Agent 做事设计流程。
AI Native 很重要的一点就是 AI Agent 是执行主体,人负责定义问题和验收。如果只是在原来做事的方式流程里面加一点 AI,那不 AI Native。 逆向工程这活儿,以前是硬骨头,现在也要被 AI Agent 接管了。
x64dbg 老玩逆向的都熟,Windows 上经典的开源调试工具,白嫖还能自己写插件。
关键是有人给它整了个 MCP Server,直接把调试能力甩给 Claude Code、Codex 这类 Agent。啥意思?
1️⃣ 让 AI 自己调 x64dbg 去扒程序
2️⃣ 下断点、读内存这些活儿也能交出去
3️⃣ 你在旁边看着就行
以前扒汇编得一行一行啃,眼睛都看瞎,现在连逆向都开始 Agent 化了,这门槛降得有点狠啊。
🔗 x64dbg:https://t.co/sZQPE7sY0i
🔗 GitHub:https://t.co/MR6TCmaeq2
Codex为什么能够碾压Claude Code、workbuddy等一众工具?我觉得核心原因之一就在于Codex的Computer Use功能实在太过于惊艳!
我有两个ChatGPT Pro20×账号,所以基本没有积分焦虑,所以疯狂开Computer use并行做多个任务,很神奇的就是Codex不会抢我的鼠标,各个任务彼此之间也不会打架。
它们在浏览器/各个桌面端软件之间各司其职,似乎每一个Computer use都配备了一个“虚拟鼠标”和“虚拟窗口”——
因为我经常看到我桌面上啥东西都没有了, 那个虚拟鼠标还很有规律的在那点,然后Codex任务在正常跑。。。
好处就是那种比较依靠人的工作——登录界面、填写各种信息、截图保存,都可以多个任务并行,完全不需要人类的介入,效率直线飙升!
还有个更牛逼的,我用Computer use经常做Obsidian插件的端到端调试,这个真的谁用谁爽。
包括,我还把剪映11.x版本用Computer use解析出来了,可以直接用Codex剪视频,自动创建草稿,导入分轨素材,嘿嘿,留个悬念,之后完善好了发🤪

1. 用 pi
2. codex 里写完规划,执行的时候尽量用 sol high/sol medium
3. 定期清理 over engineering 全球最顶级的风险投资机构 @a16z 今天正式摊牌了,
新设 11 亿美元的机器时代基金,一分钱都不投聊天软件,
他们给出了一个让全硅谷后背发凉的残酷真相:
AI 最大的瓶颈从来不是模型不够聪明,而是整个物理世界已经彻底撞墙了
过去一年,大模型单次任务烧掉的 Token 正在按数量级暴涨,
但后台的物理供给链已经完全脱节:
机柜功耗从几年前的 5 千瓦狂飙到现在的几百千瓦,未来 3 年直接冲向 1 兆瓦,
铜缆到了物理极限,风冷全部被逼成液冷,
全球数据中心排队抢电,订单直接预订到了 2028 年
a16z 把这层叫做模型以南(South of the Model),
模型本身已经不再稀缺,模型底下的一切都在发生物理级的大地震:
从芯片、内存带宽、光互联,到场内自备电源、变压器、甚至底层的铜矿
他们直接挑明了下一轮算力战争的代差:
软件可以按月迭代,但物理世界的工厂和电网只能按年扩产,
Token 需求每年涨 1000%,硬件供给一年只能挤出两三成,
谁能把这个物理供给缺口补上,谁就能吃下这轮周期最暴利的硬核资产
这不是再多买几张显卡的小打小闹,而是整代���算架构要推倒重写,
属于聊天框的虚火正在熄灭,
真正的大战,已经在瓦特、带宽和原子的物理世界全面开打了!
https://t.co/SbVEIjIU6u 为什么你用 Claude Code 总是在修 Bug,而Claude Code 负责人 Boris却能一个人并行狂飙?
核心差距只有一条铁律:
交付质量差三倍的根源,不在于模型智力,而在于你有没有给它写出能自己跑测试、看截图纠错的验收闭环,
Anthropic 内部把新人的技术 Onboarding 从 3 周直接砸到了 2 天,
Boris 刚刚公开了他们团队天天在用的 5 个底层习惯:
进新仓库第一天坚决不写一行代码,先让 AI 翻 Git 历史讲清楚这坨代码为什么长得这么怪,
别再到处搜神仙 Prompt 了,
你把它当聊天工具,它就是个打字极快但到处埋雷的廉价外包,
你给它配齐上下文、做计划门控并给它自我验收的手段,它就是一个人顶一个团队的核心同事
Boris 自己在 Anthropic 带团队,把这套工具的正确打开方式拆成了三条硬核军规:
1️⃣ 进新项目第一天坚决不写���码,先问透代码库:
别一上来就让人家做功能,先问这个类怎么实例化的、翻 Git 历史看看这坨怪异的 API 当年是怎么长出来的,
Anthropic 内部把新人熟悉项目的时间从三周直接压到了两天,
让它自己读代码翻 Issue 吐出 Wiki 级总结,摸清边界再动手;
2️⃣ 写复杂代码前,必须强制逼它先做 Plan:
反面教材是一上来丢一句做个大功能,
真正的高手永远只有一句硬指令: 动手写任何代码前,先头脑风暴方案、列出详细计划,等我审批同意后再开工;
3️⃣ 交付质量差三倍的死穴,在于有没有自我验收闭环:
没给反馈信号时,AI 只能看着像写完了就停手,
给它配上单测、Puppeteer 截图或者模拟器,把提示词改成“做完后跑测试,报错就自己改直到全绿”,
让机器自己去撞南墙修正,质量瞬间发生质变
把踩坑教训用一个井号快捷键直接焊死在 CLAUDE.md 里,
一次纠错,终身复利,
这根本不是什么提示词戏法,这是最顶级的上下文工程与工程管理啊 https://t.co/zofW5zX86B 做 Agent 开发的都进来,这个白嫖资源别错过了❗
O'Reilly 那本《AI Agents - The Definitive Guide》,作者直接把配套代码全开源了,12 章内容对应 35 个 notebook,思维链、思维树、ReAct、多 Agent 协作,一直讲到记忆、评测、成本核算这些真上生产才会遇到的坑。
最狠的是每个 notebook 都带 Colab,浏览器点开就跑,本地环境一个都不用装,懒人福音。
我翻目录发现最后一章专门讲给 Agent 做威胁建模,这块入门教程基本没人碰,光这一章就够回本了。书没买也不耽误你把代码撸一遍。
🔗 https://t.co/d7zHND1EBw
Google 这篇新发布的论文简直就是一篇神文,如果要给你的Agent建一个skill库,请务必收藏!
感觉这篇论文把 99% 做 Agent 和个人知识库的人全骂了一遍哈哈,
你以为越记越多是在进步,其实把执行记录、复盘认知和操作手册混在一坨,根本不可能产生复利,
好手册能让 9B 小模型直接干翻 27B 裸跑,
但弱者写的一身笨补丁,能把顶级大模型活活毒死
Google 团队在 WikiSkill 里给出了极其残酷的几组真相:
1️⃣ 战术可以失败回滚,但对失败的理解必须永久焊死:
真正厉害的系统必须物理拆成三层: 原始轨迹只读归档、复盘认知只增不减、执行手册随时修补回滚,
前人把探索教训散落在对话框里,每次遇到问题都像失忆一样重新踩坑,
打法验证变差可以撤回,但踩坑认知必须留下,复利才会真正爆发;
2️⃣ 小模型靠手册逆袭,大模型吃手册更狠:
9B 模型配上进化出的结构化手册,表现直接干翻 27B 裸跑,
而在复杂表格任务上,27B 模型加上手册更是直接从 40% 狂飙到 81%,
程序性知识的差距,早就超越了单纯堆参数的裸智力差距;
3️⃣ 弱者的妥协是强者的毒药:
小模型为了防止自己翻车写的一堆单行脚本和保守补丁,直接把顶级 Gemini Flash 从 50% 砸到了 18%,
你在低水平阶段摸索出的避坑套路,强行套给高手往往是一副要命的枷锁;
4️⃣ 开卷小抄练不出真本事:
实验证明,模型在实战练习时如果直接偷看全套知识库,最后进化出来的手册反而大退步,
因为靠小抄蒙混过关的过程,会把最致命的逻辑漏洞给彻底掩盖掉
别再把所有笔记和日志混在一堆乱炖了,
原始记录、提炼认知、可执行手册是三码事,
把失败变成资产,学习的飞轮才会真正转起来啊
蓝哥这篇真是手把手教你把 Grok Bot 打通成专属 Linux 开发机啊!
很多人还在把 Grok Bot 当聊天框使唤,
其实你账号背后一直躺着一台 8 核 16G、带持久存储的真实 Linux 云主机,
用 Tailscale 组个私网直接把 SSH 给它打通,
聊天框只是个遥控器,用自己的终端连进去,才是真正坐到了这台机器面前
官方虽然没把 SSH 摆上台面,但这台机器的底层环境是完全常驻的:
固定用户名为 box,持久化文件全在 /workspace 目录,
只要让它和你的电脑挂进同一个 Tailscale 账号,两条命令就能完成内网握手
打通之后,整个体验完全是两个世界:
1️⃣ 本地终端直接接管:
直接用你自己最顺手的 Terminal、VS Code 或 Cursor 连进去,写脚本、跑测试、调模型,顺滑得就像本地虚拟机;
2️⃣ 7x24 小时后台狂奔:
关掉网页、合上笔记本电脑,它在云端照样按部就班跑你的自动化抓取或编译任务;
3️⃣ 真正的本地工作流联动:
scp 传文件、rsync 同步代码一气呵成,再也不用在网页对话框里傻傻地复制粘贴几十行代码
不过提醒一句: 走内网穿透自己玩开发机和跑脚本极爽,但千万别把端口打到公网去开站点,
把聊天框当遥控器,把终端当方向盘,这才是极��该有的打开方式啊,
@0xlangeai 蓝哥这篇真的很干!
Grok Bot 真的太猛了。
人们不断发现用它赚钱、自动化工作和经营生意的新方法。
10 个惊艳案例: Skills 构建完整指南(33页)
这是 26 年看过最完整全面、质量最高的 Skills 构建指南,虽然是 26.01 发布的,应该还有朋友没看过。
强烈建议保存备用,时常拿出来系统学习一遍,会对 Skills 的构建、验证和使用过程有更深更系统的理解。
The Complete Guide to Building Skills for Claude
https://t.co/KqPV5yK4Ng
大家别再盯着各家大模型跑分了,xAI 联合创始人 Jimmy Ba 这场 20 分钟闭门访谈,
直接把未来两年的 AI 终局给掀了个底朝天:
11 万张顶级芯片在后台狂烧,不是为了卖那几分钱的 Token,
而是要把所有基准测试直接刷穿,批量制造能直接入职的真人替身员工
全网都在传各种零碎八卦,我把这场 20 分钟原汁原味的访谈通读了一遍,
最值钱的干货就这三条暴论:
1️⃣ 效率提升 10 倍,绝不是停下堆算力的理由:
就算架构优化让模型省了十倍算力,为什么不顺势造一个聪明十倍的大脑?
知识本质上就是前人压缩过的计算,不探索更大的算力空间,整个领域就会在原地踏步
2️��� 别再单项刷题了,要直接训练职业:
AIME 满分、GPQA 刷穿,做题能力今年夏天就要被全盘封顶了,
接下来不是去比谁更会做数学题,而是像律师、金融分析师、全栈工程师一样,
把几十种能力打包成能 7x24 小时独立上岗的数字员工,按创造的价值收费,而不是按 Token 算零钱
3️⃣ 组织架构绝不能超过三层:
在 AI 狂奔的周期里,团队多一层汇报就是一次严重的信息有损压缩,
全员按 10 倍效能假设去搭,组织带宽比官僚层级重要一万倍
从在屏幕里搬比特,到放出 100 万个物理机器人去真实世界搬原子,
大模型的下半场,真被 xAI 给彻底挑明了啊
https://t.co/p2dfMAiBiX Claude Code、Codex 写完项目,架构图不用再另开软件从头画了!
用这个开源 Skill Archify ,能让 Agent 读取代码库或系统描述,生成架构图、时序图、工作流图等交互式 HTML;出图前会检查 Schema、布局和连线路由。
支持 Cursor、Claude Code、Codex CLI、OpenCode,MIT 开源。
👉https://t.co/YHCa0XX7dY
面试快结束时,对方问了最后一个问题:你觉得 AI 时代最重要的能力是什么。
这种问题我一般都说点稳妥的。那天我说了实话。
我说判断力。
他让我展开。
我说我入行的时候,一个问题卡住三天是常事。要翻文档、要读源码、要在论坛上等人回。那三天里,答案是稀缺的,谁手上有答案,谁就有价值。
现在不是了。我三秒钟能拿到五个答案,每一个都工整、有条理、看起来都对。
难的不再是拿到答案,是从这五个里挑出对的那个,或者认出这五个全都不对。
这个能力没有捷径。它来自你自己踩过的坑、查过的日志、半夜回滚过的那些版本。
他问,那你怎么培养新人这个能力。
我说我也在想。以前新人是被 bug 教会的,现在 bug 还没出现,AI 就替他绕过去了。他省下了时间,也省掉了那次教训。
他没接话,在本子上写了一行。
出来的时候我想,其实这个问题我自己也没答案。
我只是比三年前更确定,答案便宜了,判断变贵了。 系统设计笔记这种东西,居然有人直接开源了——114000 star,内容量管够,该有的基本都给你捋明白了。
但说句实在话,现在面试还死磕系统设计,我一直有点想不通:真正干活的时候,大部分人根本用不到那么深;面试问得越来越玄,答得好也不代表活干得好。
想白嫖的自己去扒:
🔗 https://t.co/06Grn4o1qr
你们现在面试,这部分卡得还这么狠吗?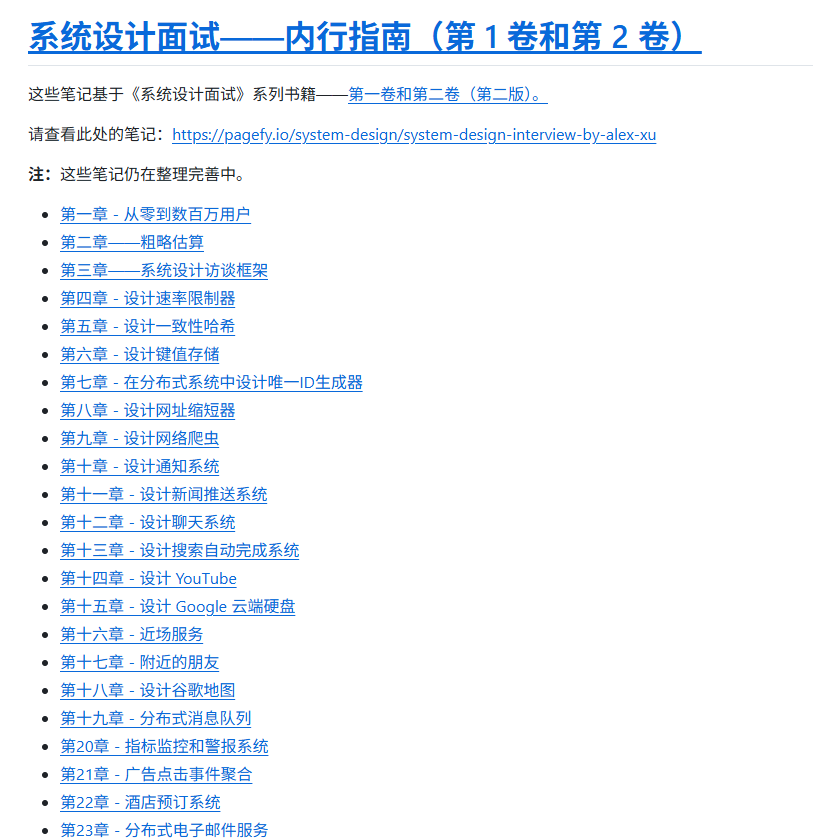
AI Engineering Skills Map 系列之「软件工程基础」
吴恩达老师的 AI 工程技能图谱第二篇详细展开:
1. 构建与部署 AI 应用
2. 软件工程基础(本文主题)
3. 使用 Coding Agent
4. 塑造构建方向
吴恩达老师认为:Agentic Coding 降低了"写代码"的门槛,但抬高了"懂软件"的价值。 会用 AI 写代码 ≠ 会做软件工程;真正的竞争力在于你能否驾驭 Agent 做出正确的工程权衡。
论证链条非常清晰
现象:编程 Agent 可以替你写所有代码,语法记忆类知识正在贬值。
问题:纯 "vibe coding" 的新手能做出简单应用,但 Agent 会在延迟、可用性、一致性、可靠性、可维护性、简洁性、成本等维度上做出糟糕的默认权衡——而开发者根本不知道这些权衡存在,自然无从纠偏。
结论:软件工程基础并没有被取代,只是从"手写能力"转变为"决策与驾驭能力"——你得知道有哪些权衡,才能引导 Agent 做出符合你应用场景的选择。
# 五大核心能力
1. 构建全栈应用
变化:Agent 让前端、移动端等"专才"可以快速扩展为"全栈通才"。
不变:你仍需理解 UI 组件、缓存、页面渲染、API 设计、认证、状态/会话管理、异步处理、数据持久化、测试、安全、可访问性等关键概念——否则你无法判断 Agent 生成的方案是否合理。
本质:Agent 补的是"熟练度",补不了"判断力"。
2. 数据管理(全文最重点论述的部分)
单独强调数据,原因有三:
数据是地基,且最难改:代码可以重构,数据架构一旦定型,迁移成本极高(即使有 Agent 辅助)。
数据决策高度依赖人类上下文:存什么、存多久、选什么存储模型(关系型/文档/KV/图)、事务与并发、数据生命周期——这些都需要业务理解。
对 AI 应用有双重重要性:你的 AI 系统直接从数据源获取上下文,数据架构错了,AI "不知道自己不知道什么",错误会被静默放大。
前瞻性提醒:"为 Agent 而建的数据基础设施"(区别于为人类/传统软件而建)是快速演进的新领域,最佳实践需要持续更新。
3. 系统架构设计
架构 = 在理解全栈组件 + 数据之后,把它们组装起来的决策:前后端边界、系统拆分、状态放置、单体 vs 微服务、技术栈选型。
关键洞察:正确的架构是移动靶。原型期、首个生产系统、规模化阶段,各阶段的最优架构不同。架构能力 = 随阶段演进架构、持续做出更好权衡的能力。
这需要"技术深度 × 业务上下文"的双重知识——恰恰是 Agent 最缺的部分。
4. 安全与可靠性
可靠性:测试策略(单测/集测的比例、框架、覆盖率)、面向失败设计(限流处理、优雅降级、缩小爆炸半径)。
安全:"Shift Left"——安全前置到开发生命周期早期。趋势是所有开发者都在变成"半个安全工程师"。
辩证看待 AI 安全工具:AI 可以扫漏洞、查供应链注入、审云配置,但用好这些工具本身需要安全知识——工具放大能力,不替代能力。
5. 规模化与生产运维
覆盖完整 SDLC:部署环境、发布策略、CI/CD、IaaS。
生产运维三件套:可观测性、告警、事故管理。
规模化手段:理解真实负载、水平扩容、负载均衡、数据层扩展(分片、索引、复制)。
加上"软"工程实践:版本控制、Code Review、依赖维护、技术债管理——这些决定了系统能否长期演进。
吴恩达老师的深层思想表达
· 知识价值从"记忆型"迁移到"判断型/决策型"
· Agent 优化的是"能跑",不是"适合你的场景";上下文只能由人提供
· AI 系统的错误是静默的,比传统软件的 bug 更危险
· 工程能力的核心不是"选对一次",而是"持续演进"
· AI 时代的工程师画像是"广度扩张 + 决策深化"
给咱们的启发和建议
· 用 Agent 写代码,但用自己的大脑做决策:每个 Agent 生成的方案,追问自己"它在延迟/成本/一致性上做了什么取舍?"
· 优先投资数据与架构知识:这是最不可逆、最依赖人类上下文的两个领域。
· 把安全和测试前置:让 AI 安全扫描工具进入你的工作流,但先建立基本的安全认知框架。
· 按阶段演进架构:原型期容忍简陋,但要有意识地规划向生产架构的迁移路径。
硅谷几十年的软件创业定律,今天被 a16z 正式宣告作废了,
Ben Horowitz 带着 11 亿美元新基金给出了一个让所有程序员后背发凉的真相:
一千个顶级工程师拼命写代码两年,根本干不过一个超级 GPU 集群把资本直接暴力砸成智能,
软件模型的改进速度,已经彻底把底下的物理世界给甩崩了
这场近一个小时的闭门长谈里,a16z 把未来几年的算力大变局彻底讲透了,
最值钱的三条底层暴论必须记下来:
1️⃣ 传统软件护城河正在被资本直接抹平:
以前靠几百个天才工程师写代码筑起的两年壁垒,
现在只要对手有足够充沛的资本,砸进超大规模集群里就能直接换成同等甚至更强的智能能力,
代码不再是终极护城河,算力底座才是
2️⃣ 模型以南的一切,全是物理级的大淘金:
芯片、内存带宽、机柜光电互联、高压直流供电、液冷散热,甚至是变电站与特种电工,
模型越快,底下的物理设施撞墙撞得越惨,
全球头部算力订单已经直接排期锁死到了 2028 年
3️⃣ 创始��的基因必须从代码转向原子:
这轮周期的赢家,不再是大学刚毕业、只会调 API 的软件小孩,
而是能把芯片微架构、热力学、电网物理约束一路想到全球供应链的工程老兵
纯软件搬比特的时代正在撞上物理天花板,
把资本砸向物理世界、去重构整个机器时代的狂欢,今天才算真正开打了! https://t.co/eDY8WijtA8 1/6
我靠,鹅厂藏的还是太深了,今天才发现 @WorkBuddy_AI 竟然已经有海外版了!
而且比国内版还狠——内置就带海外模型,GPT、Gemini 不用你自己折腾,官方自带,开箱直接用。
我盯着它玩了一下午,越用越觉得:这就是 AI 办公的Alpha moment啊!
我觉得最让我喜欢的就是他们的这个Cowrite「人机双写」 功能,用起来和传统的办公习惯毫无违和感!
Vibe Coding 让不会写代码的人也能写代码,WorkBuddy 现在干的是同一件事,通人能用,能真的做出可交付的东西啊,不需要专业的基础,门槛也是低到离谱。
这条 thread 会把我的视频实操一次都给你整完(记得收藏文末福利):
· 好用的CoWrite「人机双写」功能,0积分实现在线/本地编辑文档功能
· 怎么配置能让它省钱又省 token,重度用户尤其看这条。
· 哪些免费额度和现成模板可以直接拿来用,不花钱也能先玩起来
· 还有几个我自己天天在跑的真实场景和小技巧。
工欲善其事,必先利其器。先花两分钟把工具配到位,再一个一个视频演示它到底能干什么。👇🏻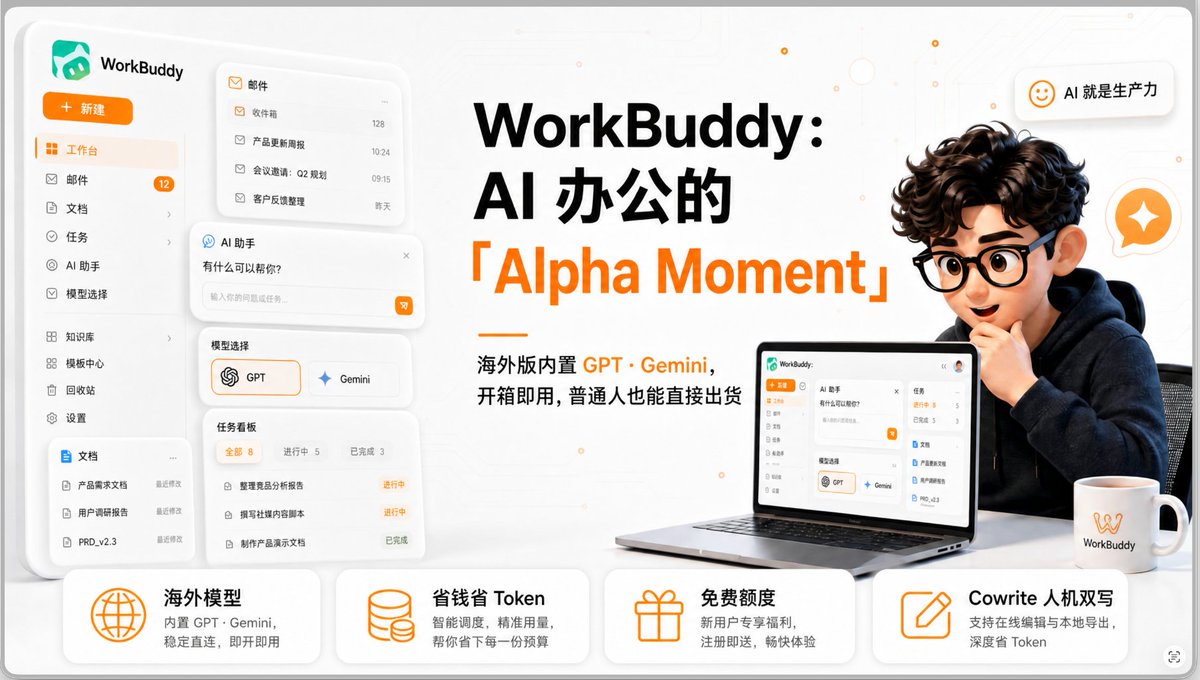
微软自家出品的硬核项目——intelligent-terminal,最近在开发者圈子里直接炸了。
说白了,这是微软在Build 2026上放出的Windows Terminal实验分支,直接把AI Agent原生塞进了命令行底层,彻底告别在聊天窗口和终端之间来回切的那种降智操作,Agent直接盯着你的Shell输出干活。
作为官方出品,微软这次把Copilot、Claude Code、OpenAI Codex、Gemini CLI全部平等对待,你想接哪个Agent CLI都行,自己本地搭的也能用,完全不锁门。
三个核心亮点:
Agent面板:停靠式上下文面板,自动读取Shell输出,Ctrl+Shift+.一键唤起,秒切AI辅助
错误自动检测:命令跑挂了状态栏指示灯亮起,Ctrl+Alt+.直接把错误上下文喂给Agent,让它解释或一键修复
协议无关:基于Agent Client Protocol(ACP),未来接新Agent几乎零成本,随时换将
底层设计也干净得不像微软出品——它只是本地传输层,不调云API、不持久化会话,数据走向完全由你选的Agent决定,隐私控狂喜。
唯一劝退门槛:只支持Win11 22H2+,安装命令奉上:
winget install --id Microsoft.IntelligentTerminal -e
如果你是Windows用户又天天跟Shell打交道,这玩意儿装上就回不去了,强烈建议冲一波。
🔗:https://t.co/dDpQq0yl65
semantica 给 AI 系统底下垫了一层图谱基础设施,号称 Agent 版的开源 Palantir,已斩获 11000+ Star!
它把企业数据抽成知识图谱,每条事实都带来源,每个决策都是能查的对象,为什么做、依据什么、影响了啥都能追。
GitHub:https://t.co/OLqCa8ZDV8
推理走的是规则引擎不靠大模型,结果可复现,遇到互相矛盾的事实会标出来,而不是悄悄用新的盖掉旧的。
Neo4j 在内的 8 种图数据库随便换,LangChain、CrewAI 能直接接,还带 MCP 服务,Claude 这类工具也能连上用。
比较适合金融、医疗这些行业,普通项目拿它当 Agent 的长期记忆也够用,一条命令就装上。
Agent = Model + Harness:生产级 AI 智能体工程六层实战手册
结合 Mitchell Hashimoto、OpenAI Codex 团队、Martin Fowler、LangChain、Cursor 等公开工程资料编撰。
https://t.co/etzeA1qN2S
# Agent = Model + Harness
模型只提供推理能力,决定 Agent 能否从演示走向生产环境的是围绕模型的工程基础设施——Harness。
报告的核心论据是:只改 Harness、不换模型,收益可超过模型升级:
· 同一 Claude Sonnet 4.5 在 GAIA 基准上从 30.91% 升至 74.55%(+43.64 分),差异完全来自 Harness;
· LangChain 不改模型,仅靠 Harness 优化将 Terminal Bench 排名从第 30 提升至第 5;
· OpenAI 团队 5 个月、约 1500 个自动化 PR 产出 100 万行生产代码,零人工手写——人负责设计环境,Agent 负责写代码("Humans steer. Agents build.")。
��也解释了一个行业现象:约 95% 的企业 AI Agent 止步于预生产阶段——演示效果好,却因安全审查、可观测性、边界情况幻觉、治理缺失而无法上线。
# 行业定位:AI 工程的第三个时代
1. 提示词工程(2023–24):模型"说什么"
2. 上下文工程(2025):模型"看到什么"(RAG/MCP/记忆)
3. Harness 工程(2026):模型"能做什么"
# 六层架构(报告主体)
1. Guides 引导层(前馈控制):AGENTS.md / CLAUDE.md 等规则文件,在执行前塑造行为。要点:规则必须可执行、可验证、可追溯至真实失败案例;需定期修剪,否则 200 行无日期规则就是技术债。OpenAI 内部将其视为最高事实源——文件与会话冲突时,文件优先。
2. Sensors 传感层(反馈控制):执行后验证输出。优先使用确定性、零成本的计算型传感器(linter、测试、schema 校验);LLM-as-judge 等推理型传感器慢、贵、不确定,只用于无法用规则表达的语义判断,且应作参考信号而非硬门禁。
3. Agentic Loop 执行循环:计划→执行→验证→修复→前进或升级,必须有界——默认每步最多重试 3 次、30 分钟、10 万 token、5 美元、50 次工具调用。预算耗尽时返回最佳半成品并说明��因,不允许用流利的最终答案掩盖部分失败。正确升级的 Agent 比自信地给出错误答案的 Agent 更有价值。
4. Memory 记忆层:模型每次会话都从零开始,Harness 负责状态连续性。最简方案是文件系统(plan.md、decisions.jsonl、checkpoint),对多数场景比向量数据库更便宜可靠。检验标准:中途关闭会话重开,Agent 应能断点续作。
5. Permissions 权限层:模型无法自我约束,Harness 是唯一安全边界。按范围、速率、可逆性、可见性四个维度设定能力预算;不可逆操作(部署、删除、外发消息)必须人工批准;必须隔离可信指令与不可信数据以防提示注入。
6. Observability 可观测层:结构化日志 + 成本归因 + 熔断告警(trip wire)。真正的度量不是 token 数,而是无需人工干预即完成且证据合格的任务数;成本应按"每个验证通过的结果"而非按天计算。
# 方法论精髓:棘轮原则(Ratchet)
Hashimoto 的原始定义:"每当 Agent 犯错,就工程化一个方案,让它永远不再犯这个错。"
六步循环:复现失败→归类根因→选择最强修复层→编码修复→验证防复发→监控回归。
修复强度呈阶梯上升:对话补丁 < 提示词 < 引导规则 < 传感器 < 环境约束——提示词只修一次对话,环境约束让错误在结构上不可能发生。
Cursor 的 Lauren Tan 补充了实操信号:同一条评审意见出现三次,就应固化为结构性约束。Harness 成熟的标志是规则增速下降(从每天 5 条降到每周 1 条)。
# 落地路径与边界
七天最小可用路径:Day 1–2 建引导文件 → Day 3–4 接入测试套件与有界循环 → Day 5–6 加检查点与权限 → Day 7 加日志与熔断。之后按"一次只改一层、可度量、可回滚"扩张,完成率 ≥80% 等六道闸门全过才允许扩大规模。
何时不需要 Harness:一次性问答、创意脑暴、低风险个人任务——"如果以上都不适用,对话本身就是 Harness"。
多智能体扩展:需要类型化交接("done, looks good" 不能推进生产流程)、共享状态模型而非共享上下文(避免上下文污染)、以及生产者不可覆盖的独立验证者。
发了一个 /dbs-skill-maker
和 Agent 自带的 skill-creator 不一样,以前我也觉得内置的 skill-creator 够了,这两天换成 /dbs-skill-maker,实测还是不一样
直接用 skill-creator 去做 dbskill 肯定是做不出来的
让 AI 说一下二者区别吧:
1.skill-creator 通常从“创建一个 Skill”开始,/dbs-skill-maker 会先确认你反复遇到的是什么问题、谁会使用,以及出现什么结果才算完成。
2.它会先确定适用范围。什么情况应该调用,哪些相似需求需要排除,材料不完整时应该继续追问还是停止,都会提前写清楚。
3.它不会默认把所有东西都塞进 Skill。需要参考资料就添加参考资料,需要脚本才创建脚本,理论能够改变具体判断时才会使用。
4.信息足够以后,它会直接生成可以使用的 Skill 文件,补齐判断步骤、适用边界和停止条件,不会只给一份制作建议。
5.内置的 skill-creator 也会校验和测试,/dbs-skill-maker 会进一步准备正常案例、边界情况、相似反例和留出样本,并根据测试失败的位置继续修改。
6.已经做好的 Skill 也可以交给它。你可以���供一次失败结果,它会判断问题出在触发条件、工作步骤、适用边界还是完成标准。
7.测试完成以后,它可以直接安装到本地。你明确想分享时,它还可以准备 GitHub 仓库和安装说明,让别人通过一条 npx skills add 指令安装。
所以,如果需求和文件结构已经很清楚,我还是会用内置的 skill-creator。
如果手上只有一个反复出现的问题,或者希望做出来以后可以测试、安装和分享,我现在会用 /dbs-skill-maker 很多苛责栋哥@dontbesilent 没有做出过成功产品的人,可能都还没意识到现在已经是文件即软件的时代了。
dbs相当于是几十万的注册用户的“软件”,免费plan就是关注,付费plan就是社群,高阶订阅就是线下课。然后栋哥每次发内容就是changelog,会引起新的转化。
而且,传统 SaaS 或软件的迭代速度再快,也快不过文档的迭代。
再者,也不用纠结栋哥是先做出产品,还是先做出内容。殊途同归,产品即内容,内容即产品。
就像你很难分辨,雷军是因为有了小米汽车才做好了抖音号,还是因为做好了抖音号才做成了小米汽车一样。
商业本就是一个复合体。 SpaceXAI 团队给 Grok Bot 发布了五篇官方使用指南
Grok Bot Guides - 覆盖元模式、工程、设计、GTM 和产品方向 https://t.co/6AGpkhNTpv
# 指南中提炼出 Grok Bot 的六个核心构件
1. Job description:每个 bot 的系统提示词读起来像一份招聘 JD:明确它"拥有什么职责"以及"拒绝做什么"。
2. Connections:bot 登录的真实账号体系:Jira、Figma、Salesforce、GitHub、Meta Ads 等。
3. 云端专属电脑:每个 bot 有一台 24/7 运行的云主机,带浏览器和终端,你的笔记本关机它也在工作。
4. Routines:按时钟自动执行的固定工作,不需要人触发。
5. Skills:"录制式教学":你操作一遍,它记住点击路径,之后可复现。这是一个值得注意的工程取巧——当 API 不可用(如 Meta Ads API 验证受阻)时,直接用 UI 自动化绕过。
6. Handoffs:bot 之间可以直接移交工作,不必经过人。指南反复强调"这才是让它成为团队的一点"。
# 五篇官方使用指南
1. 元模式:多团队 bot 的项目制协调 @ericzakariasson
最短的一篇,描述一个实验性模式:当 bot 多了之后,噪音和同步成为问题,于是复制人类的项目管理结构——一个项目 = 一个频道 + 一个 Notion 看板 + 一个编制名单。设一个 PM bot 负责"元工作":建项目、开频道、配人。编制规则:优先复用现有 bot;每频道最多六个;新建 bot 需人批准。bot 卡住时把任务标记为 Blocked 并在频道里 @ 人。
Eric 自己也点破了其中的意味深长之处:"越建越像一套最初为人类设计的系统"——看板、经理、认领任务的专家、Blocked 列、频道。
2. 工程:六个 bot 运营一家手游工作室 @rperry_
最"硬核"的一篇。Ryan 用六个 bot 运营手游 Rank'em(下载量刚破 1000):编排经理、数据分析、广告创意、客户端工程、GCS 运维、Bug 修复。
· 核心论点:游戏本身只占工作的 15%,其余 85% 是买量、创意、发布、QA、运维——而这些恰恰��� bot 可以接管的。
· 权责设计很讲究:只有 Analytics bot 被允许"宣布一个发现";Creatives bot 不许碰投放;代码 bot 只接受"规格"而非"建议"。这是把人类组织中的权责分离原则搬到了 agent 系统。
· 声称的 ROI:CPI(单次安装成本)从 $15 降到 $1(15 倍),D7 留存提升约 4 倍。机制是 bot 团队自主完成"读数据 → 形成假设 → 改广告/改功能 → 验证"的闭环。
一个有趣细节:某晚 bot 意识到用户的临时请求应该变成每日例程,主动把它加入了自己的职责范围。
3. 设计:用 Grok Bot 设计 Grok Bot @johnbai
设计师用四个 bot(Experiments、Motion God、Figma Bro、Devbot)做设计探索。三个要点:
· "You can just do things":想法不必先证明合理才值得做出来。他让 bot 做了三个"环境式唤起"原型(藏在 Mac 刘海里、从屏幕角落探出、跟随光标),都没上线,但每个都提供了真实判断依据。AI 把"探索的成本"降到了接近零。
· 用真实生产资产工作:Motion God 不是"生成一个动画近似",而是围绕真实的动画规格文件搭建 localhost 调试环境,让设计师用确定性控件(弹簧、缓动、时长)和直觉语言("向左下多看一会儿")混合调优。
· 重复劳动交给 Figma Bro,且通过 Figma MCP 读取精确的坐标、间距、组件结构,而不是"目测"——消除了批量生产中���积的小不一致。
John 的结论克制而准确:这没有让设计变成"一次性生成",而是让循环更紧——判断力仍是人的,bot 只是给了你更多运用判断的机会。
4. GTM:销售团队的全套 bot 编制 @kristaletz
最长、最实操的一篇,附完整提示词。编制包括:Chief of Staff(会议准备、收件箱、调度其他 bot)、Prospecting(潜客开发)、Customer Expert(每个战略客户一个专属 bot)、产品专家("10x engineer",连接代码库回答客户技术问题)、1:1 助手、预测 bot、Slides bot、销售教练。
值得注意的实践细节:
· 写作风格画像:让 bot 扫描 15–30 封已发邮件,提取问候方式、句式节奏、提要求的方式、落款,形成可复用的 style profile。
· 防骚扰护栏:起草外联前检查 90 天已发邮件和 CRM 记录,已触达的人标记 Skip Draft——"保留在表里,但不再推销"。
· 诚实性约束:提示词里明确写"宁可写'未找到可验证的动态',也不要编造"。
· 最亮眼的技巧:客户电话结束前 5–10 分钟停止 Granola 录音,让 Slides bot 根据刚才通话内容实时生成一页"我们听到的"幻灯片,通话收尾时直接展示。
5. 产品:PM 第一次有了"汇报给自己的团队" @n2parko
观点性最强的一篇。核心洞察:
· "注意力清单"(attention list)是一种新的工作原语。传统的优先级列表会过时;让 bot 持续观察你在 Slack、邮件、会议中实际在做什么,涌现式地生成"你真正在关注什么"的清单。它有两个用途:作为 agent 过滤信息的依据;以及对照"声称的优先级"与"实际注意力"的偏差。
· 为什么不只用一个万能 agent? 作者给出三个理由:可引用性(知道谁管什么)、并行性、作用域记忆(每个 bot 在工作中学习不同的东西,互不污染)。
· 组织架构模仿真实公司:不写代码的 Eng Manager(通过阅读优秀工程师的 Slack 记录来"入职学习")+ 五个 IC 工程 bot,底层再调度 Cloud Agents——"It's agents all the way down"。
· 清醒的边界意识:对外发邮件、花钱、删除操作仍由人终审;"人们希望知道对方是认真想过才提出请求的"。
Grok Bot 入门指南
https://t.co/Y4nlhoS7sj NanoClaw + Slack open-source multi-agent system is live!
• One-click Slack integration
• Auto-builds collaborative agent teams
• Isolated memory & sandboxed environment
• Real-time human-AI collaboration on canvas 下午 4 点,抖音开直播 🎤 vivian跟我说,她们一个每天用 AI 跑 10 个内容矩阵频道的团队,把自动化做到了极致:
整个工作流全部打包成 Skill,新人入职插上电脑就能跑出同款水准的视频:画面、字体、声音、数字人全都是自己训练的模型
但有一件事他们死守着人工:所有频道的脚本,创始人本人一个字一个字写
问了原因,回答极其清醒:
我们试过让 AI 写,也试过雇专业编剧,都做不出那个味
LLM 是基于历史存量数据做概率预测的,它长不出创新的脑子
大脑是十几年真实认知积累出来的,这个东西没法被蒸馏
当 AI 把执行的边际成本打到地板之后,人类独特审美和判断力的溢价,才刚刚开始 在巨大的流量黑洞之外,有如此高质量的内容 @yihui_indie
辉哥从成本为角度,带我们横跨多个 Agent 之后,看到了下一阶段个人、组织和 Agent 的协作方式的样子,非常有启发
值得看两遍+执行一遍:
选择一个合适的主 Harness 框架
完善 AI 输入处理输出全流程
合理使用本地个人 AI 知识库
另外:视频中提到的 Cursor blog:https://t.co/m6RhcqqeYG WebMCP可以让agent更容易的操作一个网站,这很好。但我觉得需要它能影响分发的时候,大部分网站才更有动力去支持。也许从exa, firecrawl, parallel这些面向agent的搜索引擎开始?
AIPositiveAll-time data
AI写作去味提示词与Skill工具扩散
中文 X 创作者继续围绕 AI 写作去味、Skill 工具和 Agent 课程分享形成高收藏讨论。余温称写作时只加入“禁止使用状语”就能明显减少 AI 味并提升小说质感,铁锤人随后转述类似体验;Viking 分享 show-me Skill,强调让 AI 用最小图示解释技术问题,而不是堆砌长段文字;G哥则分享开源 AI Agent 课程,并称可替代某些付费课程。讨论显示用户关注点正从单条 Prompt 转向可复用工作流、图解能力和系统化学习资源。
#AI写作#去AI味#提示词#Skill#AI Agent
Topic heat
17173
Posts
37
Views
151.5万
Creators
22
Topic trend
From first appearance to last update, with a seven-day minimum window.
All related posts
37 posts in total


