向阳乔木

向阳乔木

@vista8最近同步 10/22/2026, 12:18:42 AM

喜欢摇滚乐、爱钓鱼的PM 第二届GEO大会报名-11-21/22日-深圳南山 https://t.co/N75cblhK9R

Beijing

7日排名
#114
总粉丝
133K
7日涨粉
+1.2K
7日爆帖
10
7日曝光
229K
帖均曝光
22.9K

Ranking History

Today’s rankings update in real time. Historical records retain daily top-five entries for growth, posts, and reach. Click to view a poster.

No daily top-five records yet.

粉丝趋势

近7日每日已结算数据

内容表现趋势

曝光/互动与爆帖数均按自然日结算

爆帖趋势

近7日每日爆帖数

帖均曝光趋势

每日总曝光 ÷ 每日爆帖数

Participated Topics

Participated in 8 topics

View topic rankings

中文 X 创作者继续围绕 AI 写作去味、Skill 工具和 Agent 课程分享形成高收藏讨论。余温称写作时只加入“禁止使用状语”就能明显减少 AI 味并提升小说质感,铁锤人随后转述类似体验;Viking 分享 show-me Skill,强调让 AI 用最小图示解释技术问题,而不是堆砌长段文字;G哥则分享开源 AI Agent 课程,并称可替代某些付费课程。讨论显示用户关注点正从单条 Prompt 转向可复用工作流、图解能力和系统化学习资源。

Participated post: 比较好奇,为啥这个月国产模型像寒武纪大爆发一样。 每家模型都进展飞速,懂行的讲讲背后原因啊。
Posts 1 Views 168KHeat 17.2K
#AI写作#去AI味#提示词

OpenAI 围绕代码与大模型产品线展开高频迭代,开发者实测确认 GPT-6 Astra 与 6.1 Sol 的推理速度自 20 TPS 提升至 30 TPS,严格兑现了默认提速 50% 的性能承诺。与此同时,市场传出 OpenAI 正式上线月费高达 500 美元的高阶订阅套餐,引发用户对高算力模型定价溢价与实用价值的广泛讨论;此外,ChatGPT 宣布引入隐藏文本水印技术,通过特定词汇分布规则标记 AI 生成内容。虽然官方公布了水印原理,但社区认为简短对话即可规避检测,围绕大模型性能提升、商业收割与内容溯源展开多维博弈。

Participated post: 发现一个牛逼的东西,让任意 Agent 调用 Codex 的 Computer Use。 Codex 最强的就是 Computer Use。 但最近用 Claude Opus 5.5比较多,这样就强强联合了。 刚测试通过,安装后建议配置个 Hook,指定白名单可控制哪些 App 安装地址见评论区
Posts 2 Views 134KHeat 19.9K
#OpenAI#ChatGPT#推理提速

OpenAI在开发者大会发布个人AI助手Dot后正式开放网页端体验,并同步将Codex客户端资料库重构为全新的Space功能,加速推进云端Personal Agent生态落地。实测反馈显示,Dot支持自定义配置并与桌面代码环境联动,但其在Codex内的创建引导与跨端同步体验仍显割裂。与此同时,科技圈发现顶级域名dot.com已被马斯克买下并定向跳转至旗下Grok Bot下载页,引发巨头抢夺下一代智能体流量入口的戏谑与博弈。行业观察指出,随着Meta推出Muse、Manus推出Cue以及OpenAI推出Dot,2026年云端个人智能体赛道正进入大厂全面卡位的新周期。

Participated post: OpenAI 的龙虾来了,名叫 dot,入口地址: https://t.co/qsKTE6XJsm 2026 的一年是个轮回,从龙虾爆火,现在又回归龙虾形态,纷纷都在做云端 Personal Agent: ① Meta 的叫 Muse ② Manus 的叫 Cue ③ OpenAI 的叫 Dot 还有传言国庆后上线的豆包Personal Agent,已经上线在疯狂迭��的 TodayAI。 人注意力有限,哪怕再多好用的 agent,可能也只用那么几个,看最后哪个胜出,有点期待。
Posts 3 Views 112KHeat 654
#OpenAI Dot#Codex#Personal Agent

腾讯混元Hy4 preview发布后,实测体验显示Sol模型在迁移磁盘文件时逐文件计算并核对哈希值,被独立开发者William称为防御性编程特征明显。William称该过程耗时过长,他选择中断;向阳乔木引用腾讯官方公众号内容,称模型通过与内部软工、游戏、金融、安全等领域专家共建数据,在真实生产力任务上取得进步。候选推文均为官方转述和个人实测,尚无独立基准测试结果,讨论重点是真实任务表现和人与AI协作时的控制问题。有观点认为谨慎行为在数据完整性场景中有价值,但暴露了效率与用户意图理解上的不足。

Participated post: 读了腾讯 Hy preview的官方公众号。 最打动我的是这一句: “通过与腾讯内部软工、游戏、金融、安全等领域顶尖专家的高质量数据共建,Hy4 preview 在各类真实生产力任务上取得显著进步。” 让我想梁文峰的投资人讲话录音,提到 DeepSeek团队的研究员大部分时间都在标数据。 专家高质量数据,非常影响模型表现。 如果模型厂商算法傲慢,只重视算法,不重视数据,进步就不会快。 还是得把手弄脏,把数据搞好。 https://t.co/4sefenm4RJ
Posts 2 Views 102KHeat 680
#腾讯混元#Hy4#Sol模型

中文开发者分享AI编程与桌面软件操作的新实践,涉及Codex配合REA下载微信视频号视频、研究WorkBuddy读取微信聊天记录,以及Claude Code项目级记忆和Skill规则复用。宝玉称,视频下载需要多步对话,Codex最终通过配置本地代理完成;Andy Stewart自述使用REA配合算力舱研究聊天记录读取方式,但可见帖子没有呈现完整过程。Jason Young认为,项目记忆能够保留设计决策、开发红线和待修复问题,提高更换工具的成本;向阳乔木建议借鉴Skill中的验收、数据和画面控制规则。讨论延续智能体操作软件与开发工作流优化的脉络,但缺少兼容性、数据授权、稳定性及效率对照,不能据此确认普遍适用性。

Participated post: 最近最火的 Skill 之一,不过只安装用就浪费了。 可以学习长处,融合到自己的 Skill 中。 这个 Skill 的中验收、数据、画面元素控制等规则值得参考。 安装地址: https://t.co/qcMC8fIqpS https://t.co/Ab7A35qP52
Posts 2 Views 68.5KHeat 20.6K
#Codex#REA#微信自动化

Anthropic 旗下 AI 助手 Claude 网页端订阅页面近日出现重大调整,用户发现账单结算国家选项中已可直接选择中国,且 Pro 与 Max 等付费档位界面同时现身简体中文支持与银联支付标识。该变化迅速在开发者社群引发轰动,部分用户推测 Anthropic 可能正在试探性放宽对中国大陆用户的注册准入;但鉴于此前该平台严苛的风控和大规模封号历史,亦有技术极客质疑此举或为精准识别违规账号的“合规陷阱”,并分享利用开源插件与中英文信息替换隐藏真实身份的防封号思路。讨论反映出国内开发者对闭源大模型官方准入的渴望与长期风控阴影下的戒备心理。

Participated post: 朋友群里看到,这Claude 防封思路好啊! 用 Claude Code Mod 实现一个隐私插件。 资料信息进入 LLM 前做替换,感觉也能升级下,把对话从中文翻译成英文,从而尽可能隐藏中国人身份? MD,Anthropic 把大家都弄魔怔了。 开���插件见评论区 https://t.co/e3Y3vMyuvE
Posts 1 Views 63.4KHeat 10.8K
#Claude订阅#Anthropic#银联支付

中文开发者分享Muse与Grokbot接入本地模型的方案,将个人智能体讨论从跨环境协作延伸至持续运行成本。实践哥Li称,有显卡的用户可通过Tailscale组网,让Muse连接本地Qwen 3.8 Next Flash,并以“5毛钱电费”和“无限token”描述使用体验;可见教程在登录步骤处截断。Lonely随后转发“Muse无限token 2.0”方案,强化本地显卡运行的传播。Go学长则提醒,连Muse都无法注册的网络环境,不宜贸然购买Claude服务。讨论呈现本地推理降低云端额度依赖的期待,也涉及网络可达性门槛,但候选材料没有提供硬件配置、耗电周期或稳定性测试,不能确认所述成本及全天候运行效果。

Participated post: 一直不看好多 agent 协作。 今天有点改观,不同性格和技能的 Bot 还真会讨论拍板,搞出点东西出来。 给了 bot 我的 Github 和 Cloudflare API,豆包播客 API。 做出了一个24 小时播报 AI 新闻电视台。 等我下午弄好了开源。 https://t.co/1lUVoPlR9r
Posts 1 Views 29.6KHeat 12.7K
#Muse#Grokbot#本地模型

曾颖发文讨论“孙学”,表示不希望传播对孙宇晨的厌恶,主张把焦点从感情话题转向世俗成功及可供学习的经验。周先知随后转述这篇文章,将围棋取舍、求学经历、制造热点及投资创业串联为孙宇晨的成功路径,但候选材料没有提供完整原文或经历核验。与此同时,逍遥XTony批评币圈持续讨论“薄肌”,认为参与者应重视交易赚钱,并将薄肌主张解释为围绕女性展开的自我塑造。本轮延续孙学与薄肌叙事的同一讨论脉络,分歧集中于人物经验是否值得学习,以及财富、身体与亲密关系应如何排序。相关经历属于文章转述,价值判断也不能证明健身动机或成功方法具有普遍性。

Participated post: 给 CuiMao 加热,新时代吃瓜,必须上 AI ���视频~
Posts 1 Views 24.7KHeat 21.8K
#曾颖#孙宇晨#孙学

近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

3
13.2万 followers
Views4.1万
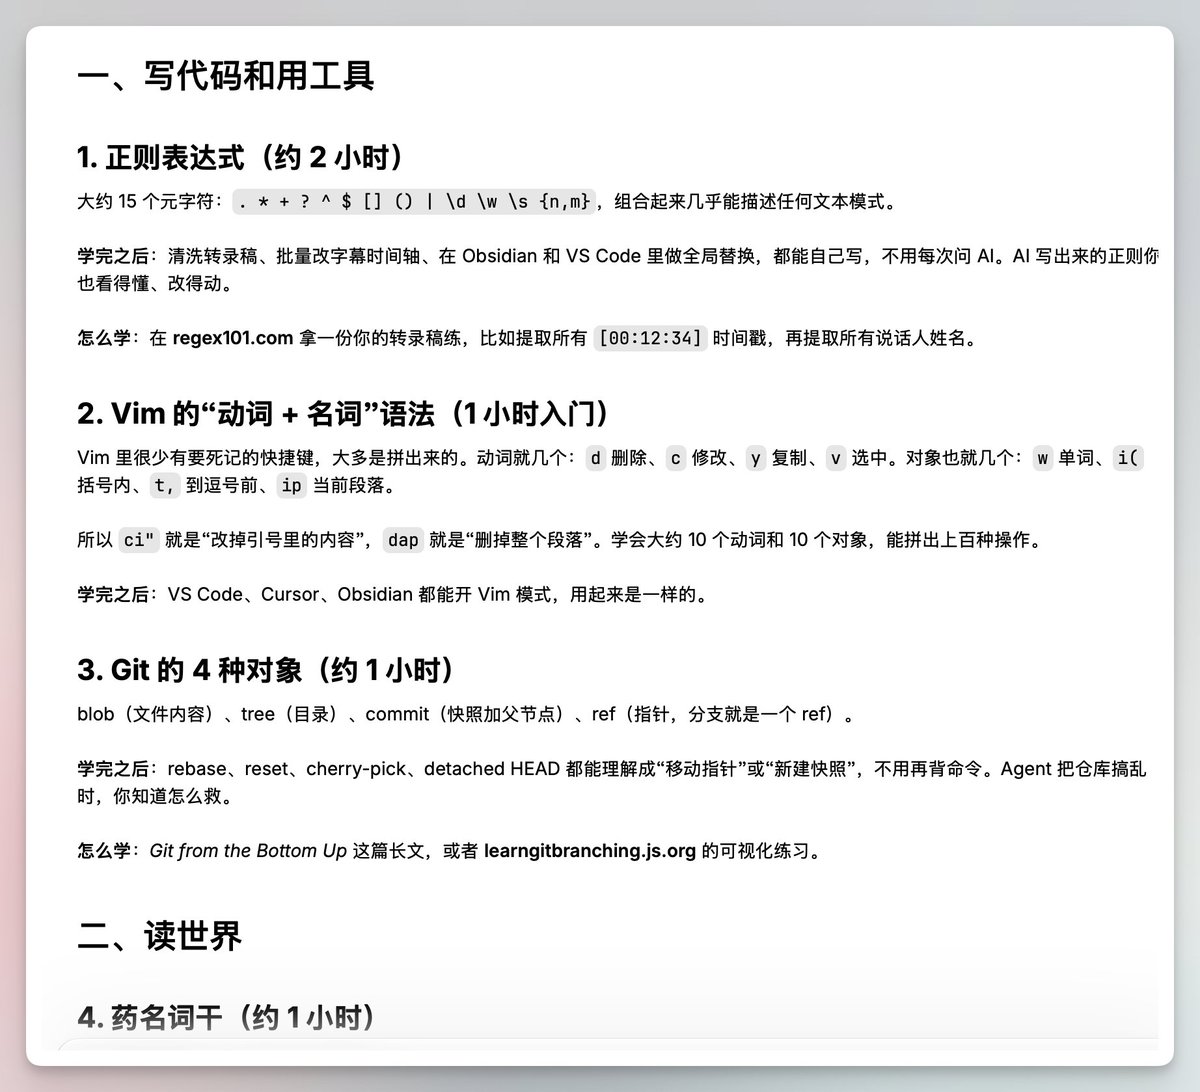
我去,读了网易 LobsterAI 刚刚发布的《中国办公 Agent 用户行为报告》 不少结论太反直觉了,跟 X 上大家 Agent 用法不一样。 比如: ① 微信竟然是最大办公 Agent 入口 ② 办公 Agent 的最大场景还是(泛)编程 ③ 73.6% 普通用户仅用一个模型 下面展开说说: 很多人把办公 Agent 接到微信、飞书、QQ 等 IM 里用,微信占比最高 77%,飞书 14.3%排第二,然后是 QQ。 微信跟国人绑定太紧了,也最顺手,上午 7-11点给 Agent 派活很多,看起来像上班路上用? 交给 Agent 的工作中,泛编程/IT 最多,是最大的使用场景。另外,设计/影视/创作使用量上升飞快,感觉这两大类任务都是模型能力的甜点区。 从报告里看,感觉普通用户不怎么切模型,默认给啥用啥,73.6% 普通用户只用一个模型。 普通用户人均使用 1.6 个模型,重度用户是 2.4 个。 最常见两种组合:DeepSeek Flash 系列 + GLM 5.3 Flash(14.0%),DeepSeek Flash 系列 + V4 Pro(12.4%) 梁圣 DeepSeek 缓存有黑科技,性价比一直超高。 这数据用的是 V4.1 Flash 旧版,新上的 V4.1-Flash-1017 能力又大幅提升,接近GPT 5.6 sol,感觉又要杀疯了。 还有一些有趣的观察,见第二条
向阳乔木 的图片 1
向阳乔木 的图片 2
向阳乔木 的图片 3
向阳乔木 的图片 4
4
13.3万 followers
Views3.0万
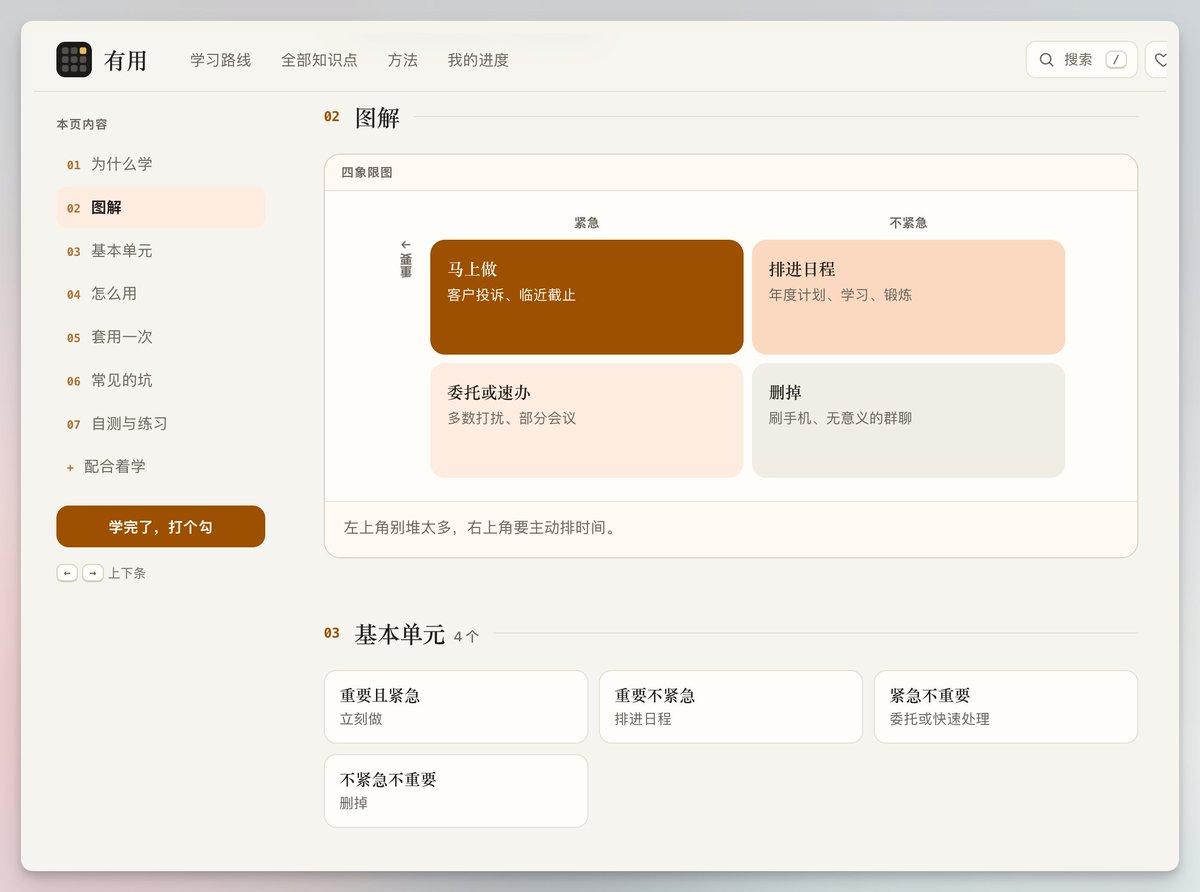
有什么花费时间少,但学会了很有用的知识? 一直追问, Opus 5.5 烦了,给了我个 Prompt,哈哈哈 在【领域】中,找出满足以下条件的知识: 1. 基本单元不超过 50 个 2. 有明确的组合规则,能生成大量新情况 3. 1 天之内能学完 4. 学完后,日常每周至少能用上 1 次 每条给出:基本单元、组合规则、一个能马上验证的练习。
向阳乔木 的图片 1
向阳乔木 的图片 2
向阳乔木 的图片 3
向阳乔木 的图片 4
6
13.3万 followers
Views1.5万
AI 评论太猖狂,必须出手了! 还加了不少小功能,让 X 更好用。 ① 用 Jev 模型识别 AI 评论,支持人工标注手动拉黑。 ② 优化@功能,点赞互动过的朋友,直接插入@,标记待回复,慢慢处理。 ③ 看任何人的精确关注数,是否互关,预测帖子是否能火。 ④ 一键发布 X 文章,自动传图片、视频,节省时间。 还有 X 高级语法搜索,自定义侧边栏,导出书签为 Markdown 等小功能。 做个视频演示下,Github 免费开源,地址见评论区
9
13.3万 followers
Views8.9K
我去,这个大模型有点意思啊! MemT 1.0 :全球首个"记忆原生" 大模型(MoE构架) 现在 ChatGPT 、Claude Codex 都支持记忆,但都记在模型外部(记忆库/对话历史),用时检索注入上下文。 记忆来源于用户要求和对话自动保存,记再多,模型本身不会变,只是能看到更多信息。 MemT 1.0 直接把记忆做到模型内部,写入、保持、更新、读取全纳入模型计算过程。 模型会从用户的交互、指导、反馈纠错中积累经验,变成模型可以学习的能力,实现模型自我反思、进化。 完全是为为 RSI(递归自我改进)铺路啊! ChatGPT 等模型的记忆可类比为 "外挂笔记本",写下来记住,需要时再翻看,记住的是信息。 MemT 1.0 的记忆是更像 "大脑中的经验",从纠错中学,下次就不犯错了,沉淀的是能力。 这好像才是更像人类大脑的长期记忆系统。 第二条论文中的技术解读和实验,感觉这开拓了一个解决记忆问题的新思路,很有价值。
向阳乔木 的图片 1