实践哥 Li

实践哥 Li

@MinLiBuilds最近同步 2026/10/25 00:07:40

🚀 AI Builder|连续创业,折腾不止 ⚡ AI 干货 · 本地大模型 · AI Agent · AI 视频 · AI 产品 🔥 每天与AI 聊25h,尝鲜,探索,洞察,分享,思考🤔 📩 合作: [email protected]

我的微信和服务

7日排名
#751
总粉丝
2.5万
7日涨粉
+822
7日爆帖
3
7日曝光
8.5万
帖均曝光
2.8万

上榜记录

当日上榜实时更新;历史记录保留每日增粉、爆帖、曝光榜前 5 名。点击可查看对应海报。

暂无进入每日前 5 名的上榜记录

粉丝趋势

近7日每日已结算数据

内容表现趋势

曝光/互动与爆帖数均按自然日结算

爆帖趋势

近7日每日爆帖数

帖均曝光趋势

每日总曝光 ÷ 每日爆帖数

参与的话题

共参与 4 个话题

查看话题榜

中文X关于Claude访问限制的讨论,进一步延伸至账号渠道、海外中转与从业者身份的调侃。Rainier以《三体》中云天明传递信息的情节,形容用户设法使用Claude的处境;Ding则抱怨时间线充斥封号经历、防封方法和渠道信息。AB Kuai.Dong将理想中的模型算法研究,与其所描述的多账号运营、逆向分析及赴东京、新加坡部署Mac mini中转作对照。这些帖子延续Claude服务可用性与使用门槛的既有脉络,但主要是个人观察和讽刺表达。候选文字没有提供封号通知、接入配置或服务条款,不能确认相关做法的普遍程度、实际效果及合规性,也不能将其概括为AI行业的整体从业状态。

参与帖子: 🚨 全体起立! 我发现Claude Opus 5.5,不用担心被封的野方法! 居然藏在 Microsoft Word 里! 我试了,真的可以。 🔥 Microsoft 365 Copilot 在9月22日已经接入 Anthropic 旗舰模型 Claude Opus 5.5,直接在 Word 里写文章、改稿、处理长文档。 赢麻了,我的Microsoft 365 Premium 2030年到期,一份订阅最多 6 人使用(自己 + 5 位家庭成员)。 🐮 现在还是主账号可以用AI,微软从10月9日开始,准备逐步把 Copilot AI 权益改成家庭共享。 🚀 看我用Opus 5.5 写番茄炒蛋
参与 1 帖贡献曝光 118万话题热度 4.5万
#Claude#访问限制#账号封禁

中文开发者分享Muse与Grokbot接入本地模型的方案,将个人智能体讨论从跨环境协作延伸至持续运行成本。实践哥Li称,有显卡的用户可通过Tailscale组网,让Muse连接本地Qwen 3.8 Next Flash,并以“5毛钱电费”和“无限token”描述使用体验;可见教程在登录步骤处截断。Lonely随后转发“Muse无限token 2.0”方案,强化本地显卡运行的传播。Go学长则提醒,连Muse都无法注册的网络环境,不宜贸然购买Claude服务。讨论呈现本地推理降低云端额度依赖的期待,也涉及网络可达性门槛,但候选材料没有提供硬件配置、耗电周期或稳定性测试,不能确认所述成本及全天候运行效果。

参与帖子: 🎉 全体起立!有显卡的注意了! Muse/Grokbot真正的无限token来了,只需要5毛钱电费,让它接入本地的Qwen 3.8 Next Flash,爽歪歪啊。 真正的24*7小时干活,终于实现。 步骤极其简单: 1. Muse跟你本地qwen用tailscale组网,跟Muse说:登录tailscale。 2. 跟Muse说:Pi使用 【你的qwen tailscale ip】,access_token是【你的token】,把它当做Pi默认的模型 Muse高富帅之旅,正式开启 🔥
参与 1 帖贡献曝光 29万话题热度 1.3万
#Muse#Grokbot#本地模型

随着OpenAI在开发者活动中发布GPT-6.1及相关智能体功能,社区进一步实测了其Computer Use(电脑操控)在复杂多媒体工作流中的落地表现。多位AI创作者披露,基于GPT-6.1 Sol驱动的Computer Use已能够直接操控Higgsfield等视频创作软件界面,自主完成读取本地素材、调优提示词及跨工具串联等繁重环节。与此同时,开发者在最新版Codex中发现Higgsfield已被内置为独立操作界面,表明OpenAI正加速将编程与桌面客户端打造成贯通第三方创作工具的AI时代超级入口。

参与帖子: 省流,$200 回来了,变 10x。 Tibo 顺手把最肥的一块羊毛也剪了 😂 OpenAI 重新开放 Pro $200。 同时 usage 计算方式也要改。 他自己把话说得很直: 按 API 美元价值算,新 $200 套餐大概只有旧版的一半。 旧 Pro 20x 到底有多离谱? 社区有人真把一整周烧完过: 5.21B tokens,约 $2,000~$2,500 的 API 等价值。 按新口径粗算,大概就剩 $1,000~$1,250/周。🫡
参与 3 帖贡献曝光 15万话题热度 1.1K
#Computer Use#GPT-6.1#Higgsfield

OpenAI在开发者大会发布个人AI助手Dot后正式开放网页端体验,并同步将Codex客户端资料库重构为全新的Space功能,加速推进云端Personal Agent生态落地。实测反馈显示,Dot支持自定义配置并与桌面代码环境联动,但其在Codex内的创建引导与跨端同步体验仍显割裂。与此同时,科技圈发现顶级域名dot.com已被马斯克买下并定向跳转至旗下Grok Bot下载页,引发巨头抢夺下一代智能体流量入口的戏谑与博弈。行业观察指出,随着Meta推出Muse、Manus推出Cue以及OpenAI推出Dot,2026年云端个人智能体赛道正进入大厂全面卡位的新周期。

参与帖子: 服了,差点以为 OpenAI 给我充值 5 倍额度了,成功让我误会了几秒😢 GPT-6.1 Sol只要 Astra 1/5 的价格。 好家伙,额度直接 ×5? 结果一看: 😫GPT-6 Sol 原来就是 $2 / $10 GPT-6.1 Sol 还是 $2 / $10 Astra 是 $10 / $50。 所以这个 1/5,Sol 本来就是。 能力上AA:48 → 52 确实涨了一截。 🔥不过 Sonnet 5.5 还是 56,没想到吧? 20X 用户,不对,是 10X 用户又亏麻了。
参与 1 帖贡献曝光 6.5万话题热度 654
#OpenAI Dot#Codex#Personal Agent

近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

2
2.4万 粉丝
曝光6.9万
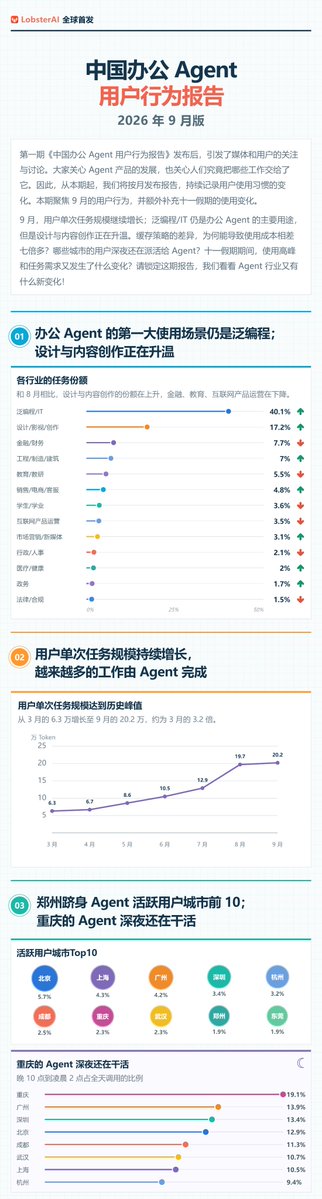
🔥 梁文峰和“梁文谷”,正在影响中国打工人烧 Token 的时间! 网易LobsterAI 最新发布了 9 月《中国办公 Agent 用户行为报告》,几个数据很有意思。 ❶ 模型大战:DeepSeek的份额十分稳定。智谱8月底发布的“牛来”大模型,直接带动9月的调用量环比暴涨 166.7%。 ❷ Token 狂飙:9 月单次任务规模达到 3 月的 3.2 倍,用户正在把越来越复杂的工作交给 Agent。 ❸ 深夜加班:国庆期间,Agent 晚上 10 点最忙!可能是受Deepseek峰谷定价和假期影响,。 ❹ 微信派活:微信已经成为最常用的 IM 派活入口,使用量超过其他 IM 入口之和。 🚀 看到第三条,再来联想一下DeepSeek 的峰谷定价:晚上、周末、法定节假日 API 更便宜。 电脑坐班操作 AI的时代变化了,现在往往结合手机,晚上掏出来,补点活。 从模型跑分到真实任务,从聊天窗口到微信派活,中国用户使用 AI 的习惯正在变化。 Token 不下班。 LobsterAI 这份报告,值得仔细看看。
实践哥 Li 的图片 1
实践哥 Li 的图片 2
实践哥 Li 的图片 3
实践哥 Li 的图片 4
3
2.5万 粉丝
曝光4.5万
😲 厉害了,大模型像人脑那样学习! 今天,MemOS 团队发布 MemT-1.0,一款拥有原生记忆架构的基础大模型。 众所周知,模型一般在训练结束后锁死权重。想让它记住经验,只能靠Harness,塞长上下文、挂 RAG、向量数据库,或者写外部的 Memory 和 Skill。 🔥 MemT 这次,直接把记忆搬进了 Transformer 的计算过程里。 它在模型内部并联了一个可以持续演化的动态记忆矩阵。每次交互结束,模型都会像人脑一样,通过写入、擦除、遗忘三个门控机制,更新这个记忆矩阵。 最有意思的地方来了: 基础模型权重不变,随着使用,模型内部的动态记忆矩阵不断重塑,看起来就是模型越用越聪明。 🤔 论文里的几组实测数据值得关注: ① 越长越有优势、体积恒定:在 Nano 版上,无论历史交互是 128K 还是 1M Token,单会话记忆矩阵永远只占 40 MiB。相当于一张高清图的大小。在 128K 历史下,端到端推理速度比全上下文提升 1.86 倍,持久化存储暴降 66 倍。 ② 长文本优势明显:到了 256K 历史下,端到端推理速度直接提升 3.99 倍,首字延迟(TTFT)稳定在 100ms。 ③ 把经验变成“肌肉记忆”:在 SWE-bench Verified 编程实验中,把过往修 Bug 的流程经验写进这个记忆矩阵后(不占上下文),Coding Agent 连续三次全部通关(pass^3)的稳定性从 54.0% 飙升到 62.8%。 🚀 他们是怎么做到的? 整个训练过程,基础模型冻结不动,团队训练了一个超轻量 Hyper Memory(超记忆参数),Nano 版�� 0.45B,Flash 版约 3.6B。这组权重相当于模型的记忆读写控制器,每次推理过程中会对40 MiB(Nano 版) 的动态记忆矩阵执行读写操作。 最有意思的是这个方向。以前大模型出厂即巅峰,拼命卷算力。现在,这些模型竟然可以自我进化了。 试想一下:如果未来打通了基础模型权重和动态记忆权重的转化,一个 AI 每天工作 8 小时,在自己的记忆矩阵里不断试错、擦除、沉淀,连续干上一年。那时候的它,和刚部署第一天的自己,还会是同一个物种吗? 📄官号 @MemOS_dev ,开源与论文:https://t.co/wWBYvTbiIF