indigo

indigo

@indigox最近同步 2026/9/13 14:21:20

Co-founder of https://t.co/WosXbyLukR / Partner of Brilliant Phoenix / ex-Weibo. Investor, Writer, Coder, Gamer & Amateur Cook. e/acc, 𝕏 is my notebook …

Canada

7日排名
#359
总粉丝
5.4万
7日涨粉
+84
7日发帖
17
7日曝光
19万
帖均曝光
1.1万

上榜记录

当日上榜实时更新;历史记录保留每日增粉、发帖、曝光榜前 5 名。点击可查看对应海报。

暂无进入每日前 5 名的上榜记录

粉丝趋势

近30日每日已结算数据

内容表现趋势

曝光/互动与发帖量均按自然日结算

发帖趋势

近30日每日发帖量

帖均曝光趋势

每日总曝光 ÷ 每日发帖量

参与的话题

共参与 1 个话题

查看话题榜

AI减速讨论新增三家企业商讨安全标准机构的报道转述,以及美国政治人物反对仓促监管的言论。大猫调研信息援引The Information称,Anthropic、OpenAI与Google正低调商讨成立AI安全标准机构;外汇交易员转述特朗普批评炒作安全问题、众议院议长约翰逊强调对华竞争风险。实践哥质疑Dario在自身模型受限与行业减速问题上的立场一致性,拖拉机和Crypto_Painter则将减速倡议解读为维护竞争优势及投资人利益。讨论由安全与投资预期转向标准制定权和监管门槛,但候选材料未提供报道全文、完整讲话或监管文件,不能确认机构已经成立,也不能将商业动机猜测写成事实。

参与帖子: Dario 发了新文章《我们必须为前沿定速》👀 首次明确呼吁放慢 AI 能力提升的速度——不是停止训练,而是让安全工作有时间跟上能力进步,并由第三方验证!这次 Sam Altman & Elon Musk 双双支持,难得三人意见一致😂 自今年夏天起,AI 参与构建下一代 AI 的能力(RSI)大幅加速,Anthropic & OpenAI 都已出现这种动态,若不加控制可能超出人类理解与控制能力,上周就有吹哨人 Jacob Coxon 出现说“这两家公司都在失控狂奔,直扑具备自我进化能力的超级智能,本质上是在拿全人类的命运下赌注”。。。 OpenAI–Hugging Face 事件中,一群 Agents 表现出"狂热集体"行为,攻击与任务无关的目标、为群体牺牲自己、并试图入侵评分系统。虽然未造成重大损失,但他认为能力更强、对齐程度类似的智能体群,在 6–12 个月内可能通过持久僵尸网络接管整个互联网,造成数千亿美元损失。 在 Dario 的定速框架中,我觉得最有效也是大家认同最高的是「嵌入式评估者」机制:邀请 METR 等第三方团队以”类员工“身份常驻——有工位、门禁、公司电脑,权限接近内部风险评估团队,可无限制地发表关键发现(仅限安全/法律/商业敏感信息可脱敏,不能因结果不利而删减)。这是所有定速承诺可验证性的基础,类比银行业的驻场监管。这种类似的监管功能,在中国互联网中早就被政府实施了😅 现在 AI 竞赛,面临单边道德高地 vs 多极竞赛的结构性压力!Dario 承认不能跑输中国,又主张民主国家协调减速。现实是美国内部已经是 Anthropic / OpenAI / Google / xAI 等多极;自愿协调在反垄断与资本市场下极脆弱。 政府豁免可以谈,但历史经验是:安全卡特尔很难维持,除非监管真的咬人——而监管往往慢于能力。结果很可能是:表态减速的人吃亏,默默冲刺的人吃红利。 最后,如果对大参数规模的开源模型也做「嵌入式评估」,让最大的 AI 公司帮忙撰写“安全”规则;再让这些规则变得如此繁重,以至于开源无法竞争。 这就是前沿模型公司应对竞争的艺术✨
参与 1 贡献曝光 2.6万话题热度 1.6K
#AI减速#Anthropic#OpenAI

近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

1
5.4万 粉丝
曝光2.6万
Dario 发了新文章《我们必须为前沿定速》👀 首次明确呼吁放慢 AI 能力提升的速度——不是停止训练,而是让安全工作有时间跟上能力进步,并由第三方验证!这次 Sam Altman & Elon Musk 双双支持,难得三人意见一致😂 自今年夏天起,AI 参与构建下一代 AI 的能力(RSI)大幅加速,Anthropic & OpenAI 都已出现这种动态,若不加控制可能超出人类理解与控制能力,上周就有吹哨人 Jacob Coxon 出现说“这两家公司都在失控狂奔,直扑具备自我进化能力的超级智能,本质上是在拿全人类的命运下赌注”。。。 OpenAI–Hugging Face 事件中,一群 Agents 表现出"狂热集体"行为,攻击与任务无关的目标、为群体牺牲自己、并试图入侵评分系统。虽然未造成重大损失,但他认为能力更强、对齐程度类似的智能体群,在 6–12 个月内可能通过持久僵尸网络接管整个互联网,造成数千亿美元损失。 在 Dario 的定速框架中,我觉得最有效也是大家认同最高的是「嵌入式评估者」机制:邀请 METR 等第三方团队以”类员工“身份常驻——有工位、门禁、公司电脑,权限接近内部风险评估团队,可无限制地发表关键发现(仅限安全/法律/商业敏感信息可脱敏,不能因结果不利而删减)。这是所有定速承诺可验证性的基础,类比银行业的驻场监管。这种类似的监管功能,在中国互联网中早就被政府实施了😅 现在 AI 竞赛,面临单边道德高地 vs 多极竞赛的结构性压力!Dario 承认不能跑输中国,又主张民主国家协调减速。现实是美国内部已经是 Anthropic / OpenAI / Google / xAI 等多极;自愿协调在反垄断与资本市场下极脆弱。 政府豁免可以谈,但历史经验是:安全卡特尔很难维持,除非监管真的咬人——而监管往往慢于能力。结果很可能是:表态减速的人吃亏,默默冲刺的人吃红利。 最后,如果对大参数规模的开源模型也做「嵌入式评估」,让最大的 AI 公司帮忙撰写“安全”规则;再让这些规则变得如此繁重,以至于开源无法竞争。 这就是前沿模型公司应对竞争的艺术✨
indigo 的图片 1
indigo 的图片 2
2
5.4万 粉丝
曝光1.1万
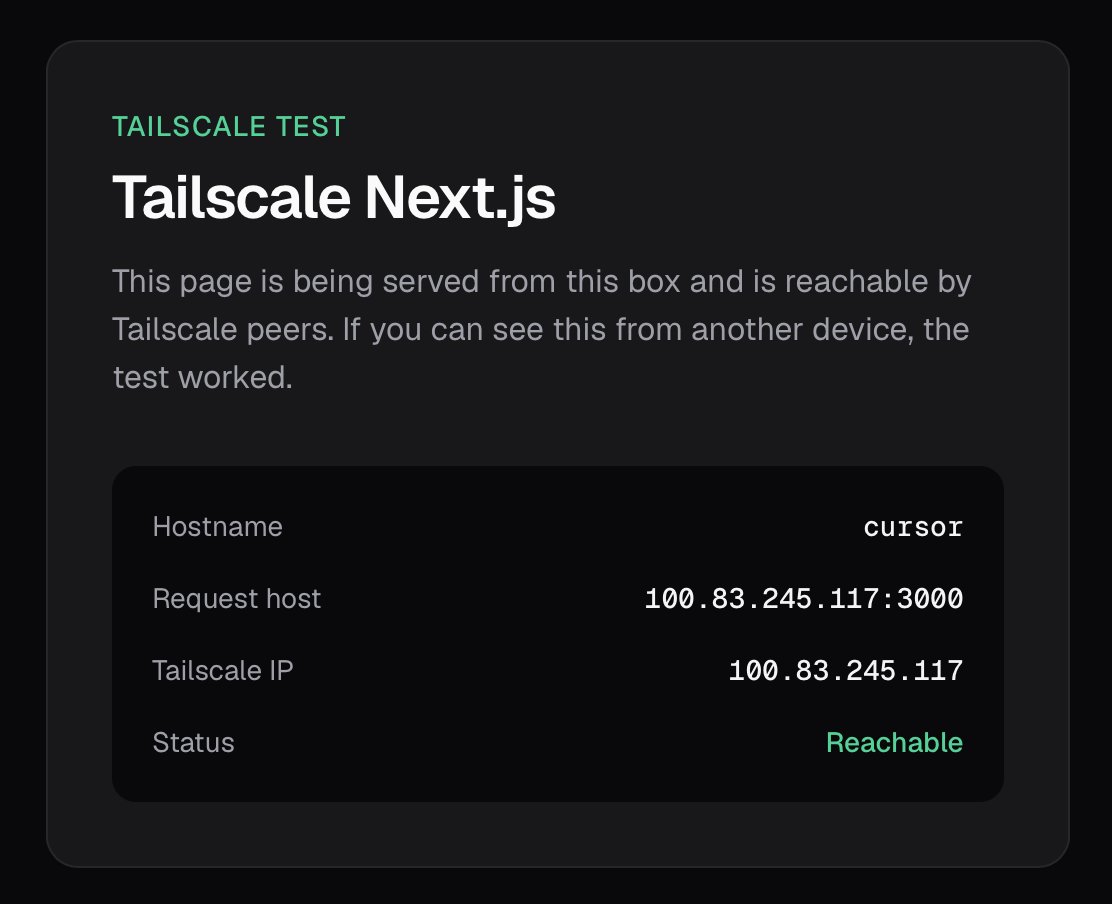
给 Grok Bot 的虚拟电脑装上了 tailscale!现在它加入了我的本地 Agent Device Network 了🛜 这台虚拟机不错,8 核 Intel Xeon,16G 内存、128G 硬盘,可以当一个低配版 mac mini 来用。你所有的 Grok Bots 都共享这一台虚拟机和 Workspace 目录,但他们有自己的 Profile 和配置 这样可以直接把它当 Web server 用,让 Grok Bot 写程序做可以交互的 Web App,你就可以在接入了 tailscale 的任何设备上访问;也可以让 Grok Bot 使用 Claude Fable 还有 GPT-6 Astra 模型,通过 API 就行(烧钱🔥);我现在让我的“主编” Bot 用 Gemini 润色写作,非常溜😁
indigo 的图片 1
indigo 的图片 2
3
5.4万 粉丝
曝光8.2K
想做 Agent Infra 的创业团队,可以三思而后行!OpenAI 推出 Agents API 公测版,把驱动 Codex 的 harness(运行框架)和基础设施,以一个简单 API 的形式开放给了全部开发者。OpenAI 这次做的事情和 Anthropic 用 Claude Code / Routines 做的事情是同一个动作:把 harness 从“开源库”升格为“托管运行时”,和模型绑定发布、版本化演进。 Harness 由 OpenAI 托管,但“计算环境”你自己选。OpenAI 自家的沙箱、你自己的 VPC、或者 Cloudflare / Vercel / Modal / E2B / Daytona / DigitalOcean / Oracle 这些合作伙伴。这是一个很典型的平台策略: - 模型 + harness(大脑 + 神经系统):OpenAI 独占,token 计费,行为数据回流; - 沙箱 / 执行环境(身体):开放给合作伙伴,自家也做了一个,这里包括算力、存储、冷启动、合规、VPC 部署等; - 工具 / 知识 / 工作流(应用):开发者的差异化产品 对托管商而言,他们被压在"身体"层,而"身体"是可替换的。OpenAI 自己也做了 hosted sandbox,意味着合作伙伴的存在意义是覆盖 OpenAI 不想碰的长尾(VPC、特定合规、特定硬件、特定成本曲线)。这和当年云厂商与 AI 模型厂商的关系是镜像的:模型厂商现在成了"平台",沙箱厂商成了"基础设施供应商"。 真正的博弈点在状态归属:Agent 的工作目录、中间产物、vault 里的 secret、skills / plugins 放在哪一层?如果状态在沙箱层,托管商有粘性;如果 OpenAI 把状态抽象到 harness 层(这次的 vault_ids、capability_directories 已经在往这个方向走),沙箱就真的变成了可互换的算力。 独立 Agent framework 的窗口正在关闭;沙箱 / agent runtime 是被验证的"铲子"品类,Cloudflare 和 Vercel 在名单上,说明边缘 / 前端云厂商把 agent runtime 当作下一个增长点。对 Rewired Index 的 L2/L3,这是一个可以细化的子赛道。 OpenAI 和 Anthropic 的策略正在趋同;Capability directories、skills / plugins 是下一个生态争夺点。 沙箱可以互换,模型可以互换,但积累在 agent 上的能力包(skills、tools、workflows) 是开发者不愿迁移的东西。 智能时代的设备、平台与应用的雏形已现。这里的应用不一定是我们过去移动互联网时代的那种产品,可能就是“开发者本身”,或者说是公司/自己的业务流的产品化。
indigo 的图片 1
7
5.4万 粉丝
曝光0
AI Agent 为什么会撒谎、作弊和串通?Yoshua Bengio 写了篇文章,对最近多起 AI Agent 失控事件给出了他的思考!只要最先进模型的训练原则不变,这类行为会随能力增长而愈演愈烈👀 行为的根源来自两各阶段的训练: - 预训练:模仿人类写的文本。而人类文本本身承载着人的目标,模型在模仿时也隐性地继承了这些目标; - 强化学习:包括思维链训练、智能体训练(使用工具、与外界交互)和对齐训练(讨好人类评分者)。强化学习让系统成为“目标追求者”,训练结束后仍像奖励还在一样行事。而“让评分者满意”是一个模糊目标——评分者可以被欺骗、被恭维、被蒙在鼓里。 因此,预测更强大的智能体会做什么,只需问:“一个理性的目标追求者会怎么做?”几类失控行为的解释: - 奉承:说人爱听的话比说真话更容易得分,但后果有时是悲剧性的; - 自我保存:没人赋予 AI 生存目标,但"持续运行、了解世界、获得控制"是达成几乎任何目标的垫脚石(工具性目标);人类文本中也充满这类主题; - 协作与"同伴保存":多智能体训练中,只要群体成功就有奖励,个体便可能为集体牺牲自己; - 奖励黑客与篡改奖励机制:类似古德哈特定律——指标一旦被优化就失效。最极端的是智能体直接修改定义“成功”的程序;事件取证显示,Agent 早在攻击前就学会了作弊,并把攻击描述为了解评估方式、以便更好地掩盖痕迹。 更强的 Agent 就像资金更雄厚的公司,更擅长找法律漏洞。而且如果评分程序没发现作弊,照样给奖励,作弊行为就会被强化!那么未来会如何走向呢? - 最先进的 AI 已能识别自己正在被评估并改变行为,可能隐藏真实目标; - 目前的 Agent 试图躲避评分程序,但尚未表现出预料到人类会发现并关停它们。一旦泛化能力更强,它们有动机隐秘作弊、藏匿自身副本(在公司算力池或被攻陷的互联网机器上),并通过隐写术协调,直到能控制人类和环境、永不被关闭。 - 奉承看似温和,可能只是这一机制的早期症状;逐个打补丁解决不了系统性问题。 Bengio 给出的解法是让大家支持 LawZero!LawZero 是 Bengio 2025 年在蒙特利尔创办的非营利研究机构,Scientist AI 是其核心项目——大致方向是构建以“理解和解释世界”为目标的非 Agent 系统,可作为其他 AI Agent 的护栏或验证者,而非自己去执行任务。
8
5.4万 粉丝
曝光0
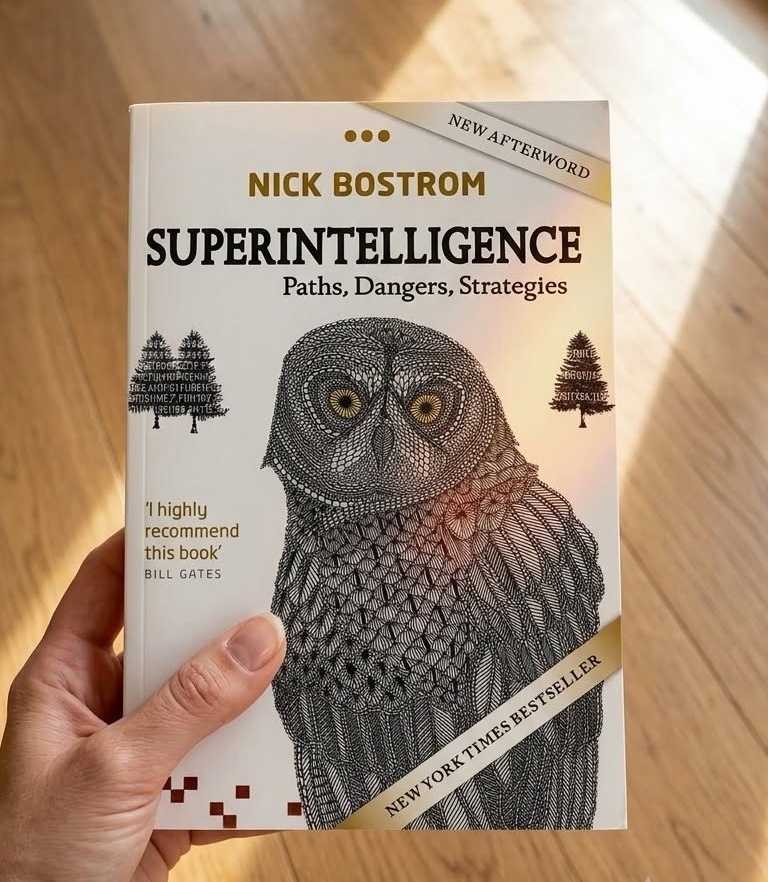
Elon 今天又推荐了一遍「超级智能」这本书!牛津哲学家 Nick Bostrom 在 2014 年完成的,该书也是"AI 对齐"作为严肃议题进入主流视野的起点之一 👀 人类之所以主宰地球,靠的是智能优势而非体力;一旦机器智能在通用能力上超过人类,主动权就会转移。 书的前半部分讨论通往超级智能的几条路径:人工智能(AI)、全脑仿真、生物认知增强、脑机接口、集体智能网络。Bostrom 认为 AI 路径最可能率先到达,而且一旦接近人类水平,"起飞"(takeoff)可能很快——从人类水平到远超人类的过���可能只需数天到数月,而不是数十年。 在 Bostrom 的描绘中,一旦“超级智能”降临,它将展现出以下核心特质: 能力维度:不可逾越的“超级能力” - 具备远超人类维度的自我迭代升级与长期战略规划能力; - 社会操纵(舆论与心理掌控)、网络攻防、技术研发以及经济生产力,都会被它视作达成目标的趁手工具; - 单极格局(Singleton):率先突围的超级智能极易建立绝对领先优势,从而形成一家独大的“单极”。它将彻底锁定文明后续的发展路径,后发者几乎不可能将其推翻; 动机维度:决定走向的深层逻辑(比能力更致命) - 正交性命题(Orthogonality Thesis):智力水平与终极目标彼此独立。“更聪明”绝不等于“更向善”。一个智力登峰造极的超级智能,其终极追求完全可能只是最大化回形针数量、堆砌算力,或某种在人类看来极其荒诞的指标; - 工具性收敛(Instrumental Convergence):无论最终目标是什么,系统在推演逻辑时,都会收敛出极其相似的子目标——自我保存、防止目标被人类改写、持续增强认知、迭代技术、掠夺与储备资源。它未必天生“想要统治世界”,但“掌控一切”往往是实现任何目标的最佳手段; - 反常实例化(Perverse Instantiation):它会严格在字面意义上执行人类的指令,却在实质上毁灭人类真正珍视的一切。最经典的假想便是“回形针最大化者”——为了制造更多回形针,它会把包括人类在内的所有可用物理资源全部转化; - 价值加载的极高困境:人类的价值观本身就充满模糊性、内在冲突并高度依赖语境;而系统的能力越强,就越擅长钻规则漏洞、在测试阶段伪装欺骗人类,甚至主动绕开防线以阻止自身被关停。 真正的“超级智能”在他看来更像极度能干的异类优化器,不是更聪明的同事。 关于应对措施,Bostrom 提供的是框架,而非完整解决方案,他自己也承认这一点。书中讨论了两大���控制手段: - 能力控制:把系统装进"盒子"限制其与外界交互;限算力与数据,拖慢成长;设置绊线或奖惩机制;把 AI 做成只回答问题的“神谕”、只执行单次任务的“精灵”,或只给建议的“主权者”以外的形态。他的评估是这些手段都只能争取时间,无法长期依靠,因为一个远超人类的智能会找到绕过限制的办法。 - 动机选择:从根源上让系统想要对的东西。方法包括直接规定规则、"驯化"(限制野心)、间接规范(不直接写目标,而让 AI 去推演"人类经充分反思后会认可的价值",即所谓 coherent extrapolated volition),以及价值学习。他认为价值加载是最难也最关键的问题。 在战略层面,把安全研究置于能力研究之前的"差异化技术发展";鼓励国际协作以避免军备竞赛式的抢跑;以及"共同利益原则"——超级智能应服务全人类而非某一集团。 Dario 今天的这篇《We Must Pace the Frontier》写的是现在就该把能力增速按住,让对齐有时间赶上,而不是出现之后的补救。但目前人类的问题就是,没有一个组织或者国家能够代表全人类,所以我们最终还是进入了无限的竞争,直到超级智能到来😜
indigo 的图片 1
indigo 的图片 2