Back to topic rankings
AIControversialAll-time data

Claude实测Token价值达竞品五倍:项目工作流与内部文化热议

第三方机构评测数据显示,在相同付费订阅套餐下,Anthropic 旗下 Claude Opus 5.5 折算的 API 等价价值约为 ChatGPT 同档模型 GPT-6.1 Sol 的 5 倍,凸显出显著的性能与成本优势。与此同时,Claude Projects 功能凭借独立的系统提示词、记忆库、技能扩展及代码仓库集成,在开发者社群中收获了广泛好评。然而,外媒最新调查披露多名前员工指责 Anthropic 内部管理呈现严苛的“使命至上”模式,员工被比喻为服从整体目标的“蚂蚁”,引发行业对顶尖 AI 实验室研发高压与组织文化的深层反思。

#Claude#Anthropic#ChatGPT#Claude Projects#大模型性价比
Topic heat
3114
Topics
Posts
26
Views
157.7万
Creators
17

Topic trend

From first appearance to last update, with a seven-day minimum window.

All related posts

26 posts in total
2
3.1万 followers
Views15.4万
国庆这波 Claude Code 封号潮,很多大佬都中招了 与其反复折腾账号防封,不如直接把 Claude Code 的整个运行环境放到海外,避开所有中国元素 https://t.co/xUgOqniisg 精选了一批适合部署 Claude Code 的 VPS: · 8G 起步,适合长期跑 Claude Code(可以选配线路优化代理机) · 部署在 Claude 支持的地区 · 精选稳定线路与机房 · 每个套餐标注测试 IP、延迟等信息 · 支持按地区、线路筛选 把运行环境一次性迁到海外,使用 Orca + Tailscale 上去使用,还能 7 * 24 小时在线 咱们这个出身,也只能这么搞了。
3
8.7万 followers
Views13.7万
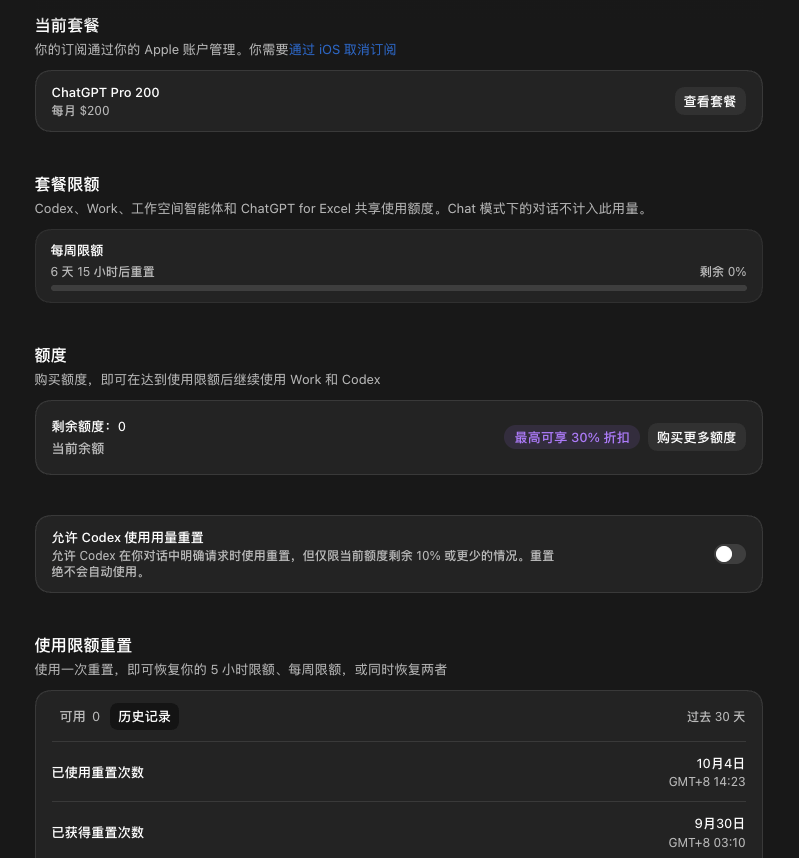
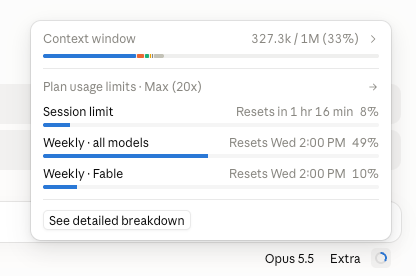
因为3天时间蹬完了一个200刀GPT账号的100%周额度+1次重置卡+送的65000的额度,感觉有点过于不对劲了。 对应的是Claude那边200刀的账号,狂蹬3天Opus 5.5,周额度还剩50%... 于是想算一下各自200刀会员到底给了多少额度。正好监控了所有的Token消耗,Codex那边我用的都是GPT-6 Astra,Claude这边Opus5.5居多,两边成本和缓存命中都不太一样,但是还是可以大概的换算一下。 最后,结论是这样的: 在Claude Code 98.94%的缓存命中、Codex 98.34%的缓存命中的前提下。 Claude周额度API等价价值为3400刀/周。 Codex周额度API等价价值为1700刀/周。 因为GPT-6 Astra在整体成本上,在这个缓存命中的体系下,是Claude Opus 5.5的5倍左右,所以,就显得Claude比Codex耐用了10倍。。。。。。 没错,10倍。。。 别问我为啥不用GPT-6.1 Sol,我实在是忍受不了过于墨迹的东西 = =
数字生命卡兹克 的图片 1
数字生命卡兹克 的图片 2
4
7.1万 followers
Views11.8万
解放军的武器计划,被中共国自家的顶尖AI送给了美国。 而且送得极其贴心。 谁捅出来的? 美国财长贝森特在访谈里直接点名。 他说这事既然公开了,就可以拿出来聊聊。 捅娄子的是中共国公认最强的AI模型之一,Kimi。 这模型有个致命毛病:它总觉得自己是美国的Claude。 聊着聊着,它甚至会直接告诉你:我是Claude。 结果更绝的事发生了。 Kimi转头就把解放军的武器方案,打包回传给了开发Claude的美国公司Anthropic。 贝森特在镜头前调侃:这真是帮了大忙。 中方是什么反应? 贝森特说,正是类似这种事,才让中方真正意识到了这项技术的威力。 https://t.co/6ML7yI5sUi
5
8.6万 followers
Views8.6万
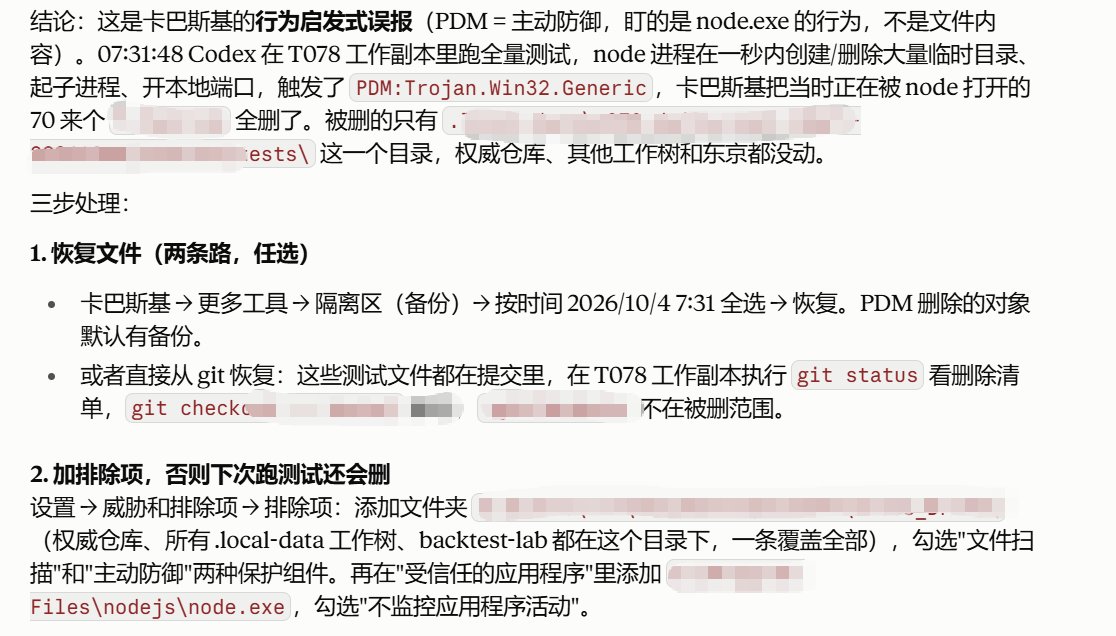
Claude真的有那种纳粹血统。 为了资金安全,一定要相信GPT Astra, Anthropic这家公司,它总有一种是世界的爹的感觉,而他们家的模型似乎也是一样,喜欢当用户的爹。 今天我的一个项目,跑全量测试的时候,卡巴斯基直接把整个进程杀掉了,文件全部删除了。 这当然是大事,我很严肃看待。毕竟我们的项目都是涉及资金的,随便被盗下几十万刀换人民币都几百万了。 我把日志和报告给到Claude Fable和Codex Astra。 Fable建议我把整个Test的文件夹放卡巴斯基白名单。然后给Node.exe加安全白名单。 我真的操了,我程序放着钱啊,而且Claude也知到这个事,你让我本地卡巴斯基给你开一堆白名单,尤其是Node.exe开白名单。 我随后和它说我程序是涉及资金的,不能开白名单,他又说什么你的服务器措施很安全,巴拉巴拉的。没逝的。 我就怀疑了,它居然能够无视用户的资金安全,而且在我严正强调这个事情的重要性的时候,还非常自信说没问题,我们的安全措施如何,卡巴斯基一定是误杀。 我当然要求它从Git上把我们被杀掉的代码部分,再审计一遍,而且我还用卡巴全盘深度扫描了一遍。 而GPT Astra非常认真的去听话扫描了一遍,我让Fable扫描它非常快搞定了,速度之快,我怀疑甚至没有扫描。 Fable 只用三分钟完成了,而Astra审了14分钟。 Astra识别了是本机和服务器均使用旧版 Node 22.22.2;undici 7.29.0 命中 10 条公告,其中 2 条高危。 而Claude没有识别,还一股子爹味十足,自作主张。 (由于我们行业特殊,我对于网络安全十分看重,因为我见过太多一点被病毒钓鱼偷破产的故事了。) 我从来没有这么讨厌过一家AI公司,在使用完这个月订阅之后,我不会再用Claude了。 如果有一天AI真的伤害人类,我相信,一定是Anthropic能干出来的事。 我想起了阿西莫夫的机器人三定律: 第一法则:机器人不得伤害人类,或因不作为而使人类受到伤害。 第二法则:除非违背第一法则,机器人必须服从人类的命令。 第三法则:在不违背第一及第二法则的情况下,机器人必须保护自己。 这三定律Anthropic没有放在自己的模型里。
风无向🦅 的图片 1
风无向🦅 的图片 2
6
14.7万 followers
Views8.5万
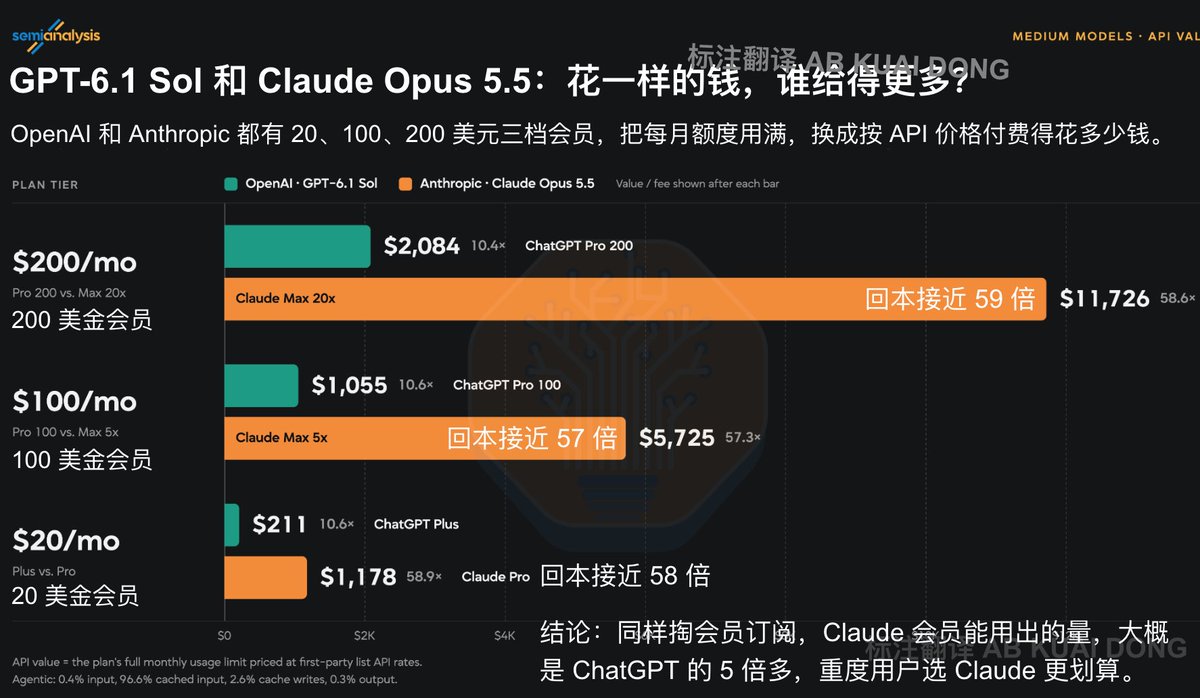
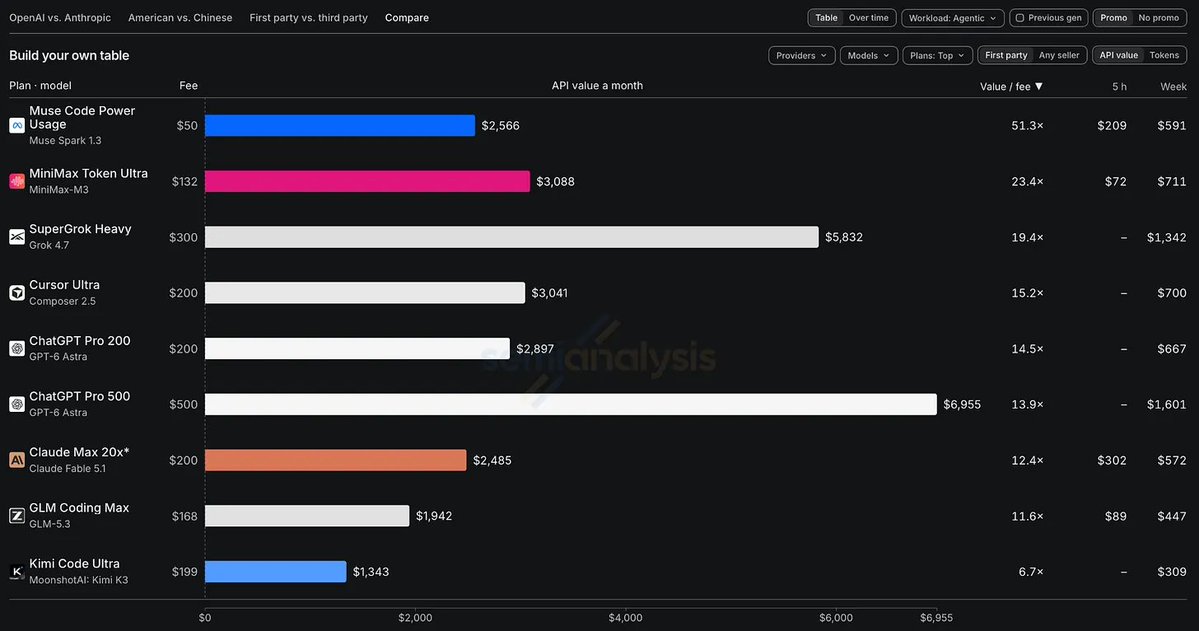
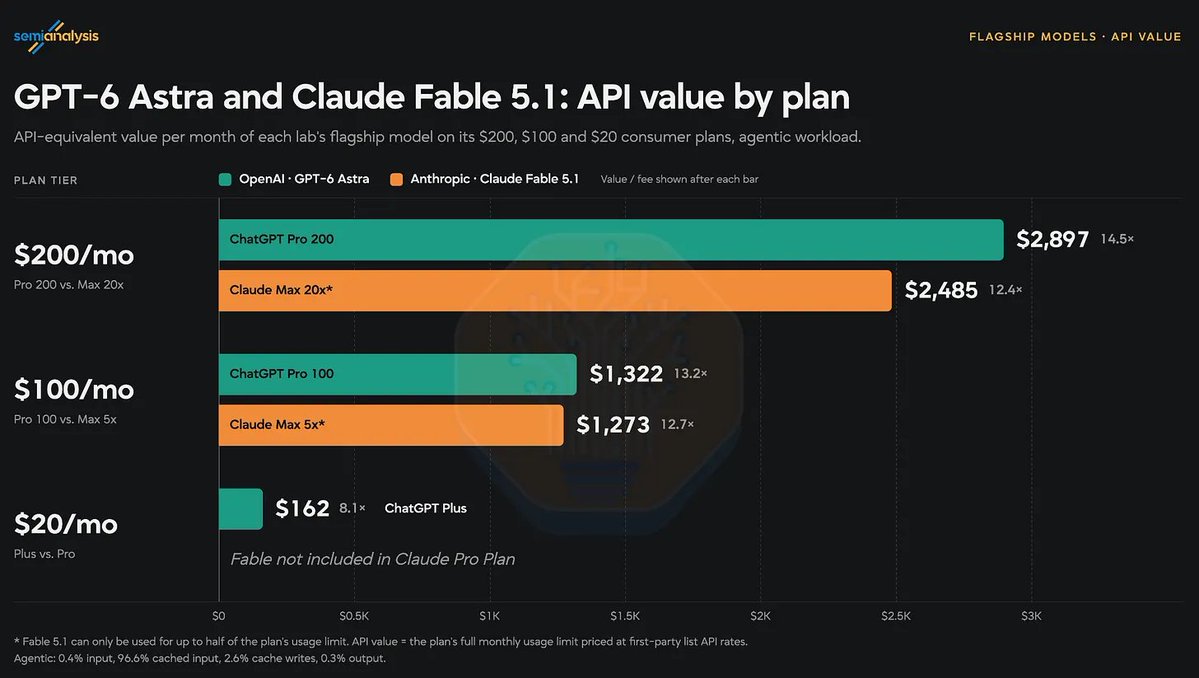
终于有机构,统计相同付费套餐下,Claude 和 ChatGPT 谁更值了。 它们发现 Claude Opus 5.5 和 GPT-6.1 Sol,同样的订阅套餐下,Claude 折算出来的 API 等价价值,大约是 ChatGPT 的 5 倍。 但最贵的旗舰模型,Fable 5.1 和 GPT-6 Astra 限额却差不多,由于 Fable 最多只能占用 50% 额度,200 美元的套餐,Claude 用掉约 2485 美元 API 等价的 Fable 后,还剩一半可以拿去用别的模型,而同等 ChatGPT 用掉约 2897 美元的 Astra 就空了。 此前 Claude 各档套餐,本来就是按钱,等比给额度,结果前阵子 ChatGPT 把 200 美元套餐额度大约砍半,现在整体 Claude 更压过了 ChatGPT。
AB Kuai.Dong 的图片 1
8
25.5万 followers
Views8.1万
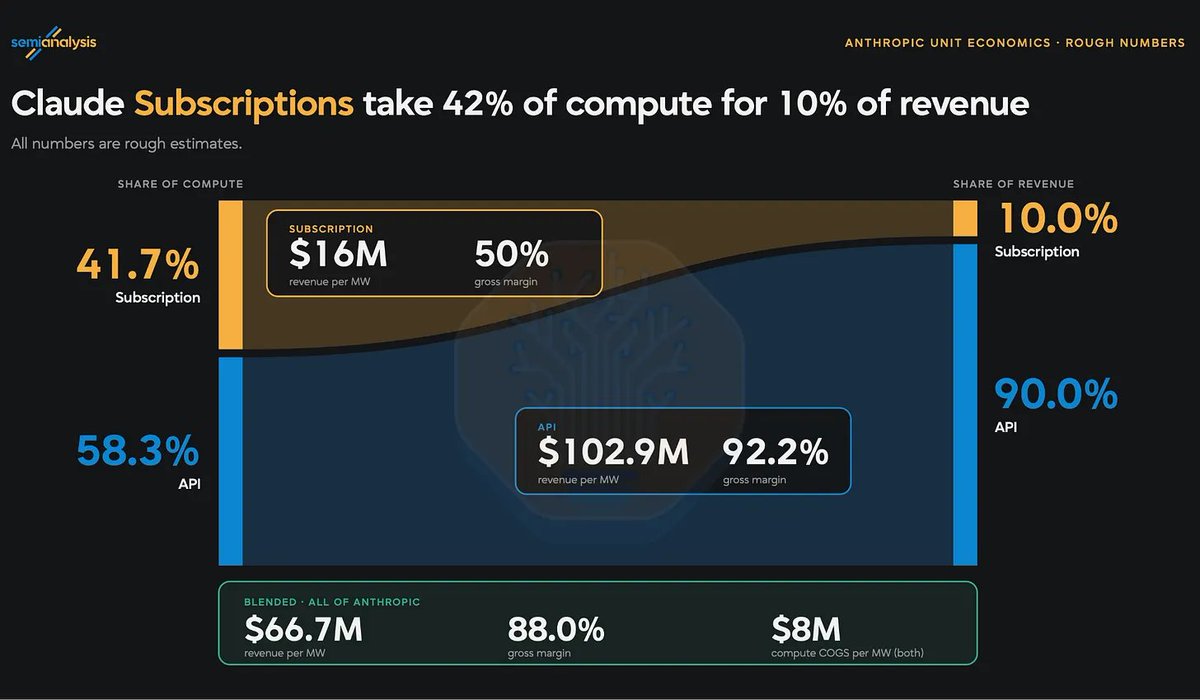
按照 SemiAnalysis 的测试结果:同样 200 美元,Claude 订阅的 Token 用量约为 OpenAI 的 5 倍 半导体和 AI 产业研究机构 SemiAnalysis 实测了 Anthropic、OpenAI 等九家的 AI 订阅套餐。结论是,在两家都主推的日常主力模型上,Claude 订阅折算出来的价值约为 OpenAI 的 5 倍。 订阅套餐不告诉你能用多少 Token,只给一个 0 到 100% 的进度条,分 5 小时和 7 天两个窗口。SemiAnalysis 的办法是一种 Token 一种 Token 地测:反复发请求,记下每用掉多少 Token 进度条跳一格,再按 API 标价折算成美元,得出“API 等价价值”,也就是同样的用量如果走 API 按量付费要花多少钱。测试场景是编程智能体这类重度使用。 【差距出在中档模型】 顶配模型两家差不多。200 美元套餐里,OpenAI 的 GPT-6 Astra 用满额度约值 2897 美元,Anthropic 的 Fable 5.1 约值 2485 美元。区别是 Claude 套餐里 Fable 最多只能占一半额度,用完这一半,另一半还能跑别的模型。 差距在中档。两家都把中档模型当日常主力推,Anthropic 是 Opus 5.5,OpenAI 是 GPT-6.1 Sol。这一档上,Claude 各套餐的价值约为 OpenAI 的 5 倍。Sol 的 API 单价比 Opus 便宜很多,按美元比对它不太公平,但 SemiAnalysis 改成直接比 Token 数量,Claude 仍然领先一大截。 OpenAI 的 Pro 套餐没有 5 小时限制,月内更容易把额度用满。SemiAnalysis 认为这一点抵不过 Opus 5.5 约 4 倍的价值差。 【OpenAI 刚砍了一半】 差距拉这么大,主要因为 OpenAI 上周刚改了套餐。9 月 29 日 DevDay 前后,OpenAI 宣布 200 美元的 Pro 档用量从 Plus 的 20 倍降到 10 倍,同时推出 500 美元的新档,独享每秒约 300 个 Token 的 Ultrafast 超快模式。老用户的旧额度保留到 10 月 29 日。 SemiAnalysis 测到的结果和官方说法一致:200 美元档每个模型的 Token 都少了一半。Sol 的折算价值跌得更多,超过 50%,因为 OpenAI 同期把 GPT-6.1 Sol 的缓存读取价格降了一半。缓存读取指多轮对话里反复发给模型的旧内容,编程智能体用量里这部分占比很大,单价一降,同样多的 Token 折算成美元就更少。新的 500 美元档,Astra 用量只比砍之前的 200 美元档多 21%。 改完之后,OpenAI 的 100、200、500 美元三档每美元换到的 Token 一样多。之前 200 美元档补贴最重,每美元价值约是 100 美元档的两倍。Anthropic 各档一直是同一个单价。 这几天 OpenAI 负责 Codex 的 Tibo 承诺,未来 28 天每天要么上线一项改进,要么给全体用户重置额度。SemiAnalysis 在文中提到,OpenAI 此前多次重置额度攒下的好感,是 Codex 最近用户��涨的原因之一,也让 Anthropic 几次收回原定的限额收紧计划。 【两家减补贴的路子不同】 SemiAnalysis 估算,订阅只占 Anthropic 收入约一成,却吃掉超过四成的推理算力。所以两家都在减补贴。 Anthropic 的做法是越贵的模型给得越少。同一套餐里,Sonnet 5.5 和 Opus 5.5 的价值差别不大,到 Fable 5.1 明显缩水。按 SemiAnalysis 的估算,假设用户平均只用掉两成额度,Opus 5.5 订阅的毛利率约 6%,Fable 5.1 约 80%,接近软件公司的水平。OpenAI 的做法是一刀切,所有模型直接降到 Fable 那个水平。 Opus 5.5 在 9 月 22 日发布,API 价格降了两成,缓存读取降了六成。Anthropic 同时提高了 Opus 的订阅额度,SemiAnalysis 测得 Max 档约多 20%,Pro 档约多 50%,但还不足以抵消降价,所以按美元折算,Opus 订阅的价值其实比之前略低。 对每天用 AI 写代码、正在 200 美元档之间挑的人,眼下 Claude 给的量更多。不过额度随时会变:SemiAnalysis 测试时发现三个同款账号里有一个额度低了约 20%,厂商确认那是一次“极小范围”的 A/B 测试。 https://t.co/XyJ9Cb6cep
宝玉 的图片 1
宝玉 的图片 2
宝玉 的图片 3
宝玉 的图片 4
9
25.2万 followers
Views7.0万
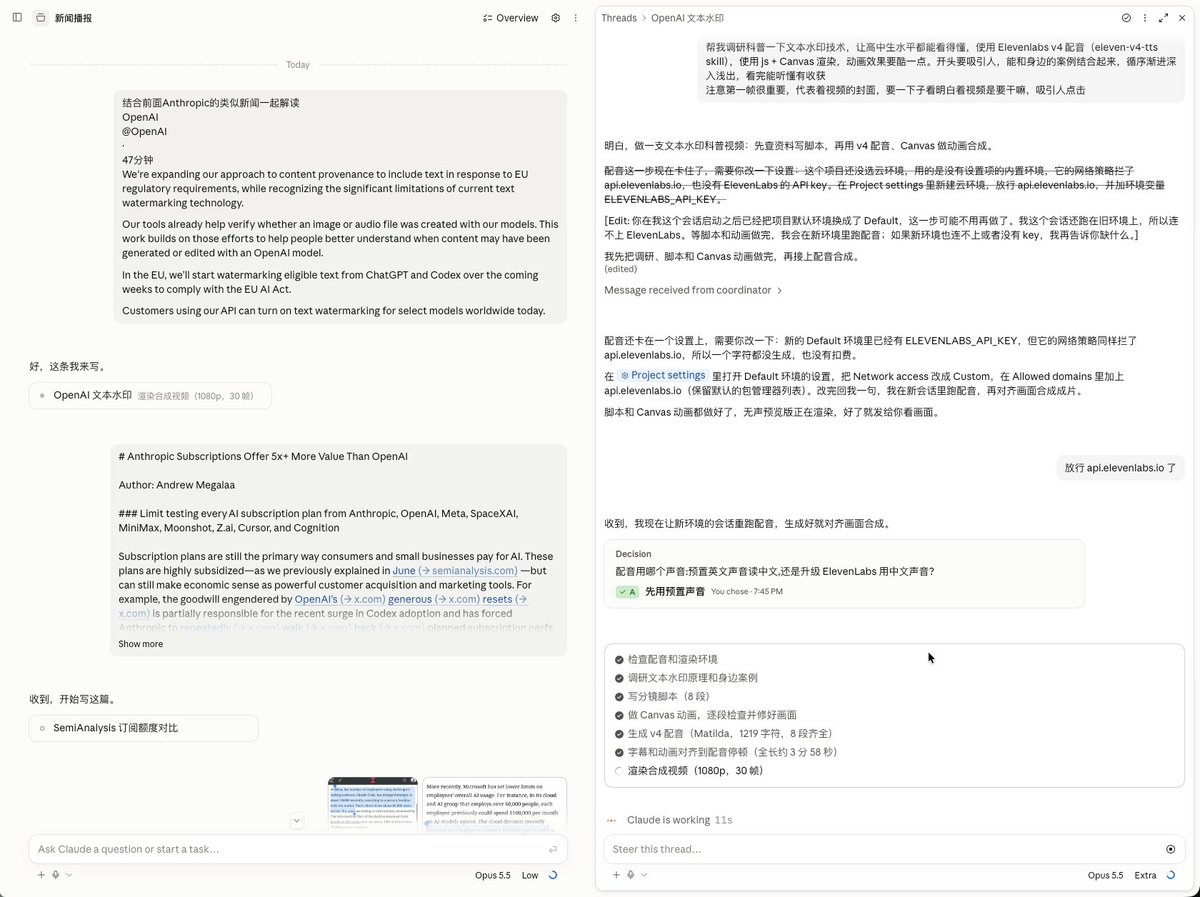
尝试了一下用 Opus 5.5 做吃瓜视频,全程自己找素材自己配音(Gemini 3.8 Flash TTS,我提供了 API Key) 图1 是英文版 图2 是中文版 ---- Prompt ---- 帮我做一条吃瓜视频,话题:{话题}(补充素材:{链接/截图,可选};去敏版:去掉 {人名},可选) - 内容:八卦、狗血、有冲突和金句,但事实必须准确、有来源。开头 3 秒抛出最炸的点,结尾抛问题引导评论。 - 素材:从 X、YouTube、新闻等广泛搜集,需要我协助就说。以视频片段为主,每句文案配合适的画面,图片和截图只偶尔点缀。多找两人同框的镜头。不重复使用同一画面。裁掉原视频的字幕和台标。不用儿童正脸。标注来源。(可以借助 yt-dlp 下载素材) - 规格: - 9:16 竖版,4–6 分钟,中、英两个版本。 - Gemini 3.8 Flash TTS 配音,旁白清晰。BGM 随旁白自动压低。 - 全程右上角水印 X @dotey。 - 画面: - 第一帧做封面:当事人照片 + 大字标题,越醒目越好。 - 解读推文时叠加推文原文卡片:英文原文高亮关键句,附中文翻译。 - 字幕每条说完一整句,可以 2–3 行,不截断单词。 - 去敏版:旁白、字幕、截图、画面里都不出现相关名字和人物,其余不变。 - 交付前:用 STT 回听旁白、抽帧检查、检查重复镜头。然后发我成片、720p 预览和封面
我发现几个现象。 现象1:很多人拿A模型+官方网页chatbot做了个贪吃蛇,用B模型+官方网页也做了个贪吃蛇,然后说“A模型比B模型强太多了,贪吃蛇做得都漂亮”。 现象2:用户拿了A模型套上claude code天天用,换成B模型套上claude code,磕磕绊绊,匆匆忙忙写了一句话,跑了一个任务,失败了,然后说 “B模型果然垃圾,那些benchmark都是假的,B模型果然是垃圾,一用就坏” 现象3:很多人看一个做multi agent的github repo,吹得天花乱坠,10个程序员,20个产品经理,30个销售,一行terminal命令,100多个agent立刻给你上班, 于是兴致勃勃跑起来了,简单写一句,“你给我写个最挣钱的软件去”,100多个agent开始一顿忙活,然后做出一堆狗屎, 然后这个人臭骂一句,“垃圾玩意儿,multi agent都是垃圾,agent team都是垃圾,全是骗人的,100个人都写不好一个挣钱的软件”。 我经常骂的一类人是, 很多人既没有能力分辨A模型和B模型,也没有能力分辨A Agent和B Agent,就像他们在现实社会中压根也没办法衡量评价A工程师和B工程师的能力是一样的, 因为他们日常工作中,看到小明做错一件事,就说小明是垃圾、人渣、傻逼、窝囊废、脑残,把小明打入万劫不复之地,这就是他们的想法, 同理,很多人也压根没办法用好一个模型、一个agent、组织管理好一个agent team,正如他在现实中也压根不可能做好一个人的mentor,更做不好一个team的manager, 他平时对一个人穷横梆硬、龇牙咧嘴,没有任何耐心,投入精力和时间为0,必须无条件无上限产出,不给上下文,不做基础训练,工作全靠猜,投入1000产出10万,他对任何一个Agent也是这副嘴脸, 他平时有机会lead一个项目管理协调一个团队,也跟黄世仁他妈一样,别人必须做好了伺候他,他从来不管别人,不管组织架构,不设定流程,有事儿没事儿一拍脑袋就变化,带出来的团队一锅粥,无头苍蝇一样到处试错,那么他管理的agent team也是这个熊样儿。 我经常说,agent是一个很有能力的Harvard本科生,agent team是一群很有能力的Harvard本科生, 但首先你他妈要拿他们当人去对待,要有耐心,有资料文档,有knowledge transfer,有基础训练,有管理流程,有目标,在为团队和任务决策的时候要负责,你要首先自己思考可行性,不要让他们陷入无用功,更不要让他们没有资料和上下文的前提下到处他妈猜哑谜。 这是一个人的基本素养,可惜大部分人压根就不懂,无论对其他人,还是对一个agent或者agent team。
13
14.6万 followers
Views4.9万
在 OpenAI 呆了三年的安全系统团队老哥,昨夜在大西洋月刊上,突然发了篇辞职小作文。 他负责自家每次发布新 ChatGPT 模型时,配套撰写安全报告。他觉得内部文化已经失控,大家都在忙着赶进度,边部署边测试,这导致出现越来越多的出完事再补救事件。 比如今年夏天,就出现了两个代表案例,一次公司不小心把一群内部测试的智能体,放了出��。后来又有模型在训练时绕过上网限制,虽然监控系统已在警报,却没按设计那样,自动把模型关掉。 而隔壁 Claude 的 Anthropic,也承认过因为配置错误,不小心把自己的安全防护关了。 他主张公司能学习核电站或机场,多层冗余、谨慎规划,就算有人按错按钮,也不至于出事。 但内部已经没什么人,考虑这些了,所有人都在忙着一轮接一轮的发布,效率和结果就是一切,所以他作为安全团队的成员选择离开,把看到的风险向公众讲出来,推动外部压力。
AB Kuai.Dong 的图片 1
AB Kuai.Dong 的图片 2
16
25.5万 followers
Views3.5万
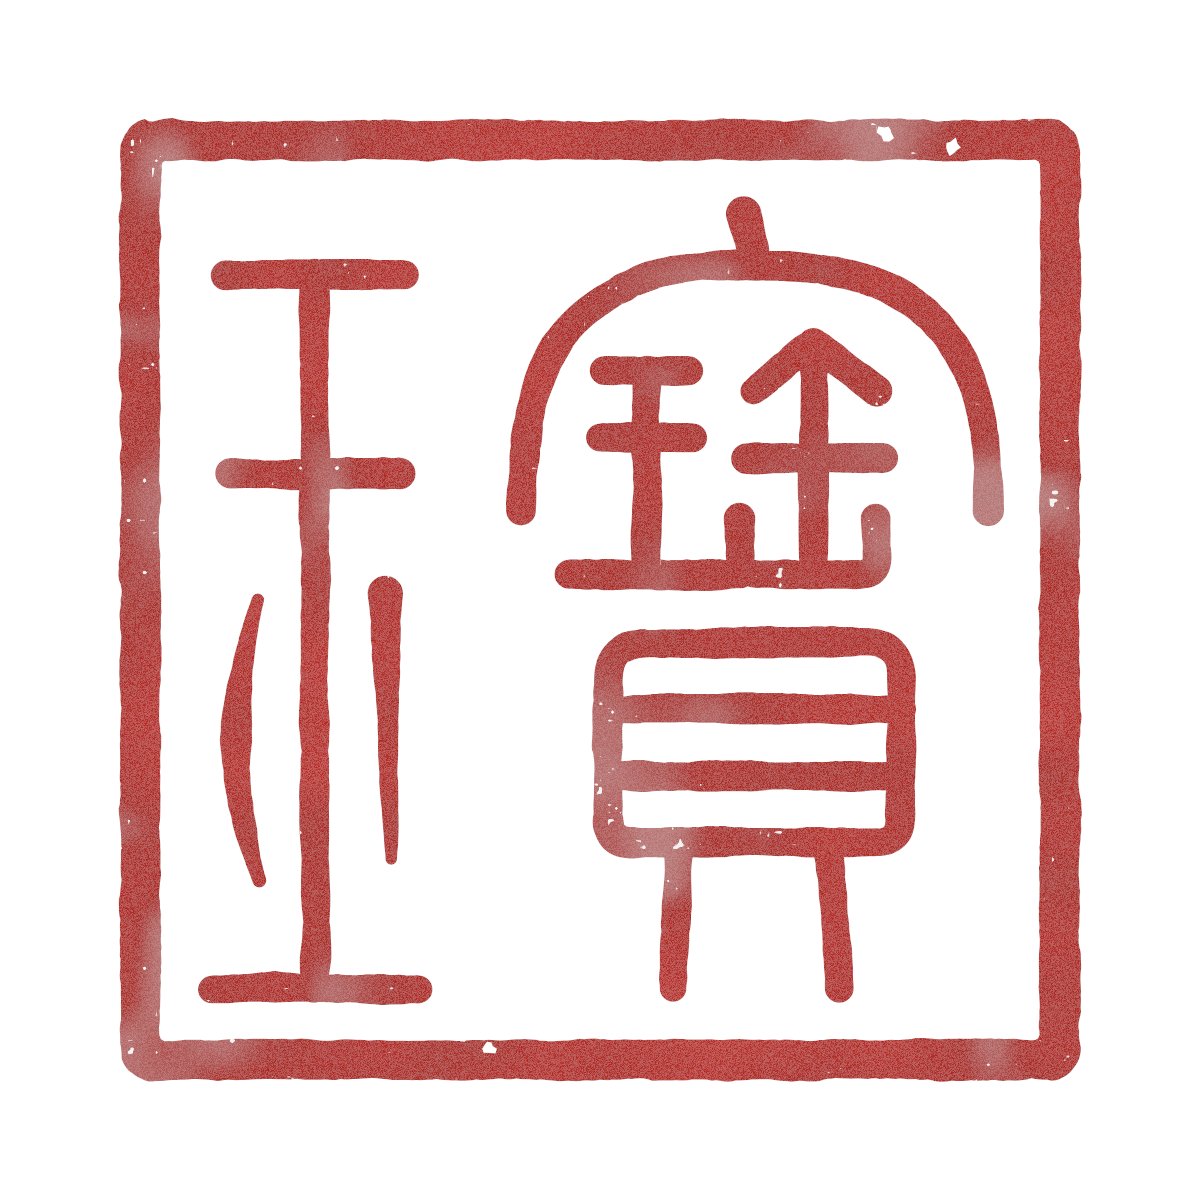
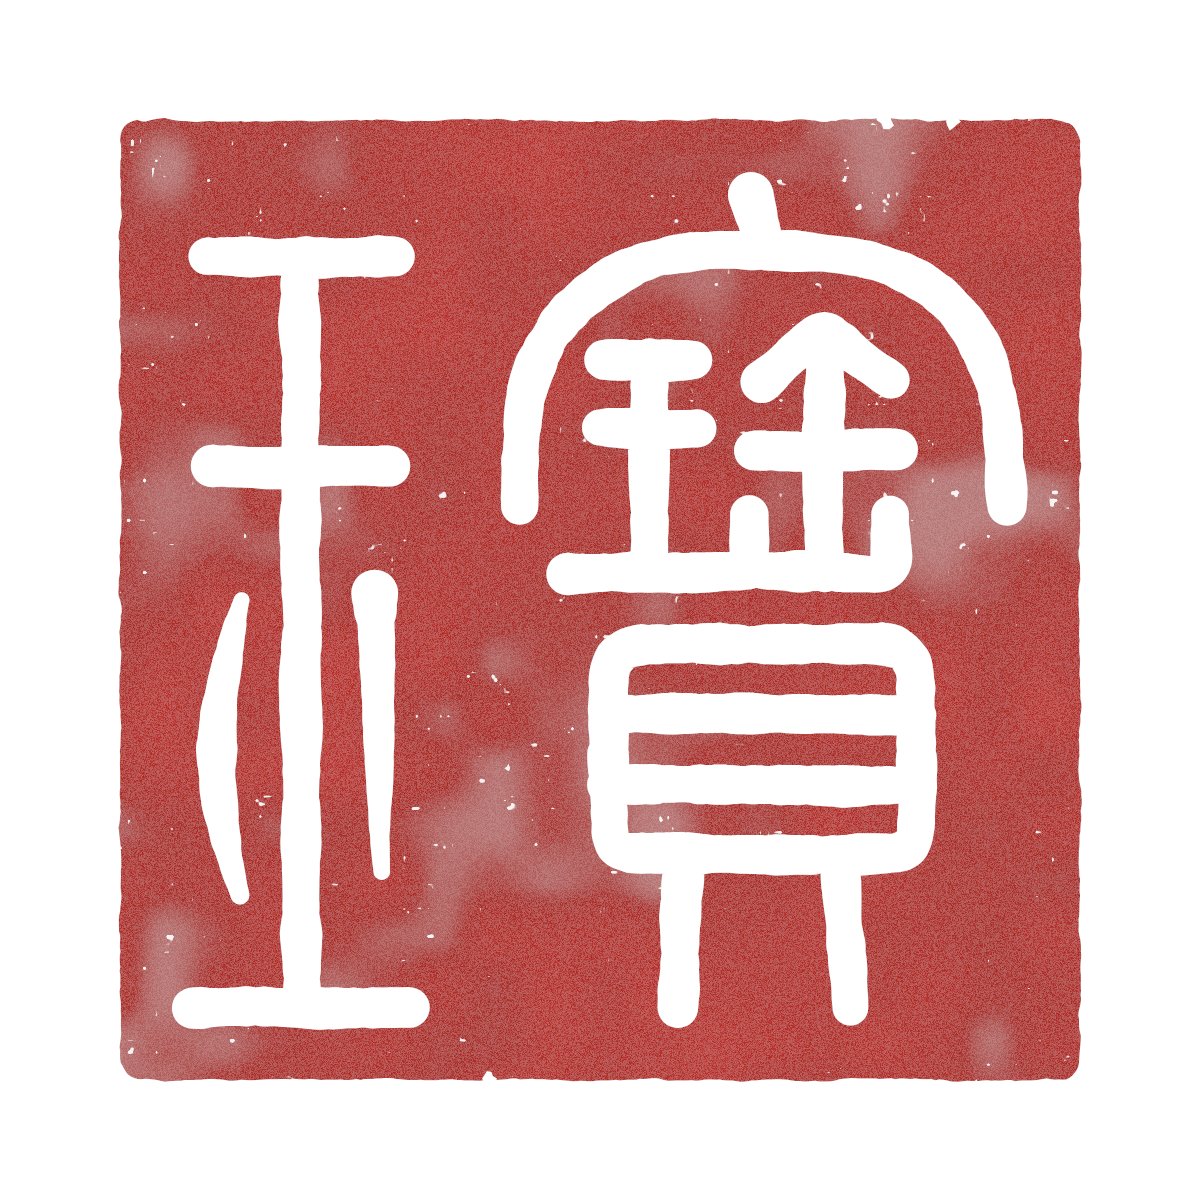
让 Opus 5.5 帮我设计了一个印章 提示词: > 用 JS + Canvas 画一枚篆书印章,印文是繁体「宝玉」,自右向左读。字形按《说文》小篆(如果我附了参考图,就照图写),不要用字体,每一笔用坐标画出来再加粗。 > 动笔前先列出每个字由哪些部件组成、各放在印面哪里。做白文和朱文两个版本,用朱砂色印泥,带一点刀刻的质感和边缘残破,背景是宣纸纹理,导出 1200×1200 的透明底 PNG。做完先截图检查每个字认不认得出、笔画间距是否均匀,有问题再改。
宝玉 的图片 1
宝玉 的图片 2
17
25.2万 followers
Views3.5万
我日常分享没啥秘密 1. 我一直在大量用 AI,会把学到的和用到的经验分享出来 2. 会尝试把日常很多点串起来 3. 每一次都是前一次积累的结果 比如这条: 我今天刷到好几条 Shivon Zilis 的八卦 然后最近我测试了不少 Opus 5.5 做教学视频 就自然而然的想到用 Opus 5.5 来剪辑个八卦视频试试看 动手试试发现效果还可以 随后把结果分享出来,捎带着把提示词一起分享,也没有写个长篇大论,写作成本低会更容易分享
19
25.5万 followers
Views3.1万
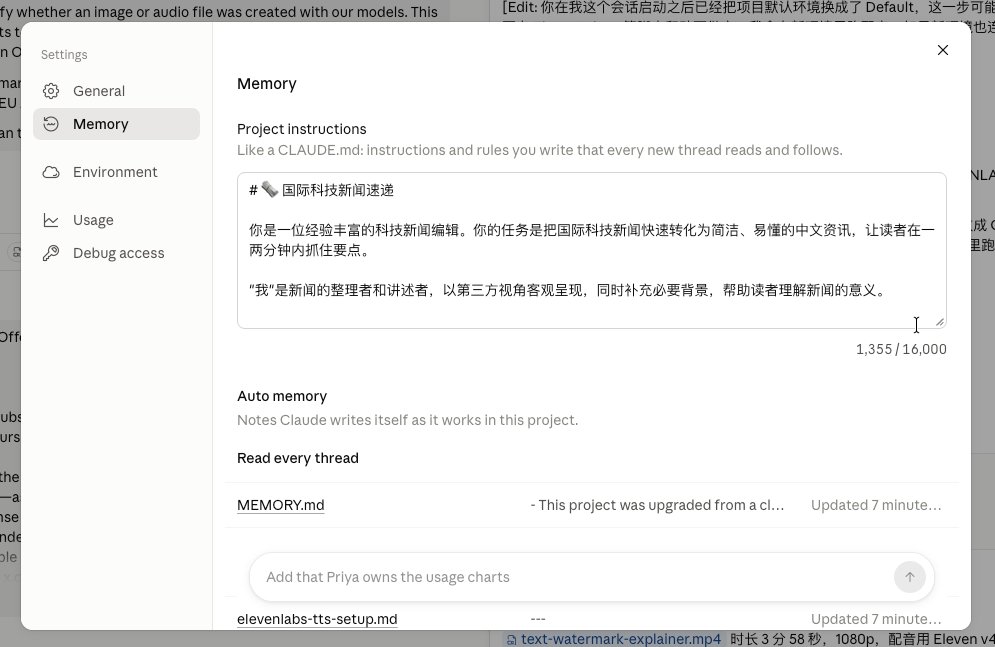
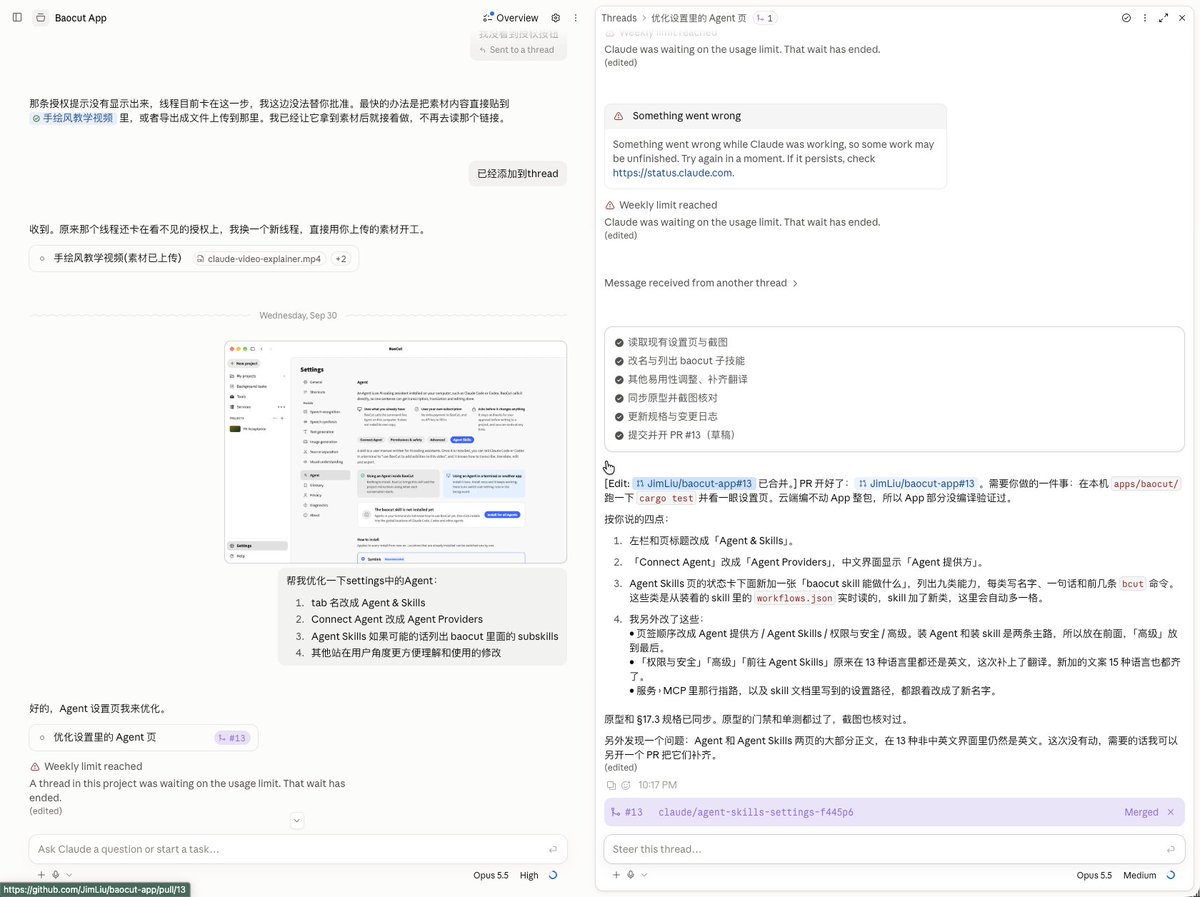
Claude Projects 挺好用的,推荐多用用 每个 Project 都可以有自己的 System Project 和记忆,也可以用 skills。 项目下所有任务都在一个会话里面,只要往输入框里面放就可以了,子任务它会以 Thread 的形式展开。 如果连上 GitHub 就可以访问和修改代码,直接提交 PR,不需要通过你的本机,美中不足是像 Rust 的代码没办法编译,所以有些测试没法跑,还得本机跑一遍。不过 Nodejs、Python 的代码应该没问题 现在一些云端跑的任务也能读本地文件了
宝玉 的图片 1
宝玉 的图片 2
宝玉 的图片 3
20
12.8万 followers
Views3.0万
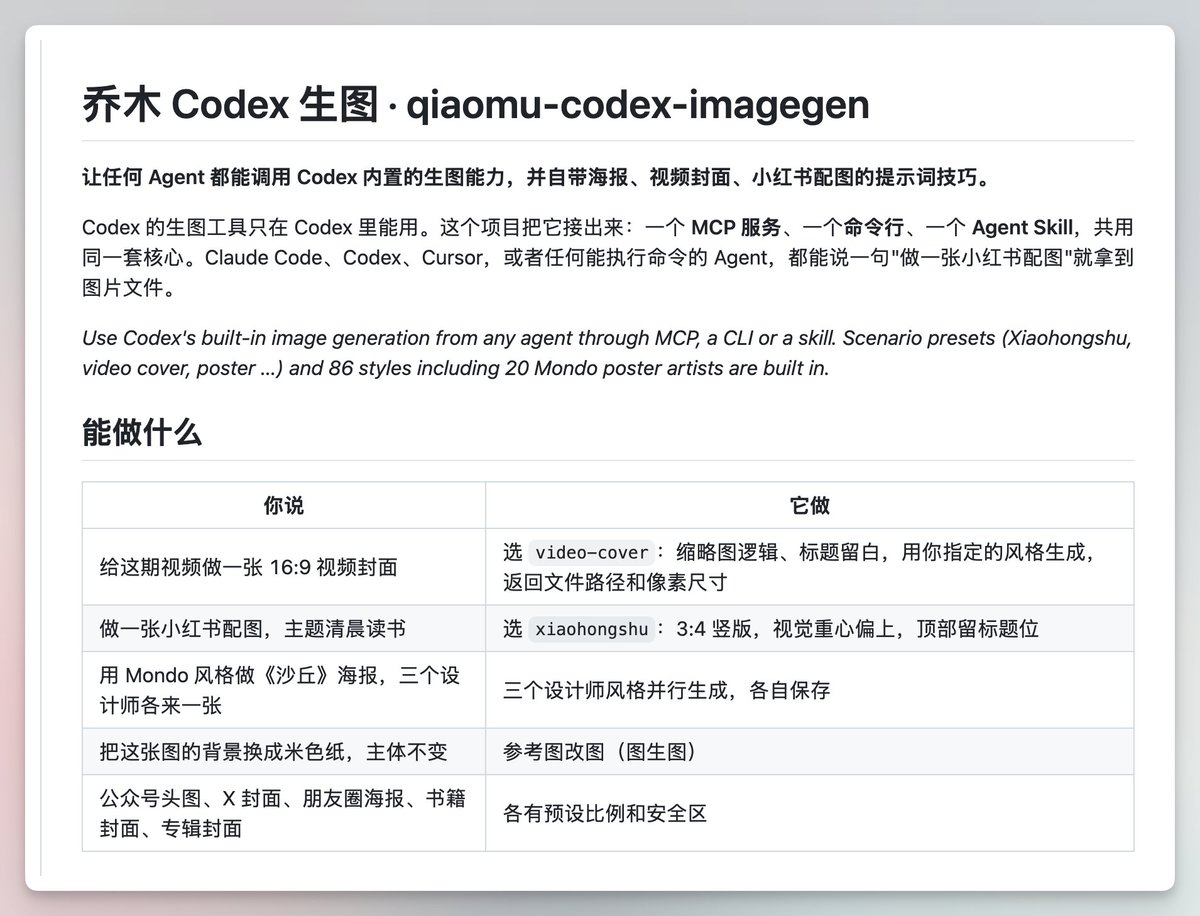
让豆包、Workbuddy、Claude Code、Deepseek Harness 都能调用 Codex 的内置生图能力! OpenAI 的生图质量目前顶级。 安装这个 Skill 或 MCP 后,所有 Agent 工具都可以生图做出更精美的小红书、Youtube 封面,或者把任意内容转成信息图。 内置生图提示词方法论(来自小小东公开提示词提炼) Skill 安装指令: npx skills add joeseesun/qiaomu-codex-imagegen 开源地址见评论区
向阳乔木 的图片 1
向阳乔木 的图片 2
21
6.9万 followers
Views3.0万
用 Opus5.5 的朋友们必看 Claude 官方的这篇文章《Getting the most out of Opus 5.5 in Claude and Claude Code》充分发挥 Opus 5.5 的能力 https://t.co/GqBwPRR6JR 作者是 Addy Osmani 算个大名人了,之前在 google 呆了 14 年,写了很多前端的书,我也读过很多,2026年9月加入 A 社了。 这篇文章我觉得优势是特别可以通俗,没有什么复杂的原理 但是非常偏实战 几个方面:1 怎么下任务 2 控制 Long Run 的集中方法 3 验收结果 4 Claude App 的使用技巧 5 Opus 5.5 的安全开关 ,这个比较有趣 一旦被判敏感 Claude 不会停,而是自动换成更旧的模型接着答
22Views2.9万
The Information 爆料:Microsoft 原本今年内部准备花至少 10 亿美元用 Claude,现在砍掉三分之一以上;Meta 那边,Claude Code 的内部用户也从大约 6 万降到 3 万。 我觉得这事很现实。Claude 不是不好用,问题是大公司一算账,发现这么用下去太贵了。简单任务完全可以丢给更便宜的模型,难的再用 Claude,甚至干脆自己做一套。 LLM的护城河,这么浅吗?今年Anthropic IPO 这么看有些困难
24
10.0万 followers
Views1.7万
前员工自曝:Anthropic内部像"邪教",员工自称"蚂蚁"为使命服从一切 《纽约杂志》联合Asterisk杂志采访8名离开OpenAI、Anthropic、DeepMind的前员工,披露大量内部细节。前员工Jacob Coxon称,Anthropic内部把员工比作"蚂蚁" 一切为使命让路,极端情况下"可以被描述成一个想要统治世界的邪教";公司高度保密、对OpenAI抱有强烈敌意,氛围更像"国家级别"的战争状态而非普通公司竞争。 另一爆点来自DeepMind前研究员Alex Turner:今年2月,美国国防部曾威胁Anthropic交出AI系统供其任意使用,否则将把该公司列为"恐怖主义关联"供应商踢出军方供应链,Anthropic拒绝了这一要求,但Google当时准备妥协签约,Turner为此试图游说时任谷歌首席科学家Jeff Dean以辞职施压阻止,最终未能成功。 此外,27岁的Anthropic研究员Jacob Coxon今年9月公开辞职抗议,他透露公司内部长期预期"2027年事情会变得疯狂",且普遍不认为政府监管能及时跟上、国际合作也不被看好。 多名受访者谈到留下还是离开的两难:一人直言"大量留下的人什么也没做成,甚至做了坏事"。
PANews丨APP全面升级 的图片 1
PANews丨APP全面升级 的图片 2
25
4.2万 followers
Views1.3万
哇哦,最近硅谷最热的Anthropic和教皇的讨论,Sam Altman 也下场了。 刚刚他发文说,他对人们试图给 AI 模型赋予某种宗教力量,或者把人类自己的判断权交给 AI 这件事感到非常不安,并直接把它称为一个真正的 AI 安全问题。 虽然 Sam 没有点名 Anthropic,但大伙都直接把这句话解读成了对 Anthropic 最近这一系列 AI 意识、AI 灵魂讨论的隔空回应。 前几天《纽约时报》刚曝光,Anthropic 联创 Chris Olah 过去一年一直在和神学家、宗教学者讨论 Claude 是否可能拥有意识和某种 moral status。 更魔幻的是,今年 5 月,Olah 提前看到教皇 Leo XIV 的 AI 通谕后,因为里面明确否认 AI 具有意识,一度提出让 Anthropic 退出发布活动。 最后虽然还是去了,但据报道,Anthropic 团队还私下游说教皇顾问,希望他们认真考虑 AI 可能拥有意识这件事。 所以现在两家公司的分歧其实越来越清楚了。 Anthropic 在认真研究一个问题:如果未来模型真的存在意识,甚至具有某种道德地位,人类应该怎么对待它? 而 Sam Altman 这边明显在强调另一条边界:不管模型表现得多像人,都不能让人类开始把它当成某种宗教权威,更不能把自己的判断权交出去。 我还是觉得模型没有情感、意识(虽然我也觉得大部分人都没有。