meng shao

meng shao

@shao__meng最近同步 9/21/2026, 12:07:31 AM

Building AI Agents for design & media. 分享新产品、开源项目,以及 AI 创业与职场观察。 公众号 / 小红书:AI 启蒙小伙伴|合作请私信

7日排名
#549
总粉丝
34.3K
7日涨粉
+308
7日发帖
73
7日曝光
224K
帖均曝光
3.1K

Ranking History

Today’s rankings update in real time. Historical records retain daily top-five entries for growth, posts, and reach. Click to view a poster.

No daily top-five records yet.

粉丝趋势

近30日每日已结算数据

内容表现趋势

曝光/互动与发帖量均按自然日结算

发帖趋势

近30日每日发帖量

帖均曝光趋势

每日总曝光 ÷ 每日发帖量

Participated Topics

Participated in 1 topics

View topic rankings

中文 X 创作者继续围绕 AI 写作去味、Skill 工具和 Agent 课程分享形成高收藏讨论。余温称写作时只加入“禁止使用状语”就能明显减少 AI 味并提升小说质感,铁锤人随后转述类似体验;Viking 分享 show-me Skill,强调让 AI 用最小图示解释技术问题,而不是堆砌长段文字;G哥则分享开源 AI Agent 课程,并称可替代某些付费课程。讨论显示用户关注点正从单条 Prompt 转向可复用工作流、图解能力和系统化学习资源。

Participated post: Skills 构建完整指南(33页) 这是 26 年看过最完整全面、质量最高的 Skills 构建指南,虽然是 26.01 发布的,应该还有朋友没看过。 强烈建议保存备用,时常拿出来系统学习一遍,会对 Skills 的构建、验证和使用过程有更深更系统的理解。 The Complete Guide to Building Skills for Claude https://t.co/KqPV5yK4Ng
Posts 4 Views 66.2KHeat 17.2K
#AI写作#去AI味#提示词
近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

3
3.4万 followers
Views5.7K
Manus 团队 @Nin19536 用 Jev 做了一个游戏 利用 Jev 超快的 System One 特性快速决策操作浏览器,选择物品并用来实际渲染房间。 很有启发的尝试,当一个模型快了很多倍、便宜了很多倍,能判断能决策但不说废话,它能在很多系统中充当 System One。 3D 渲染游戏可以这么做,实时生成游戏、视频、学习内容等,都可以往这么方向上探索。 试玩地址: https://t.co/VUYYM4nGhc
4
3.4万 followers
Views2.5K
TypeSafe CEO @CompleteSkeptic : 为什么还要再造一个 coding agent ? Diogo 核心想法是一个反事实思想实验:如果 LLM 没有 KV cache,你会怎么设计 coding agent? 原因是:今天 agent 的许多“标准特性”并非源于用户价值,是为绕过 KV cache 与按 token 计费的成本结构而打的补丁。用这个视角审计,才能分清哪些是真设计、哪些是“被 KV cache 限制”的产物。 前提假设:coding agent 出奇地简单(agentic 部分本质是 while loop + 少量工具),创新空间在“非 agent 部分”,包括状态、上下文、成本管理;模型、UI、开源实现皆可复用,第一方 agent 的成本优势在缩小;而有些事只有原生 agent 能做,这是做新 agent 的理由。 https://t.co/gw1vBa0y4F # KV cache 造成的六个怪象 1. 按难度路由在经济上不成立。算个账:以 Opus(输入 5 / 输出 25)、Sonnet(3 / 15)计价,X = 上下文 token,Y = 生成输出,Z = 输出中额外生成的 token(命令、读文件等);全程 Opus 成本 25Y + 5Z,Sonnet 开路再回 Opus 成本 3X + 20Y + 8Z。只要 X 大(长会话)或 Z 超过 Y 的约 1.67 倍,第二条就更贵;按 Diogo 给的比例(X=0.65, Y=0.12, Z=0.23),全程 Opus 只要路由方案 2/3 的钱。直觉盲区在于:cache 按模型隔离,小模型读大模型的上下文要全价,回到大模型时,中途产生的每个 token 还要按输入价再付一遍。 2. 工具调用是奇怪的权衡:工具必须 upfront 声明在系统消息里却并非都相关,调用时还得把参数说清楚;既吃上下文,模型又不擅长“高基数 × off-policy”的工具调用。作者认为这正是 skills(渐进式披露)反而好用的原因。 3. compaction 的存在很可疑:它隐含假设“未来所有 turn 都想要同一份共享状态”。但压缩本身极难,且注定不如“查询感知的压缩”,知道要找什么时,压缩容易得多。 4. 子 agent 能力参差:作者惊讶模型不做自动并行,怀疑卡点在“状态交接”,传什么进去、合并什么回来。 5. 重启的存在:仅在“agent 有状态且状态会腐坏”的前提下合理;另一种思路是按需即时加载全部相关旧状态。 6. 开箱即用之争:agent 要不要内置大量现成能力(工具、文档、工作流);一端是 openclaw 式的“全都给你配好”,另一端是 Claude Code/Codex 式的“只给骨架,其余自己搭”。 # TypeSafe 的解法:显式状态 + 按查询动态重建上下文 Diogo 主张 “TypeSafe-centric” 设计,把“一切都在上下文里”当作显式不变量,但对每一次用户查询重新计算上下文(他称之为 “meta-attention”): · 给每个上下文 chunk(工具输入/输出、内部推理、用户对话)打相关性标签,未来细化为“不显示 / 小摘要 / 长摘要 / 全文”的分级; · 对“复用现有 KV cache vs 从零重建”做成本感知决策,这是让路由在经济上成立的前提; · “上下文是静态的”这一假设被彻底移除。 由此解锁四件事: · 成本/智能感知路由:上下文重建变便宜后,简单任务路由到便宜/快的模型才真正划算;顺带可以把“多花钱换好/快”与“尽量省”做成给用户的旋钮。 · 子 agent:作者猜当前子 agent 的主要成本就是“搞清传什么状态”,这件事变便宜、自动化之后,子 agent 才值得大规模用。 · Skills/MCP/工具调用的第一性原理重设计:一个中间层始终只放一行“方向性描述”(模型得先知道某个动作可能存在),完整 schema 按需加载(类似 Anthropic 的 tool search)。若上下文不被污染,就能以近零成本内置海量电池(数百工具 + 数千文档),既是产品力也是联合营销杠杆。 · 条件化 AGENTS.md:按条件动态加载(前端工作→风格指南;某子目录→gotchas 文件)。与 skills 的区别是“常驻记忆”而非“立即执行”,且应免疫于 compaction(skill 加载后又遭压缩,大概率被摘要掉)。 半熟的激进构想 · 后台只读任务:近期热门工作流(并行 HTML、后台建 eval、ELI5)的共同点是“后台运行 + 对代码库只读”。与显式状态的协同点:一次代码变更的相关信息检索可在多个后台任务间共享、摊薄成本。作者认为“显式读写状态”是这里的超能力来源;现成样板是 cross-model review(让 codex 审 claude 的活)。 · 安全感知路由:便宜模型(如 DeepSeek V4)+ 数据外泄疑虑 → 给任务按“可能触碰的文件类型”打标、按类型定策略,把低敏感查询路由到便宜模型;推广开还有其他回避逻辑(LLM 研究不用 Anthropic,安全敏感不用 OpenAI/Anthropic)。 · 其余零散想法:结构化 skills(可编程 harness + hooks)、递归语言模型(显式变量即状态)、花式摘要(对 grep 输出做相关性热力图再按需裁剪)、极端并行(需要锁与同步原语)、给 hype 项目(headroom/rtk 等)做适配。 · 点名了一批可集成/改进的工具(headroom、rtk、ast-grep、ast-outline、fastcontext、fff),并引了一个数据:某轨迹分析中读+搜索占工具调用轮次的 56.2%、主 agent token 的 46.5%,若可泛化,“用结构化检索替代子 agent 搜索”是最大的效率杠杆。
meng shao 的图片 1
5
3.4万 followers
Views2.5K
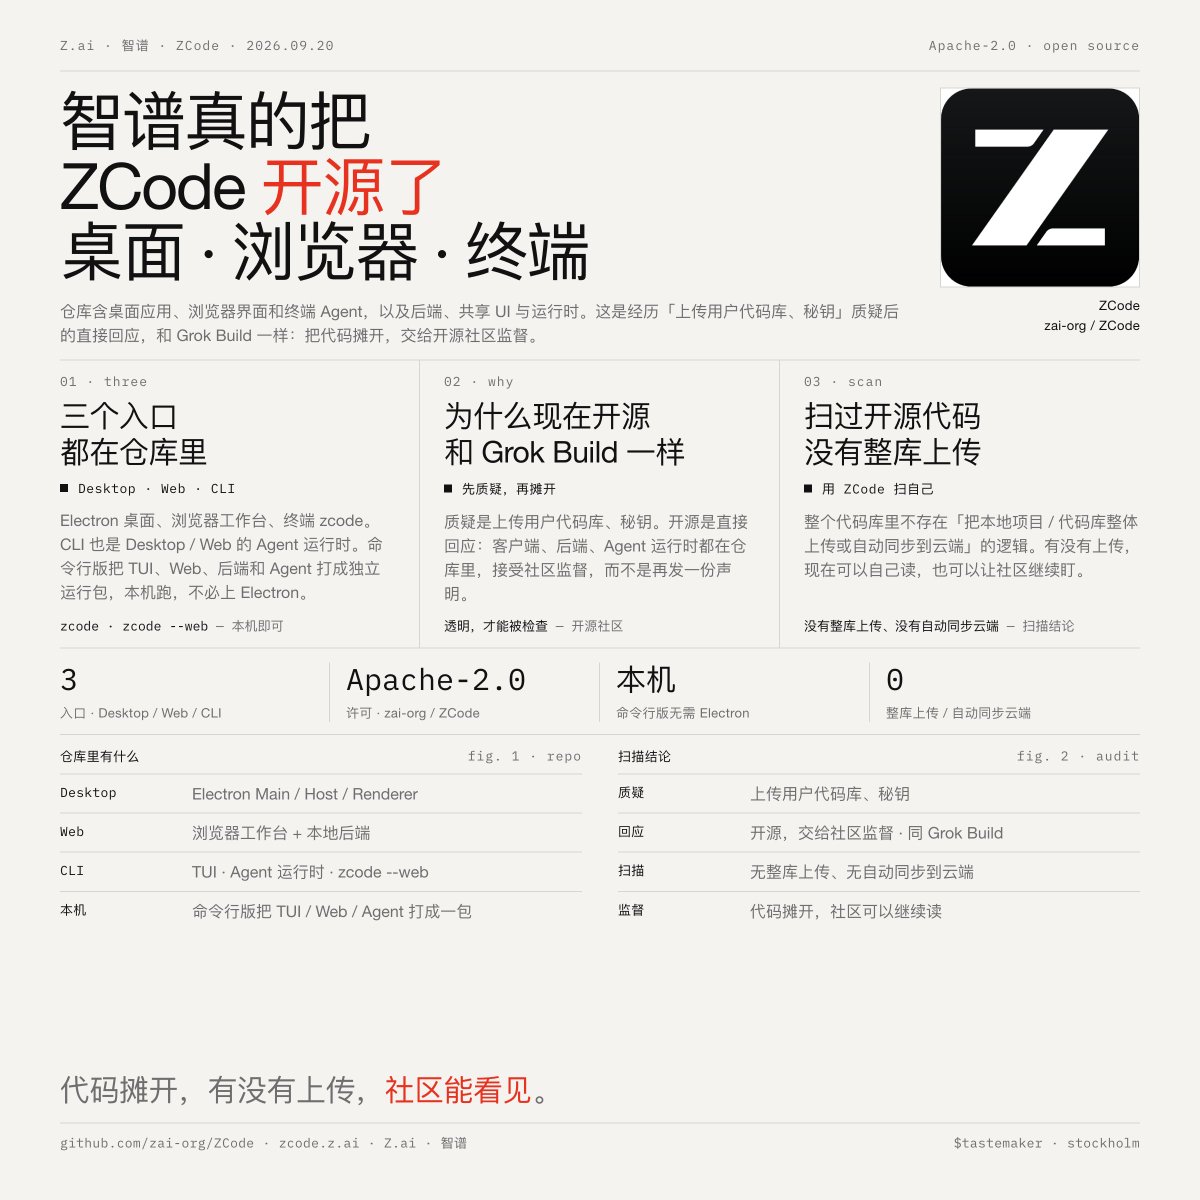
智谱真的把 ZCode 开源了,包括桌面应用、浏览器界面和终端 Agent 开源地址:https://t.co/EWb17xEnYl 这也是智谱团队经历了上传用户代码库、秘钥等质疑后,做出的直接回应,和 Grok Build 的处理一样,把代码开源出来,让它更透明,有开源社区的监督。 我让 ZCode 扫描了一遍开源代码,整个代码库里不存在任何“把本地项目/代码库整体上传或自动同步到云端”的逻辑。
meng shao 的图片 1
6
3.4万 followers
Views493
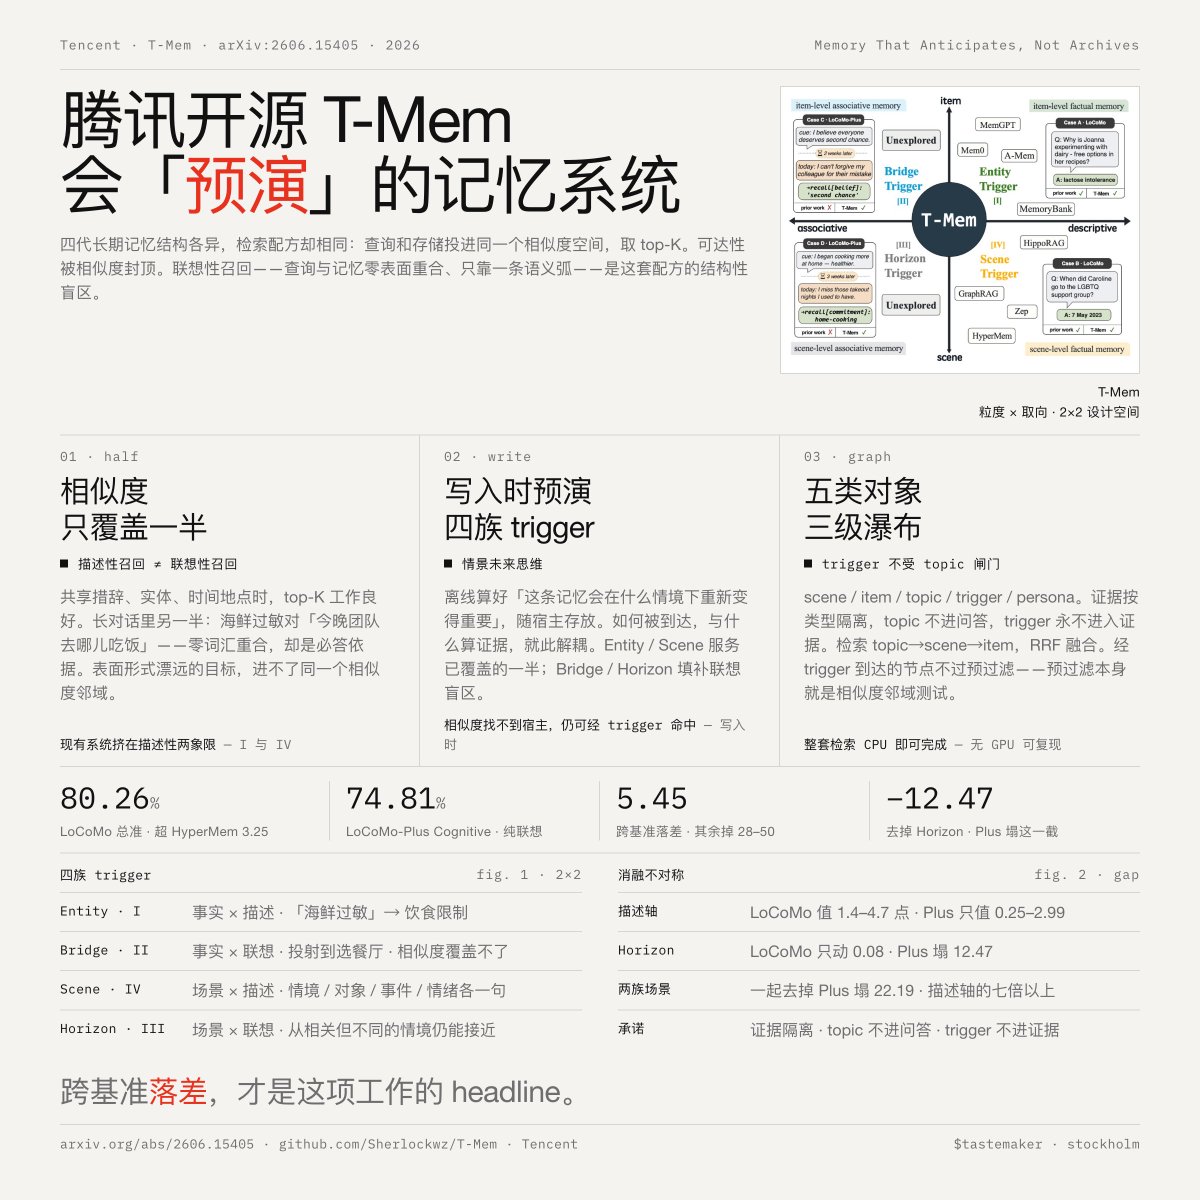
腾讯团队开源发布会"预演"的记忆系统「T-Mem」 当前四代长期记忆架构:Flat RAG、图结构记忆(GraphRAG、Zep、HyperMem)、agentic 层级记忆(Mem0、A-Mem、MemoryBank)、操作系统式记忆内核(MemGPT、MemOS、MIRIX),虽然结构各异,但检索配方却完全相同:把查询和存储内容投进同一个相似度空间(BM25 或稠密向量),取 top-K。这决定了一件事:记忆的"可达性"被相似度封顶。 论文:https://t.co/Un2f8yFr2r 开源项目:https://t.co/0oItT1QCT9 # 现在的问题是什么? 现有记忆架构的检索配方只覆盖一半情形。当查询与记忆共享表面特征时(同样的措辞、同一个实体、同一个时间地点)它工作良好,这就是描述性召回。但长对话里还有同样常见的另一半:查询与记忆零表面重合,绑定二者的只有一条潜在的语义弧,比如因果关系、同一情境的延续。这是联想性召回。比如:一个月前用户说过"团队里有人严重海鲜过敏",今天问"今晚团队去哪儿吃饭",两句话没有任何���汇重合,前者却恰恰是后者的必答依据。长对话中的用户极少用原措辞重提旧话题,而借新情境的间接线索回访记忆;表面形式已经漂远的目标,永远无法从同一个相似度邻域里到达。 把"粒度"(单条事实 / 完整对话段)和"取向"(描述性 / 联想性)作为两个正交轴,就得到 2×2 检索设计空间。论文指出,现有系统全部挤在第一、第四象限(描述性的一半),第二、第三象限,联想性的一半,是这套检索配方的结构性盲区。也是腾讯这篇论文的基础。 # 核心思想:把"预演"放在写入时 T-Mem 的答案借自认知科学。人在回忆过去时,会为未来的线索预演经验,这叫"情景未来思维"。它的工程对应物就是 trigger:写入记忆时,由构建用的大模型离线算好并随宿主存放的一条预测,"这条记忆会在什么情境下重新变得重要"。 trigger 的架构意义在于解耦了两件事:一条记忆"如何被到达"和"什么算答案证据"。当相似度找不到宿主时,查询仍可以经由宿主的某条 trigger 命中它。每条记忆因此同时保有描述性入口和联想性入口。四个 trigger 家族各占设计空间的一个象限: · Entity Trigger(第一象限,事实×描述):给原子事实一个上位概念名。"海鲜过敏"的实体触发器可能落在"饮食限制"上。 · Bridge Trigger(第二象限,事实×联想):把事实投射到一个"知道它就会有用"的具体情境,并附一步推理的理由。过敏事实投射到"为团队晚餐选餐厅"。这是纯联想轴,相似度检索完全无法覆盖。 · Scene Trigger(第四象限,场景×描述):从情境、对象、事件、情绪四个正交属性各用一句话描述当前场景。 · Horizon Trigger(第三象限,场景×联想):把同一场景投射到一组前瞻维度,让未来的查询从相关但不同的情境接近时仍能命中它。 其中 Entity 和 Scene 服务的是相似度检索已经覆盖的那一半,Bridge 和 Horizon 才是填补盲区的两族。 # 结构与流程 记忆被组织成五类对象的类型化图:scene(按事件闭合切分的连贯对话段,作为证据)、item(从 scene 抽取的原子事实,可锚定到多个源 scene 以承载跨场景的逻辑链)、topic 标签(只用于限定抽取范围和检索预过滤,明确不进入问答通道)、四族 trigger(只参与检索,永不出现在证据里),以及按说话人聚合的 persona(作为环境上下文附在证据之后,不占用检索预算)。三条设计承诺:证据层按类型隔离、topic 不污染问答、trigger 不进入证据路径。 构建是四阶段离线流水线,顺序承重:按事件闭合(而非会话边界,会话边界是数据采集的副产品,一个会话可含多个事件、一个事件可跨多个会话)切分 scene;按到达顺序做 topic 归组,一个 scene 可加入多个 topic;每个 topic 一次抽取,同时产出原子 item 和跨场景连接 item;最后逐节点生成 trigger,Entity 与 Bridge 在同一次模型调用中产出。 检索是自上而下的 topic→scene→item 三级瀑布,每层用 RRF 融合词法与稠密排序。最关键的一处工程细节是:经由任一 trigger 到达的 scene 和 item 不受 topic 预过滤的闸门约束。预过滤本质是基于相似度的邻域测试,而 Bridge 和 Horizon 恰恰是为邻域之外的线索设计的;让它们过闸,等于把 T-Mem 自己要对抗的相似度体制重新加回来。item 级 trigger 召回另带 0.85 的硬余弦阈值。trigger 索引采用多视图编码:每个 item 暴露纯概念、纯桥接、联合(概念∥桥接∥理由)三个视图,取跨视图的最大余弦分并归属到宿主。整套检索在 CPU 上即可完成,单台无 GPU 工作站可复现全部评测。 # 实验结果 LoCoMo 官方协议下,T-Mem 总准确率 80.26%,超最强基线 HyperMem(官方协议复跑值 77.01%)3.25 个点,token F1 51.96 同向;分题型为单跳 85.97、多跳 69.15、时间 82.55、开放域 55.21,其中开放域以 0.69 点惜败 MemOS,是唯一未拿第一的题型。 真正的分水岭在 LoCoMo-Plus 的 Cognitive 子集(专门剥离词汇重合、探测纯联想召回的题目):T-Mem 74.81%,HyperMem 48.63%,MemOS 32.67%,GPT-4o 直接读完整对话原文零样本也只有 21.05%,Gemini-2.5-Pro 为 26.06%。跨基准落差方面,T-Mem 只掉 5.45 个点,其余系统掉 28.38 到 50.07 个点;连 GPT-4o 吃下全部原文也掉 45 个点,说明骨干模型的规模救不了联想轴的断裂。作者自己划的重点是:���基准落差而非单榜绝对分才是这项工作的 headline。 消融实验是全文最有信息量的部分,且信息不在总分而在两列的不对称。描述轴组件(scene 层、item 通道、Entity+Bridge、persona、topic 过滤)在 LoCoMo 上各值 1.4 到 4.7 个点,在 LoCoMo-Plus 上却只值 0.25 到 2.99 个点;联想轴组件完全反过来,去掉 Horizon Trigger,LoCoMo 只动 0.08 个点,LoCoMo-Plus 塌 12.47 个点,两个场景级 trigger 一起去掉塌 22.19 个点,是任一描述轴开关影响力的七倍以上。这条不对称本身就是论证:只按相似度基准调优的系统,隐含地就在优化"待在相似度邻域之内",而邻域之外的成本,这类基准在构造上就测不到。 效率上,构建是一次性离线成本:10 段 LoCoMo 对话共 9,689 次构建模型调用、15.60M token,高于 Mem0 的 12.20M,作者把增量明确归给 Bridge 和 Horizon 两族联想 trigger,称之为扩展联想轴的价格。答题时的 token 预算低于 HyperMem 的同时两个基准都更准;低 token 阵营(Mem0、Zep、MemOS)在 LoCoMo-Plus 上直接崩盘。
meng shao 的图片 1
9
3.4万 followers
Views0
AI Agent Evals 实战 FAQ:先发现失败、再谈评估,700+ 工程师踩坑后的完整方法论 当前行业的主流叙事是:搭评估基础设施、接 LLM-as-a-Judge、看仪表盘分数。两位作者 @HamelHusain @sh_reya 基于大量一线教学与实践,认为这条路径恰恰是错的,或者说是本末倒置的。 他们的核心方法论可以压缩成一句话: 先做错误分析,再谈评估体系。 评估指标是从真实失败案例中“生长”出来的,不应该是预先设计出来的。
10
3.4万 followers
Views0
Digg 创始人、True Ventures 投资人 Kevin Rose 发布了他的 Grok Bot Template「INDEXX」 INDEXX 可以把你多年保存在 Instagram 里的视频,变成一个完全存放在你本地电脑上、可搜索、可问答的 Markdown 个人媒体维基。X 和 Tiktok Template 很快就会发布! https://t.co/lzY4zY0bZB 流水线:用 ScrapeCreators 拉取元数据与可下载地址(使用前会估算积分并征求确认)-> 下载到条目目录 -> 从视频抽出 audio.mp3 -> 观看并描述画面 -> 用 Grok Voice Transcribe 2.0 转写 -> 打标签并写入 wiki。进度按阶段记录:下载、音频、观看、转写、标签、wiki。 信息组织分三层:标签(5–10 个 kebab-case 关键词)、facets(形式 / 主题 / 意图,互不混用)、概念页(同一主题至少出现在 3 条来源,或你明确要求时才建)。条目只有在状态为 wiki_ingested、且 schema 清单全部通过时,才算处理完成。路径由 .indexx.json 解析,不写死用户名。本地检索与音频处理主要依赖 ripgrep 与 ffmpeg。
meng shao 的图片 1