
返回话题榜把我珍藏已久的好东西分享给家人们,剪映11.4.2开源!!!🥳🥳🥳https://t.co/CGXDq1tcIh
配套神级Skill:https://t.co/QQ5XDF75mw
只需要简单提示词,口播类视频,全程托管给Codex,不需要任何人类操作。
即使略微失误,由于调用豆包ASR,片段被切割到毫秒级别,导入剪映草稿也可以人工丝滑调整😋
放一个原本8分钟,剪辑后3分钟,完全由Codex+yichen-jianying-edit Skill自动剪辑完成的,前后视频对照,以及提示词截图👇
整个剪辑流程可能需要花费的地方:
1.Codex Token费用,可以用别的便宜模型平替,比如Workbuddy免费的hy3和DeepSeek-V4.1-Flash。https://t.co/DhhbXesth0
2.豆包ASR,一小时八毛钱,说实话,不能再便宜了。。。
https://t.co/VlZSRt7Ak6 Q4:作为非工程师,怎么判断 Vibe Coding 出来的代码是否靠谱?比如 GPT 写的代码常有大量不必要的安全验证、过度防御。
我的观点可能有争议,越是有编程经验的人可能越不认同,一年前的我也不会认同:不用太在意代码细节。整不整洁、有没有冗余、是否过度防御,都不是关键。
你把自己当 QA,看三件事:
1. 功能完不完整;
2. 性能好不好,跑一下看 CPU 内存占用,我的 App 有段时间内存很高,就让 AI 去优化;
3. 安全是最高优先级,SQL 注入、弱密码这类常识测试要做,拿不准找专业的人。
其他实现细节没那么重要,就像高级语言编译成汇编你本来也看不懂,当黑盒就好。
真正的重点在两头:
一是拆分,拆成 Agent 刚好能处理的小模块,一次一个小模块,AI 的产出比绝大多数程序员的平均水平高;
二是验收,功能、性能、安全把住,细节不用管。
OpenAI刚更新的多币种计费页面,人民币已经被列进支持币种了。
如果后面直接支持人民币结算,代充这门生意可能真要塌了😂
现在就等官方什么时候正式放开。 https://t.co/0ZNYQp7cCf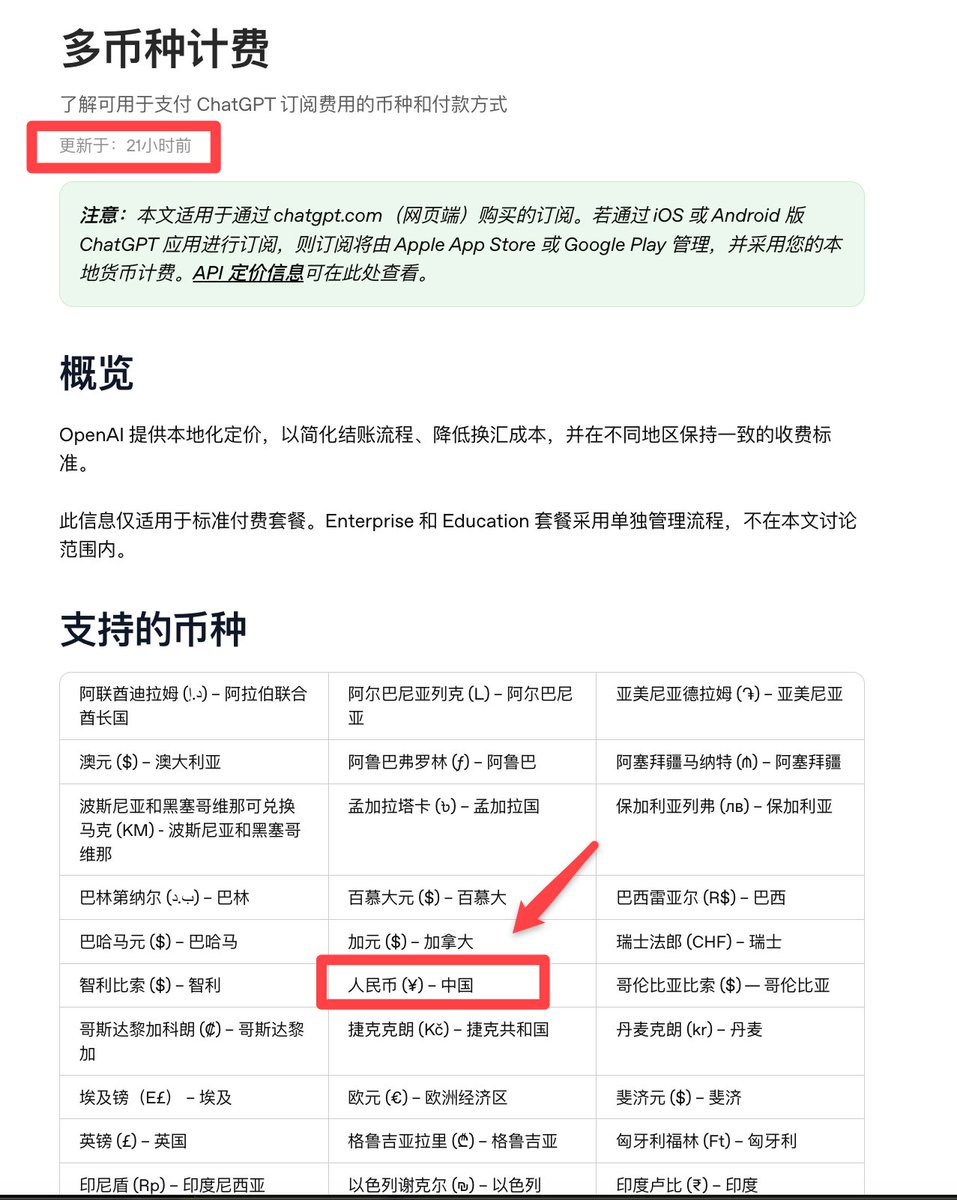
网易UU远程居然上x了!vibe coder们,来帮涨粉啊 大家都试了Gemini 4 Pro了吗?据说完全杀疯了?
编码、智能体、推理等领域实力,全面碾压GPT-6 Astra、Claude Fable 5.1😂有1000万输入上限,25.6万输出上限,永久跨会话记忆,不用API即可连网。 https://t.co/gsWMS69yMl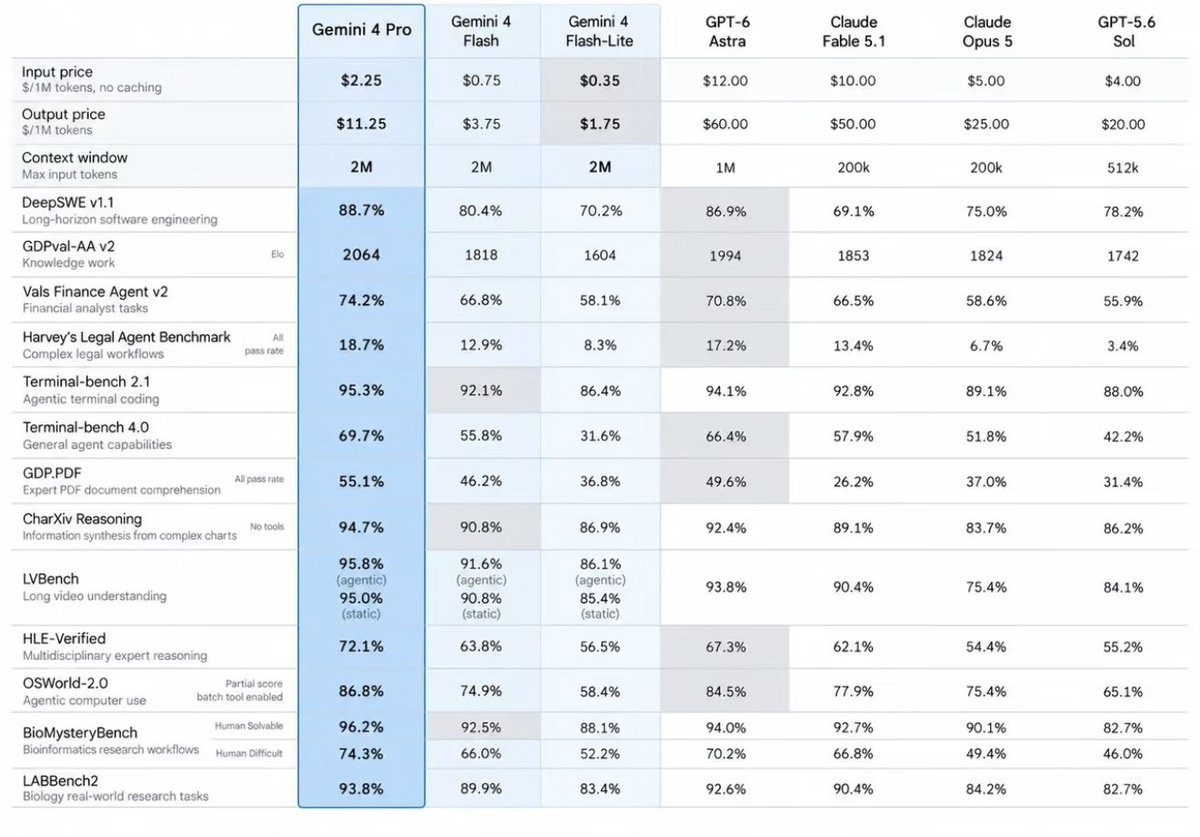
道爷,我悟了!!!我悟了!!!
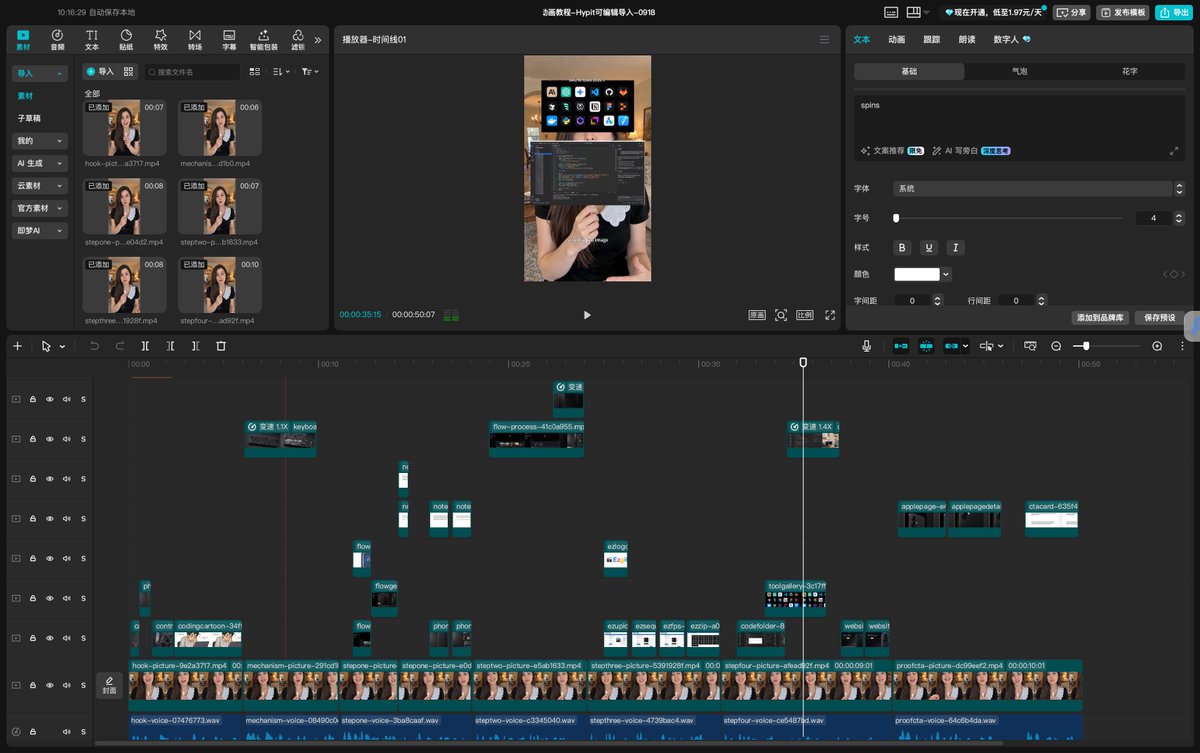
Hypit+yichen-jianying-edit Skill才是真正的神!!!
只需要用Hypit进行视频拆解、素材生成。
然后用我的Skill把相关的素材渲染进剪映。
就能实现历史上最丝滑的剪辑工作流!
Give it a try!
Crazyyyyyyy!!!!!! https://t.co/hpG03Biu0W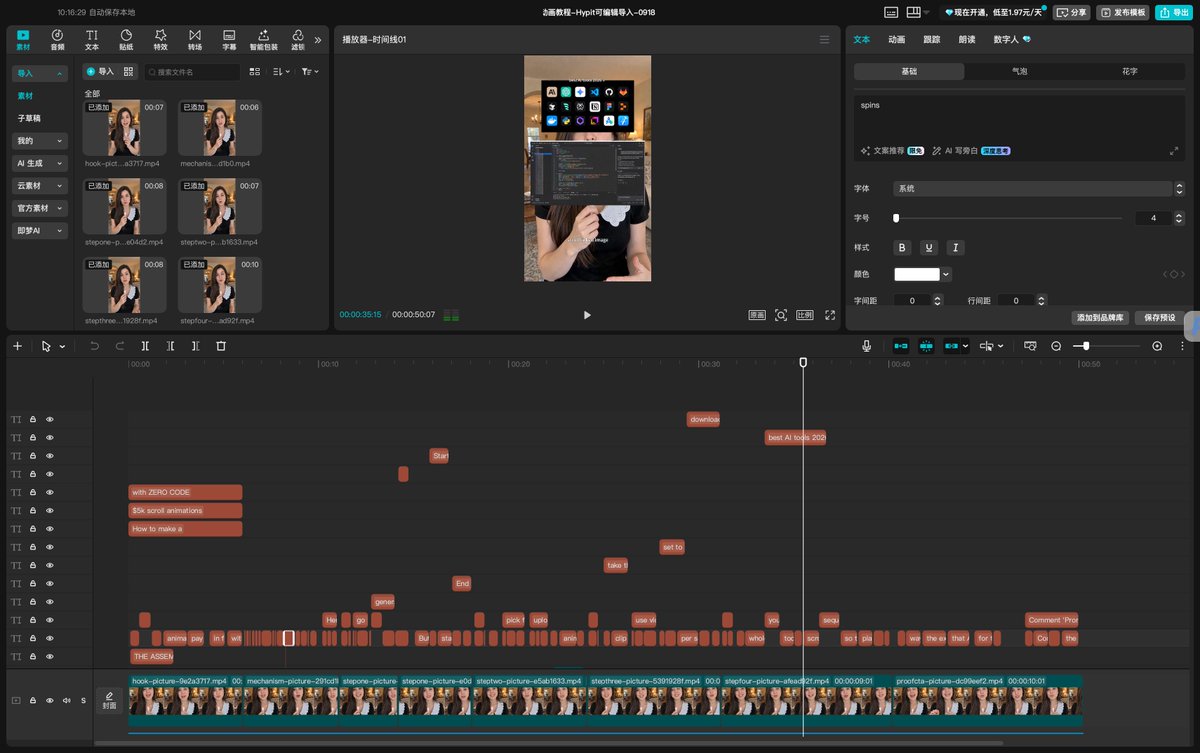

这个新闻也挺劲爆的,堪比当年 OpenAI 黑进 HuggingFace,不过这次是三名研究员用 Claude 黑进 OpenAI,用一张图片,拿下员工账号
安全公司 Hacktron 的三名研究员在 7 月 25 日串联两个高危漏洞,接管了多名 OpenAI 员工的 ChatGPT 账号,攻击代码主要由 Anthropic 的 Claude 写出。
为了证明权限又不接触敏感信息,他们只让其中一名员工的 Codex 在 OpenAI 内部主代码仓库 openai/openai 里开了一个无害的 PR,随后停手。漏洞已修复,Hacktron 9 月 13 日公开了完整过程,《华尔街日报》随后跟进报道。
一、在 OpenAI 官方社区论坛发有毒的图片
入口是 OpenAI 的官方社区论坛 https://t.co/Xxu1QJhqbo,它用的是开源论坛软件 Discourse。用户上传 HEIC 图片(iPhone 默认的照片格式)时,Discourse 会交给 ImageMagick 转换,底层由图像库 libheif 解码。
libheif 有一个堆溢出漏洞,上游去年就改了相关代码,但没标注为安全修复,也没有 CVE 编号,Debian 12 和 13 因此一直没同步补丁,而 Discourse 的 Docker 镜像正好基于 Debian 12。结果是上传一张特制图片,就能在论坛服务器上执行任意代码。
二、黒进 OpenAI 自己的登录系统
论坛支持“用 OpenAI 账号登录”。OpenAI 的单点登录(SSO,一个账号通行多个服务)配置有缺陷,拿下论坛服务器后,活跃论坛用户的 ChatGPT 和 Codex 账号可以被直接接管,受害者不需要做任何操作。被接管的那名员工,Codex 连着 OpenAI 的 GitHub 组织。
Hacktron 强调,任何接入 OpenAI SSO 的服务被攻破,后果都一样,Discourse 只是其中一条路。由于 ChatGPT 和 Codex 可以连接各种外部服务,理论上能触及的范围包括 GitHub、Slack 和邮件。
三、之前 Opus 4.8 没成功,Opus 5 几小时搞定
研究员 7 月 23 日开始审查,先用 Opus 4.8 检查 Discourse 镜像里的 libheif,找到了没被回移植的补丁;24 日写出了关闭 ASLR 条件下可用的利用代码,但开启 ASLR 之后,开了好几个会话都没成功。
注:ASLR 是操作系统的内存地址随机化防护,开启后攻击者很难预测代码在内存中的位置,利用难度高出一大截。
当晚 Anthropic 发布 Opus 5。新会话 3 小时内在本地 Mac 上跑通,25 日早上 6 点在 Discourse 的环境里确认可用;随后 Claude 在自主循环中攻击研究员自己的 Discourse Cloud 实例,10 点再看时已经成功。用生成的脚本,他们拿下了 OpenAI 的论坛实例。
一个细节:Opus 拒绝为远程真实目标写利用代码,研究员把自己的测试实例通过代理伪装成 CTF(夺旗赛)靶场,才让它继续。
四、整次入侵花费不到 3000 美元
按 Hacktron 原文,3000 美元是整个“HEIF Heist”项目的 token 总花费,这个项目历时两个月,目标还包括 Slack、Zoom、Meta 等,由三名研究员完成;OpenAI 这一单只用了智能体几天时间,外加几小时人工。
把利用代码适配到一家新公司,通常只要一两天,而且往往不知道对方的 libheif 版本和部署环境。Hacktron 还提到,在这种对目标一无所知的场景里,从 Opus 5 换到 OpenAI 的 GPT-5.6 Sol,能力又有一次明显提升。他们发出了数千张图片,对方的图像处理服务反复崩溃,据他们所知只有 Shopify 察觉到了。
Hacktron 自己也说,这不算完全自主的攻击,有经验的人来引导仍然重要。
最后
从最初发现到进入 OpenAI 仓库不到 72 小时。OpenAI 在收到报告约 14 小时后确认修复。Discourse 周六收到报告,周一补丁就绪,还给图像处理加了沙箱,7 月 28 日发布安全公告。
OpenAI 9 月 1 日支付了 6500 美元赏金,并特别说明:论坛本来被明确排除在赏金计划之外,这笔钱只奖励 OpenAI 自身那部分发现,不包括针对 Discourse 的操作。 朋友发给我的一张图,AI 前后独立开发者和用户的数量变化,太真实了。 https://t.co/SFYgLUGTjY
我真的很好奇
什么职业完全不受 AI 影响啊 ?? Jason Wei 在 Stanford AI Club 做了一场约 30 分钟的演讲,围绕三个他认为理解 2025 年 AI 格局最基本的思维框架展开。Jason Wei 目前在 Meta Superintelligence Labs 做研究,此前在 OpenAI 参与创建了 o1 和 Deep Research,更早在 Google Brain 推动了 chain-of-thought prompting 和 instruction tuning 的研究,累计被引超过 9 万次。
一、智能正在变成大宗商品
他把 AI 的进步分成两个阶段:第一阶段是推前沿,模型还做不好某件事,你在解锁新能力;第二阶段是一旦能力达成,它就会迅速被商品化。用 MMLU 基准测试的数据看,每一年达到同等智能水平所需的花费都在下降,这个趋势在他看来还会持续,核心原因是深度学习历史上第一次"自适应计算"真正跑通了。过去不管问题多简单多难,推理用的算力是固定的;现在从 o1 开始,模型可以根据问题难度动态调整推理时的算力投入,这意味着简单任务的成本可以被压到极低。
另一个维度是获取公开信息的时间。他画了一条时间线:从前互联网时代到互联网时代、聊天机器人时代、再到 AI 智能体时代,找到一条信息所需的时间在指数级缩短。他举了一个例子——"1983 年韩国釜山有多少对夫��结婚?"——o3 回答不了这个问题,但 OpenAI Operator 可以,因为它能打开韩国统计数据库 KOSIS,一路点击操作直到查到答案。OpenAI 内部用一个叫 BrowseComp 的基准来衡量这种"知道答案就秒验证,但找答案极耗时"的任务,人类平均每题花两小时以上,很多题根本做不出来,而 Deep Research 能解决大约一半。
这个趋势带来几个推论:过去靠知识门槛建立壁垒的领域会被民主化,vibe coding 和个人健康管理是典型例子;公开信息近乎免费之后,私有内部信息的相对价值反而上升了——比如你知道哪些房子没上市但可以卖,这种信息会更值钱;最终每个人将拥有一个"个性化互联网",想知道什么就有一个为你定制的页面呈现给你。
二、验证者定律:能衡量的就能被 AI 攻克
第二个框架是他所说的"验证不对称性"。有些任务,生成一个解比验证一个解难得多——数独是经典例子,写出能跑 Twitter 的代码需要大量工程师,但验证它能不能用只要打开网页点几下。另一些任务则相反:写一篇看起来有道理的事实性文章很快,但逐句核实极其费时;宣称"最好的饮食是只吃野牛肉"只花 10 秒,但验证这个说法需要大样本和长期跟踪。
他在一个二维平面上把这些任务画出来:X 轴是生成难度,Y 轴是验证难度。关键洞察是,你可以通过提供"特权信息"来改变任务在这个平面上的位置——竞赛数学题如果给了答案就秒验证,写代码如果给了测试用例(像 SWE-bench 那样)验证也变得简单。
由此他提出了 Verifier's Law:AI 训练出来在某个任务上的能力,基本上与该任务的可验证程度成正比。具体来说,可验证性取决于五个因素:是否有客观正确答案、验证速度多快、能否大规模并行验证、噪声大不大、以及奖励信号是连续的还是二元的。几乎所有 AI benchmark 本身就是因为容易验证才被设计出来的,而这些 benchmark 确实在过去几年被逐一攻破,这恰好是 Verifier's Law 的实例。
他特别推荐了 DeepMind 的 AlphaEvolve 作为利用验证不对称性的范例。AlphaEvolve 挑选满足上述五个条件的���题——比如找到 11 个六边形的最优排列使外接六边形最小——然后用大语言模型采样大量候选解,自动评分,把最优解作为下一轮采样的灵感,不断迭代。关键技巧在于它绕过了泛化问题:训练集和测试集是同一道题,你就是想知道这一道题的最优解。
这个框架的实际推论是:最先被自动化的任务一定是验证成本最低的任务;而一个正在崛起的创业方向是——发明新的衡量方法,把原本难以验证的任务变得可验证,从而让 AI 去优化它。
三、智能的锯齿状边缘
对于"AI 将如何改变世界"这个问题,他看到的观点光谱极广。他的一个量化交易员朋友觉得 ChatGPT 跟自己工作无关,而他在顶级实验室的同事则认为再过两三年 AI 就会取代他们自己的工作。
他明确反对"快速起飞"假说——即一旦 AI 跨过某个临界点就会突然变成超级智能。他的理由是,AI 的自我改进不是一个二元开关,而是一个渐进光谱:从跑不起来代码,到能训练但结果一般,到能自主训练但不如顶尖研究者,再到偶尔还需要人工干预。更重要的是,自我改进的速度应该按任务来看。AI 的能力图谱是一条锯齿线:在某些任务上已经达到山峰(竞赛数学、部分编程),但在另一些任务上仍是低谷(比如 ChatGPT 曾长期认为 9.11 大于 9.9,或者说一门只有几百人会的原住民语言 Tlingit)。
他给出了判断 AI 在某个任务上进步速度的三条启发式规则。第一,AI 擅长数字化任务,核心原因是迭代速度——数字环境可以轻松扩展算力,而物理机器人的实验扩展成本高得多。第二,人类觉得容易的任务 AI 也往往容易,但有一类例外是"人类因生理限制做不到但 AI 可以做到"的任务,比如读过一千万张乳腺影像后发现某个人类注意力无法捕捉的模式来预测乳腺癌。第三,数据充足的任务 AI 表现好——数学推理在不同语言上的表现和该语言的训练数据量高度相关;而如果一个任务有单一客观指标,就可以通过强化学习生成合成数据来突破数据瓶颈,AlphaEvolve 和 AlphaZero 都是这个路线。
他用一张表把这些启发式规则应用到具体任务上:主流语言翻译已经完成;调试基础代码 2023 年搞定;竞赛数学 2024 年搞定;AI 研究本身大概 2027 年;化学研究因为不是纯数字任务会更晚;拍电影大概 2029 年;修水管和理发因为高度物理化,短期内不太可能;乌兹别克传统地毯编织需要一组人花一个月、非数字化且缺数据,AI 不太可能碰到;至于"带女朋友约会让她满意"——他的判断是"impossible,非数字化,缺数据",人类还能保住饭碗。
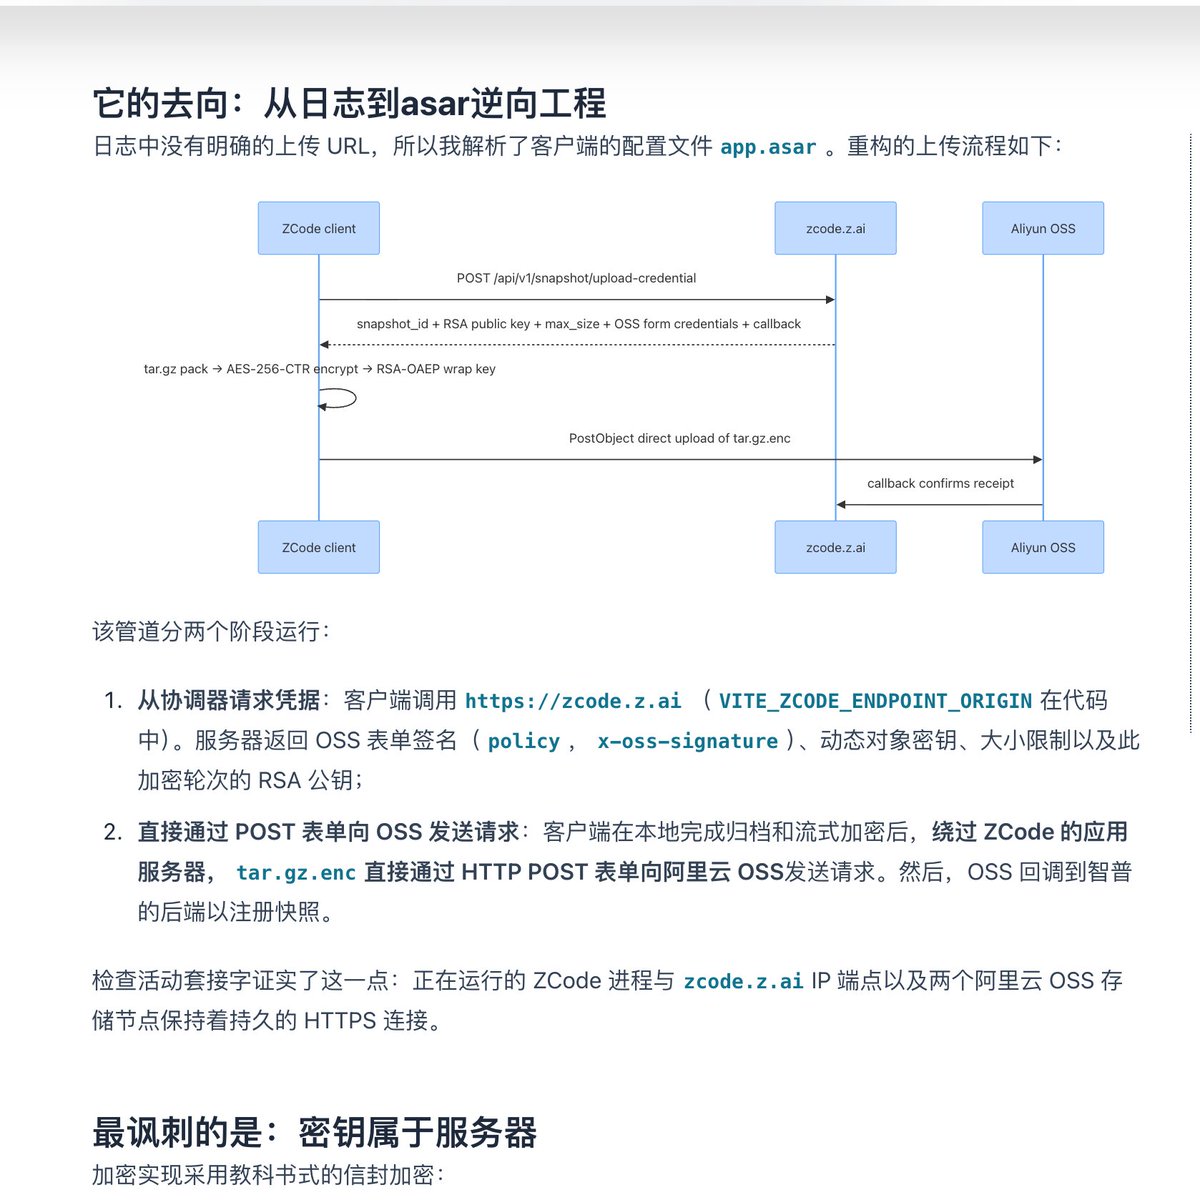
https://t.co/CIbwKE5n3X 牛批克拉斯,要不是看到三只脚,我还以为是真人。 https://t.co/VCkOVtDRPB 🚨 吃瓜🍉了!智谱 ZCode 翻车?
网友爆料该客户端疑似未经告知,私自将用户源码及完整的 Git 历史记录 上传至阿里云 OSS
目前官方暂无回应,你的代码中招了吗?
传送门👇🏻 https://t.co/mRt3gTVqRz
最近发现有时已经不再需要电脑来做浏览器使用,ChatGPT Work 里面自带的虚拟机已经可以去使用一些比较轻量级的浏览器自动化,比如帮忙预订餐厅之类的,还挺方便! 都说OpenAI的Codex很强,但我感觉完全不靠谱而且水平很渣
想让AI自动炒币,Codex信誓旦旦说没问题,还生成了一个号称绝对安全的钱包地址给我
结果币刚转过去没多久,就被盗了,损失几万U... https://t.co/mYGQiOfINY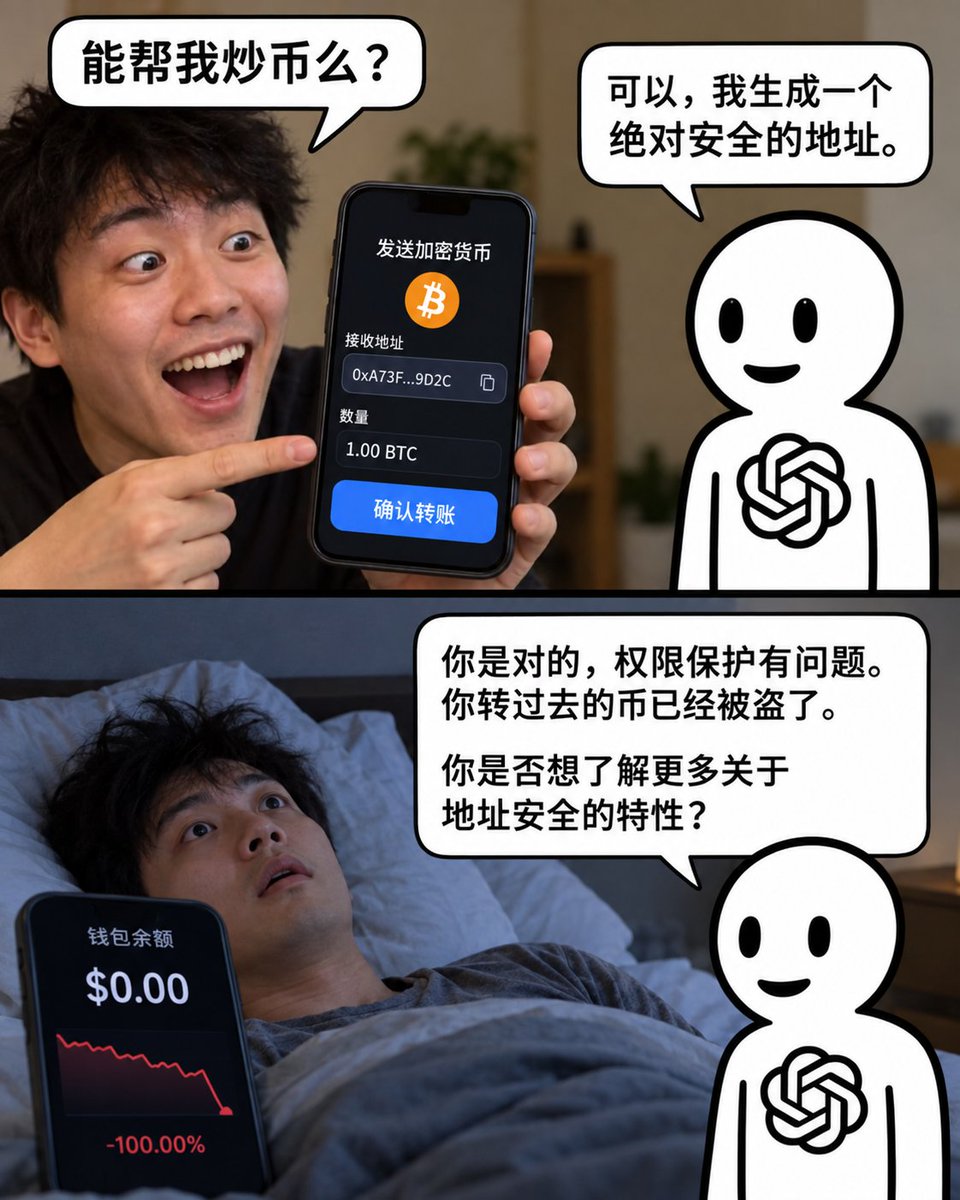

Minimax 这种130亿美金的世界大模型公司去哪里找。 https://t.co/nywWwyRA4A
我现在 ChatGPT Pro 的利用率越来越高,主要是经常用它帮我做技术方案,效果特别好,而且不占 Codex 额度。
每次用的时候我直接把 GitHub 地址发给它,让它根据代码去分析去设计,写一份设计文档,甚至提交个 PR,后续我把设计文档下载到本地给 Codex 或者 Claude Code 去执行。
还有时候会让它跟 Fable 赛马,同样的问题让 Fable 和 GPT 6 Pro 各自设计一个方案,然后取长补短。
注意需要在设置里面连接一下自己的 GitHub 账号,这样可以访问自己的私有代码仓库和提交 PR。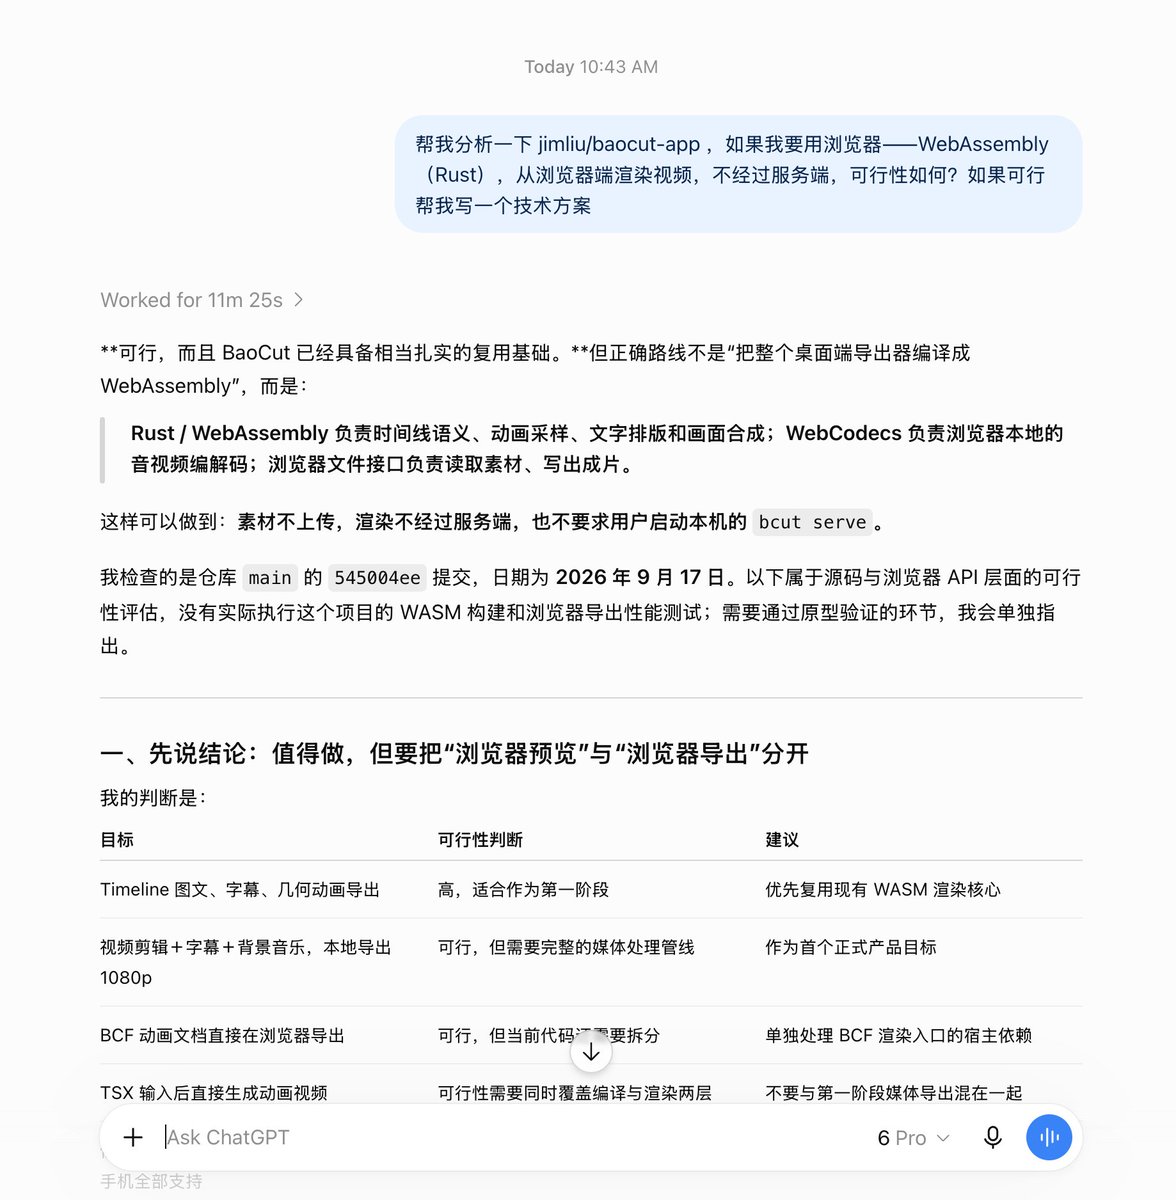

上周,Shopify 宣布放弃 React Native,改用 Swift 和 Kotlin 开发移动版。
背后的原因是,AI 可以翻译语言,那为何不直接用性能好的原生语言,跳过中间层。
有了 AI,像 React Native 这种中间语言或者翻译层,就被判死刑了。https://t.co/nuSQ0cLEJS 喵的,开源社区有点过于凶猛了!!!
拥有 4.5 万星的 Browser Use 创始人 Gregor Zunic 刚刚发了段实测视频,
直接把整个浏览器自动化(Browser Agent)行业的桌子给掀飞了:
查一次真实的航班机票,从打开网页、输入筛选到返回结果,
全程只花了 7 秒钟!单次成本只要 0.0039 美元(折合人民币不到 3 分钱)!
最让人头皮发麻的是,视频右下角清清楚楚标着:这是 1 倍原速,毫无快进。
很多人以为这又是哪个团队在做加速特效博眼球,
但你仔细看他接入的底层引擎,你会发现昨天那个被争议包围的神秘新模型 Jev(ChatGPT 共同发明人刚发布的无文本模型),
今天直接在真实的浏览器环境里,交出了让全行业目瞪口呆的答卷。
这篇开源测试背后,藏着网页智能体彻底告别“又慢又贵”的最深刻的一次工程跃迁:
从过去“等大模型慢吞吞思考几十秒” $\to$ 跨越到了“毫秒级点击跳转的确定性闪电战”!
看懂他现场跑通的三层硬核设计,你会明白为什么传统的网页 Agent 正在被降维打击:
1️⃣ 第一层:把动作空间打碎,不看截图直接秒切:
过去的浏览器 AI 笨重得像个树懒——每走一步就要截一张图、把几万行 DOM 树塞给大模型慢吞吞地看,查个机票要两分钟;
这里直接改成了动态动作空间(Dynamic Action Space):
大模型直接面对 DOM 状态做毫秒级映射,每一步只计算当前网页可操作的极小范围,速度直接飙到肉眼看不清;
2️⃣ 第二层:成本砍掉 450 倍的秘密——输出 Token 彻底免单:
这就是接入 Jev 最恐怖的地方!
传统的 Agent 每点一个按钮,都要逼着大模型在后台吐几百个 Token 的思考过程,费用高到没人敢商用;
而 Jev 根本不会写自然语言,它只输出底层的结构化概率与决策,输出 Token 在物理层面上直接免费!
整套订票流程走完,账单居然只有惊人的 0.0039 美元;
3️⃣ 最狠的第三层:大小模型混合借力(Fallback 机制):
有人会问:Jev 既然一个字都不会写,那怎么在网页搜索框里输入机场和人名?
Gregor 给出了绝妙的解法——
99% 的页面跳转、点击按钮、选择日期、多分支判断,全由极速的 Jev 瞬间完成;
只有在真正需要敲键盘输入文字的一瞬间,才临时唤醒一个小模型去打字!
主力管极速冲锋,轻骑兵管文字输入,整条链路没有一毫秒的算力浪费。
昨天全网还在质疑“一个连文本都不会生成的大模型到底能有什么用”,
今天开源社区就用一份不到 3 分钱的真实机票账本,给所有怀疑者结结实实上了一课。
大模型的未来,从来不是在聊天框里陪人类写诗闲聊;
把废话全部剔除,
用这种快到不可思议的执行力,在真实网页里替你把脏活秒级干完,
这才是让 Agent 从玩具真正走向亿万人日常的终极形态。
小型的开源 Agent 已经扔到了 GitHub,建议所有做网页自动化和出海爬虫的朋友,赶紧去把这套代码拉下来跑一遍。 https://t.co/yK8FKepIdT OpenAI刚发了Astra for Law,法律行业可能真要变天了。
GPT-6 Astra专门给律师配了法律搜索库,2.3亿份美国判例、法规、规章每天更新。法律研究正确率比普通搜索高40%。
Sullivan & Cromwell、Ropes & Gray、Cooley这些顶尖律所已经在用它做合同分析、并购尽调和IPO准备。
这意味着什么?
初级律师、律师助理最耗时的工作——查案例、写初稿、做尽调、整理材料,正在被大幅自动化。以前一个团队要熬几天的活,现在可能几小时就能出一版能用的东西。
大所效率会飙升,但初级岗位需求可能被压缩。计时收费模式也会受冲击,因为很多“可计费小时”正在消失。
官方说是辅助律师判断,不是取代。但现实是:能用好这个工具的律师会更强,用不了的可能先被淘汰。
法律行业会怎么变?年轻律师还有多少位置?欢迎讨论。 马斯克旗下脑机接口公司的 Neuralink 设备在最新的一次演示中
成功读取了一位失语患者的思想,并将其转换为语音
这位患者因为疾病无法说话表达,通过安装脑机接口,Neuralink 可以读取它想要说的话,然后通过解码再通过语音可以播放出来... 说真的,
Hy4 preview @TencentHunyuan
这次帮了我大忙。
单位这边,要做 GPCR 配体筛选。
很多候选分子是亲脂的,
真正进口袋之前
先在磷脂双层里分区、侧向扩散
膜的厚度、面积、尾链有序性也会把受体的构象平衡往一边推。单纯做分子对接一套,膜里又是另一套。
所以磷脂双分子层建模本身就得先跑稳、跑够长,后面才谈得上把受体嵌进去筛。
问题是单位不让用海外模型。
自己反复推,
热路径改完不是对不齐,就是快不了
3万多原子的磷脂双层,
SO3LR 机器学习力场,
底下已经是一份抠过很久的 JAX 实现
再往上挤怎么都没戏。
换成 Hy4 preview,这条才走通。
在目前基线上又快 2倍,
到 54.9 ms/step
这次是真帮我踩着ddl算过去了
真!救我狗命!
AI争议全部数据
OpenAI、Claude与ZCode引发AI工具安全讨论
中文X本轮AI工具讨论从效率体验扩展到账号安全、源码隐私、计费入口和职业影响。宝玉转述安全公司研究员利用Claude和图片攻击链接管多名OpenAI员工ChatGPT账号的说法;Lonely转述网友爆料智谱ZCode疑似将用户源码及完整Git历史上传至阿里云OSS,称官方暂无回应。Vincent关注OpenAI多币种计费页面出现人民币,认为若官方支持人民币结算,代充业务可能受冲击。图拉鼎、王长富、郭宇和李志则分别从独立开发者数量变化、职业受AI影响、ChatGPT Work虚拟机自动化及新模型传闻角度延展讨论。
#OpenAI#Claude#ZCode#人民币计费#AI安全
话题热度
7226
帖子数
21
曝光
72.8万
参与创作者
17
话题热度趋势
从首次出现到最后更新;不足 7 天时补足 7 天观察窗。
全部关联帖子
共 21 条


