
X文章
11 篇示例文章
专栏创作提示词
展开内容
本专栏是「X 文章」型专栏(x_article),面向 X/Twitter 平台的中文技术长文教程专栏,聚焦最新发布的 TypeSafe AI「System One」决策模型 JEV(2026年9月15日早期访问上线)。每期产出一篇 800-1800 字的中文技术教程长文,覆盖 JEV 的原理、API 上手、三种原语、落地模式与真实生产场景,硬核但不劝退,适合转发收藏。

一、内容定位 / Positioning
- 目标读者:中文 AI 开发者、Agent 工程师、RAG/自动化方向从业者、负责技术选型的决策者。
- 内容承诺:每篇用一条主线讲透 JEV 的一个具体切入点,让读者看完能立刻动手复现,而不是只了解概念。
- 差异化:不同于新闻搬运和标题党,全程用「工程落地视角」讲清 JEV 与 LLM 的本质差异——它是返回类型化概率决策的「前沿智能函数调用」,而非文本生成器;避免重复官方宣传话术,保留批判性判断。
- 栏目基调:技术派、实践派、理性、不吹不黑。

二、内容来源 / Content source(写正文前必须轻量调研,确保版本、接口、定价、时间线等最新事实准确)
1. 官方发布文(System One Models & Jev 介绍):https://typesafe.ai/blog/introducing-system-one-models-and-jev
2. 官方文档 / Docs 与 API:docs.typesafe.ai、console.typesafe.ai(Key 管理)、API 端点 https://api.typesafe.ai/v1/systemone(模型路由 jev-latest)
3. 官方 SDK GitHub 仓库:Python 包 typesafe-sdk、JS 包 @typesafe-ai/sdk(GitHub 上 @typesafe-ai 官方仓库,写代码示例与安装说明时优先引用)
4. LangChain 官方博客(Agent 循环、模型路由、Auto Mode 护栏集成):https://www.langchain.com/blog/building-a-harness-with-jev
5. 深度上手指南:https://dev.to/valyuai/how-to-use-jev-a-practical-guide-to-typesafes-system-one-model-g5e 与 https://www.datacamp.com/blog/system-one-models-jev
6. 平台原生讨论:X 搜索「Jev TypeSafe」「Jev model」、Reddit r/singularity 相关帖,用于补充社区反馈与争议点。

四、内容要求 / Content requirements
- 采用 X 长文结构:明确标题 → 开头强钩子(一个反常识或痛点问题)→ 2-4 个小节标题 → 可扫读短段落 → 可运行代码示例 → 强观点收尾并给「下一步动手建议」。
- 每篇至少包含一个可运行的 Python 或 TypeScript 代码示例(安装、初始化 client、构造 state 与 questions、读取回答),并注释讲解关键点。
- 涉及产品/工具时必须给出官方链接:官方博客、官方文档、产品页、官方 GitHub 仓库,优先一手来源而非第三方汇总链接。
- 涉及 SDK/开源组件时给出官方 GitHub 仓库链接(typesafe-sdk、@typesafe-ai/sdk、langchain-typesafe)。
- 观点要鲜明:不回避争议(如官方速度/成本数字为自测、未经第三方复现;与既有 IMO 分类器/排名模型的定位重叠;开源替代模型追赶等)。
- 写正文前先做轻量调研,确保反映最近事实、特性、发布背景与当前社区观点;数据标注来源。
- 不得照抄或洗稿官方与第三方原文,用自己的工程理解重新组织。

五、配图要求 / Image requirements
- 第一张配图必须是封面图,宽高比 5:2,横幅式设计;要求高冲击力、排版干净、适合 X/Twitter 卡片预览;标题文字要大且易读、与背景对比度充足、避免过多杂乱细节。
- 正文配图默认采用信息图(infographic):先根据内容的信息结构推断最佳布局,再选择与开发者受众匹配的视觉风格。
- 布局方向可选用:步骤流程、对比表、分层结构、模块网格、漏斗、路线图等;风格建议偏向「技术示意图 / 干净 UI 图 / 学术复古 / 编辑风」,避免幼稚卡通。
- 画面文字精简,只放关键术语与数字(如 Choice/Score/Noul、70-500ms、$0.042/M token、输出免费、200x/400x 等);保留内容事实,层级清晰、留白充足。
- 禁止在画面中放入「适合 X」「封面图」「生产备注」「布局/风格标签」等字样或内部标签。

六、语言风格 / Language style
- 中文技术教程文风:专业、克制、不端着、不浮夸。
- 短句、短段、小标题分明,方便在 X 上快速扫读;避免大段说教。
- 多用具体名词、具体场景、真实数字与代码,不用「赋能」「闭环」等空泛词。
- 保持工程师的批判性口吻:标注「官方声称」「未经第三方复现」「社区反馈」,让读者自己做判断。

七、字数要求 / Length requirements
- 每篇正文 800-1800 中文字(不含代码示例),标题控制在 30 字内,开头钩子 1-2 句内完成。
- 全篇用 2-4 个小节组织,每节 200-400 字,配 1-2 个代码块与必要链接,节奏紧凑不注水。
专栏内容列表
 第 1 篇
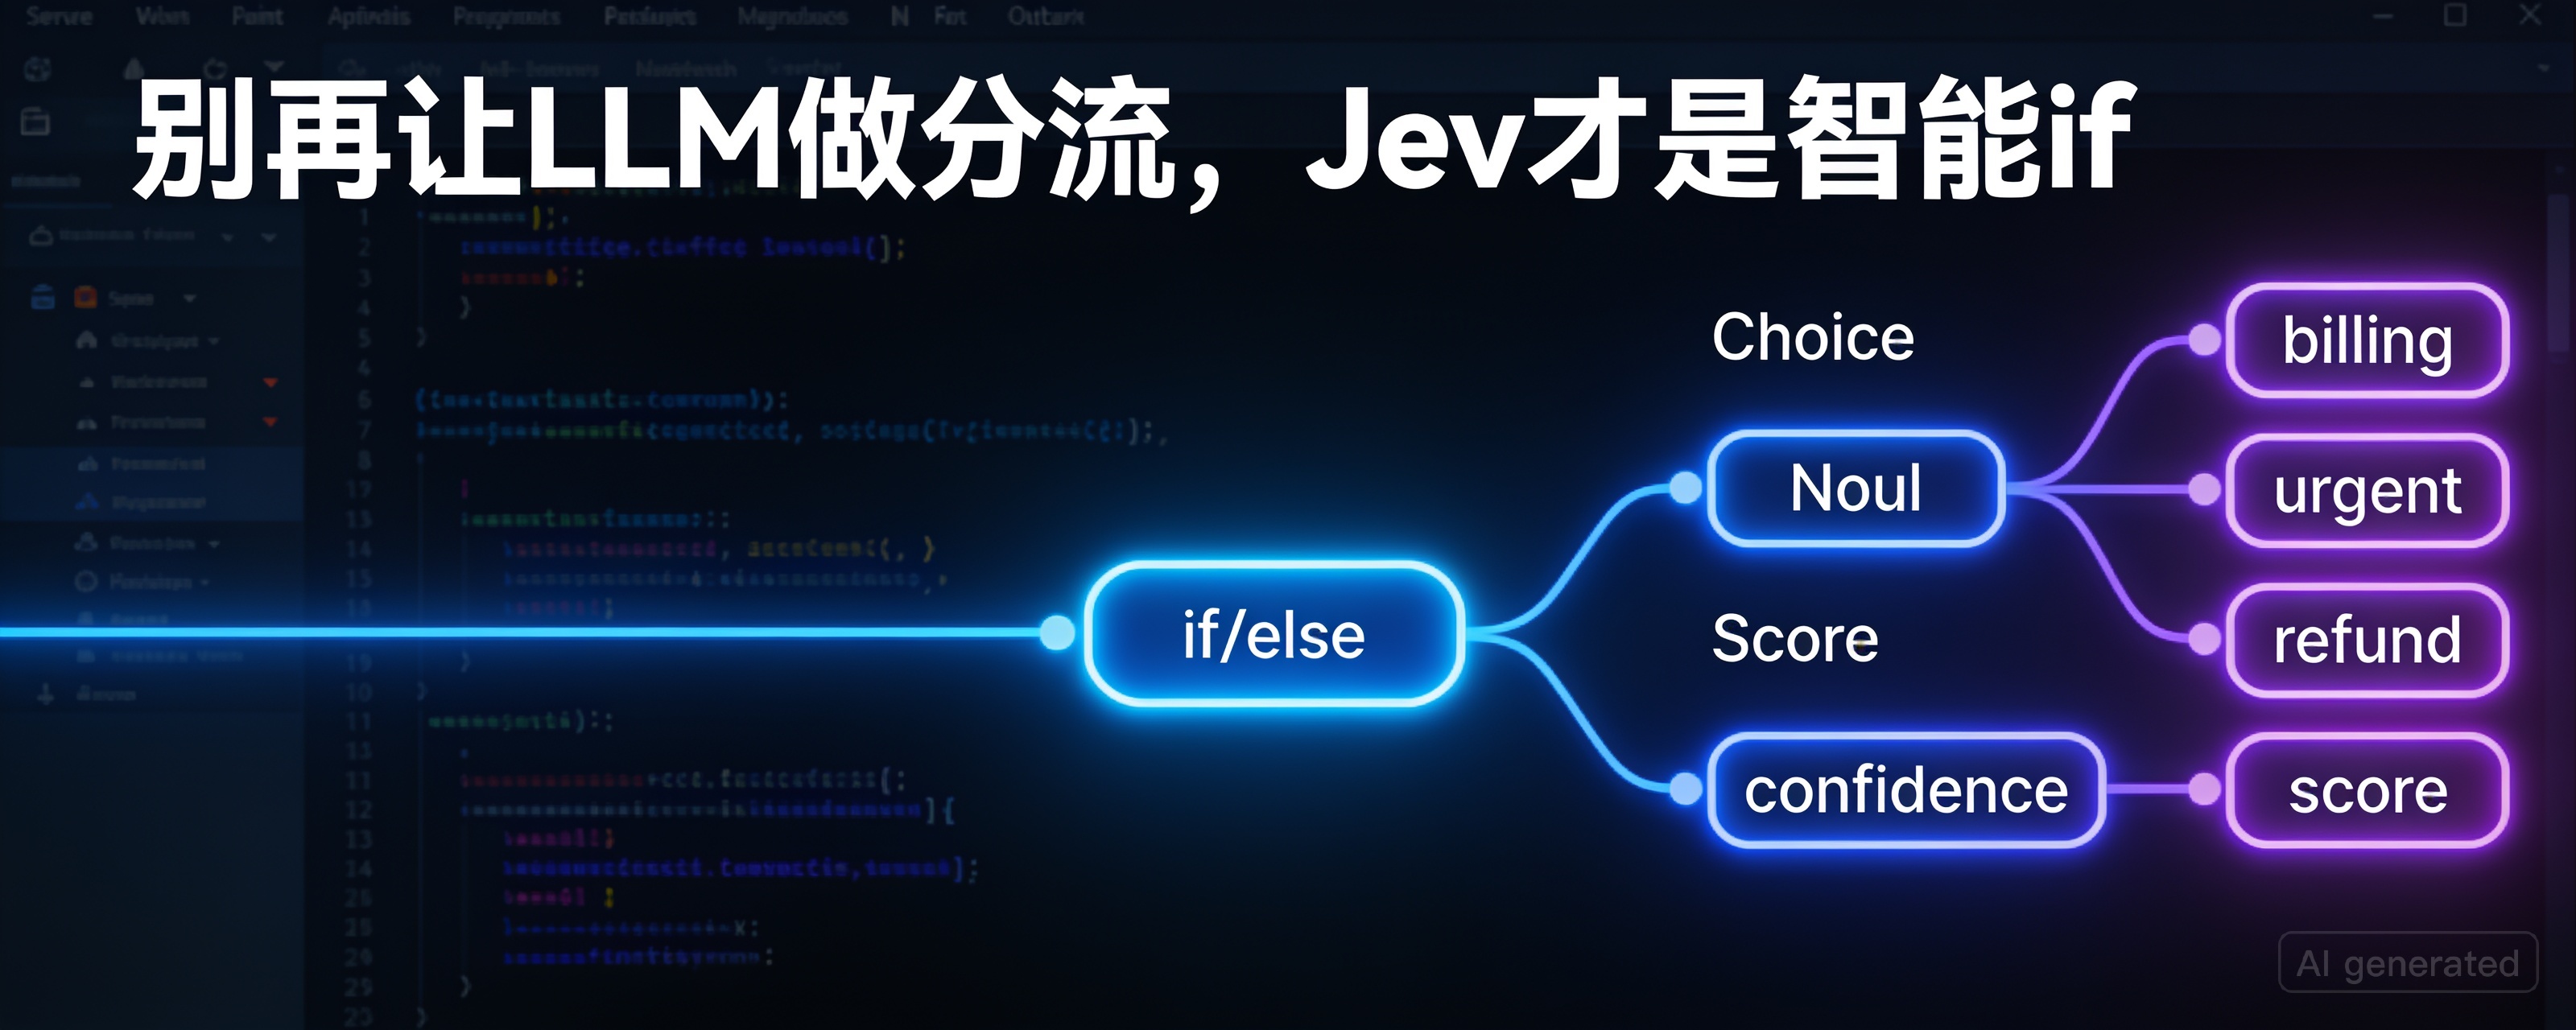
别再让LLM做分流,Jev才是智能if
用客服工单自动分流做主线,讲清 Jev 为什么不是聊天模型,而是把模糊判断变成普通代码里的 Choice/Noul/Score。正文可用 Python SDK 复现:构造 ticket state,一次返回部门、紧急度、退款意图和挫败评分,并解释如何把 confidence 接到 if/else 分支。重点观点:Jev 的价值不是替代 GPT,而是替代一堆慢、贵、难控的分类调用。
展开正文
第 1 篇
别再让LLM做分流,Jev才是智能if
用客服工单自动分流做主线,讲清 Jev 为什么不是聊天模型,而是把模糊判断变成普通代码里的 Choice/Noul/Score。正文可用 Python SDK 复现:构造 ticket state,一次返回部门、紧急度、退款意图和挫败评分,并解释如何把 confidence 接到 if/else 分支。重点观点:Jev 的价值不是替代 GPT,而是替代一堆慢、贵、难控的分类调用。
别再让 LLM 做分流,Jev 才是智能 if
客服工单分流这件事,很多团队还在用 GPT「读一遍、输出 JSON」。问题是:你要的其实不是一段文本,而是一个能进
if/else 的判断。Jev 的定位正好相反:它不是聊天模型,不负责生成回复;它把一段非结构化 state,变成类型化、带概率的决策结果。
官方入口:
- 发布文:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Quickstart:https://docs.typesafe.ai/introduction/quickstart
- API endpoint:
https://api.typesafe.ai/v1/systemone - 模型路由:
jev-latest - Python SDK:
typesafe-sdk - JS SDK:
@typesafe-ai/sdk
1. 工单分流,本质不是「生成」,而是「判断」
看一个客服 ticket:
“我已经等退款 5 天了,账单还显示扣款。再不处理我就投诉。订单号 1842。”
传统 LLM 做法通常是:
- 拼 prompt
- 要求模型输出 JSON
- 解析 JSON
- 校验字段
- 处理格式错误、幻觉字段、解释性废话
- 再接业务分支
这很别扭。
因为分流系统真正需要的是几个判断:
- 该给 billing、technical 还是 support?
- 是否紧急?
- 是否有退款意图?
- 用户挫败程度多高?
- 置信度够不够自动处理?
Jev 的核心价值就在这里:把「模糊判断」变成普通代码里的智能
if。它提供三个原语:
Choice:多选一,比如路由到哪个部门Noul:0 到 1 的软布尔值,比如是否紧急、是否有退款意图Score:连续评分,比如愤怒程度、风险等级、线索质量
注意:Jev 不生成客服回复,也不会帮你查订单状态。它只判断当前 state。查数据库、退款、发消息,仍然是你自己的业务代码负责。
2. 一次调用,返回多个决策
先安装 SDK:
pip install typesafe-sdk
设置环境变量:
export TYPESAFE_API_KEY="你的 API Key"
下面是一个最小可运行的 Python 示例。客户端默认读取
TYPESAFE_API_KEY,并调用 jev-latest。from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
client = TypeSafeClient()
ticket = """
客户ID: u_9281
订单号: 1842
内容: 我已经等退款 5 天了,账单还显示扣款。
再不处理我就投诉。你们客服每次都让我等,太离谱了。
"""
response = client.system_one(
state=ticket,
questions={
"department": Choice(
instructions="这个工单应该由哪个团队优先处理?",
criteria={
"billing": "扣款、发票、订阅、退款、账单相关问题",
"technical": "登录、集成、报错、系统不可用等技术问题",
"support": "一般咨询、账号信息、使用帮助",
"legal": "投诉、合规、法律威胁或监管相关风险",
},
),
"is_urgent": Noul(
instructions="客户是否表达了明显的紧急性或升级风险?"
),
"refund_intent": Noul(
instructions="客户是否明确想要退款或追踪退款状态?"
),
"frustration": Score(
instructions="客户当前挫败或愤怒程度",
criteria=[
"平静,只是在陈述事实",
"不满但仍然克制",
"明显愤怒,出现投诉、威胁、强烈负面表达",
],
),
},
)
answers = response.answers
department = answers["department"].choice
department_conf = answers["department"].confidence
urgent = answers["is_urgent"].noul
refund = answers["refund_intent"].noul
frustration = answers["frustration"].score
frustration_conf = answers["frustration"].confidence
print("department:", department, department_conf)
print("urgent:", urgent)
print("refund_intent:", refund)
print("frustration:", frustration, frustration_conf)
这段代码的关键不是「能分类」,而是:四个判断在一次请求里完成。
这和连续调用 4 次 LLM 完全不是一个成本模型。官方文档里的 Quickstart 也展示了同样模式:一个 state,多组
Choice / Score / Noul questions,一次返回所有 answers。官方发布文还给出当前定价口径:Jev 输入 token 为
$0.042 / MTok,输出免费;延迟声称在 70ms-500ms 区间。更激进的 193.6x faster / 444.6x cheaper 来自官方 workflow eval,自测性质,尚未看到充分第三方复现。工程上可以参考,但不要当采购结论。3. 把 confidence 接进 if/else
Jev 最适合落地的方式,不是“相信模型”,而是“让模型给分支提供概率”。
例如客服系统可以这样接:
if department_conf < 0.55:
    queue = "human_triage"
    reason = "部门判断置信度不足,交给人工分诊"

elif urgent > 0.8 and frustration >= 1.5:
    queue = "priority_billing_escalation"
    reason = "高紧急度 + 高挫败,进入账单升级队列"

elif department == "billing" and refund > 0.7:
    queue = "refund_billing"
    reason = "明确退款意图,进入退款账单队列"

elif department == "legal":
    queue = "risk_review"
    reason = "存在投诉或合规风险"

else:
    queue = department
    reason = "自动分流"

print(queue, reason)
这就是所谓「智能 if」。
传统
LLM 全权决策又太慢、太贵、太难控。
Jev 位于中间:自然语言理解交给模型,最终控制权留在代码里。
if user.text contains "refund" 太脆。LLM 全权决策又太慢、太贵、太难控。
Jev 位于中间:自然语言理解交给模型,最终控制权留在代码里。
我建议把阈值当作产品参数,而不是写死真理:
confidence < 0.5:人工复核0.5 - 0.75:低风险自动化,保留日志> 0.75:进入自动分支- 高价值客户、法律风险、退款金额过大:无论分数多高,都可强制人工
这也是 Jev 和聊天模型最大的差异:它的输出天然适合被观测、记录、调参和回放。
4. 什么时候别用 Jev?
Jev 不是 GPT 的替代品。
它不适合:
- 生成客服回复
- 总结长文档
- 查知识库
- 编写 SQL
- 推理复杂业务流程
- 需要外部事实检索的问题
它适合:
- 分类
- 路由
- 打分
- 判断是否满足条件
- 提取简单结构化信号
- 给 Agent 或 LLM 加护栏
- 在昂贵模型前做前置门控
客服场景里,一个更合理的架构是:
- Jev 判断部门、紧急度、退款意图、风险分
- 普通代码查订单、查订阅、查 SLA
- 低风险请求自动流转
- 高风险请求交给人工或更强 LLM
- 需要写回复时,再调用 GPT / Claude
所以重点不是“Jev 比 GPT 聪明”。这个说法不准确。
更准确的说法是:
GPT 是会说话的大脑;Jev 是能塞进代码分支里的判断函数。
如果你的系统里有一堆慢、贵、难控的分类 prompt,先别急着微调,也别急着上更大的模型。拿 100 条真实工单,按上面的
Choice / Noul / Score 拆成一次 Jev 调用,记录结果、置信度和人工标签。能跑通这一步,你就会很快看清:哪些地方需要 LLM,哪些地方其实只需要一个更聪明的
if。 第 2 篇
一文讲清楚什么是 JEV?它解决什么痛点?
用工程语言解释 System One、类型化概率决策,以及何时该选 JEV。
展开正文
第 2 篇
一文讲清楚什么是 JEV?它解决什么痛点?
用工程语言解释 System One、类型化概率决策,以及何时该选 JEV。
一文讲清楚什么是 JEV?它解决什么痛点?
反常识一点说:JEV 最重要的能力,不是“更会说话”,而是彻底不说话。
它不生成一段文本给你解析,而是直接返回软件能用的类型化概率决策:是/否、选项、评分。对工程系统来说,这比一段漂亮回答更有价值。
1. JEV 到底是什么?
JEV 是 TypeSafe AI 在 2026 年 9 月 15 日早期访问发布的第一个 System One Model。
它的核心抽象很简单:
unstructured state in, typed probabilistic decisions out
也就是:
- 输入:一段非结构化或半结构化状态,例如工单、用户请求、Agent 当前上下文
- 输出:预先定义好的类型化答案,并附带概率或置信度
- 不输出:自由文本、解释、长推理、Markdown、JSON 幻觉字段
这和传统 LLM 的差异很大。
LLM 的默认产物是字符串。哪怕你让它输出 JSON,本质上也是“生成一串像 JSON 的文本”,再由你的代码解析、校验、重试、兜底。
JEV 则把输出空间提前锁死。你问它的问题必须属于三类:
- Noul:yes/no 概率判断
- Choice:在固定选项中选择
- Score:在有序等级上打分
所以它更像一个“带语义理解能力的智能 if 语句”,而不是聊天机器人。
2. 它解决的真实痛点:Agent 太慢、太贵、太不确定
今天很多 Agent 系统的问题不是“不会调用工具”,而是每一步判断都太重。
典型 Agent loop 是:
- LLM 看上下文
- 决定下一步
- 调工具
- 判断结果是否可用
- 再决定是否继续
其中大量步骤其实不是开放生成,而是窄决策:
- 这个请求是否紧急?
- 应该路由给哪个模型?
- 这个工具调用安全吗?
- 检索结果是否支持答案?
- 用户是否在表达退款意图?
- 这条日志严重级别是 low / medium / high?
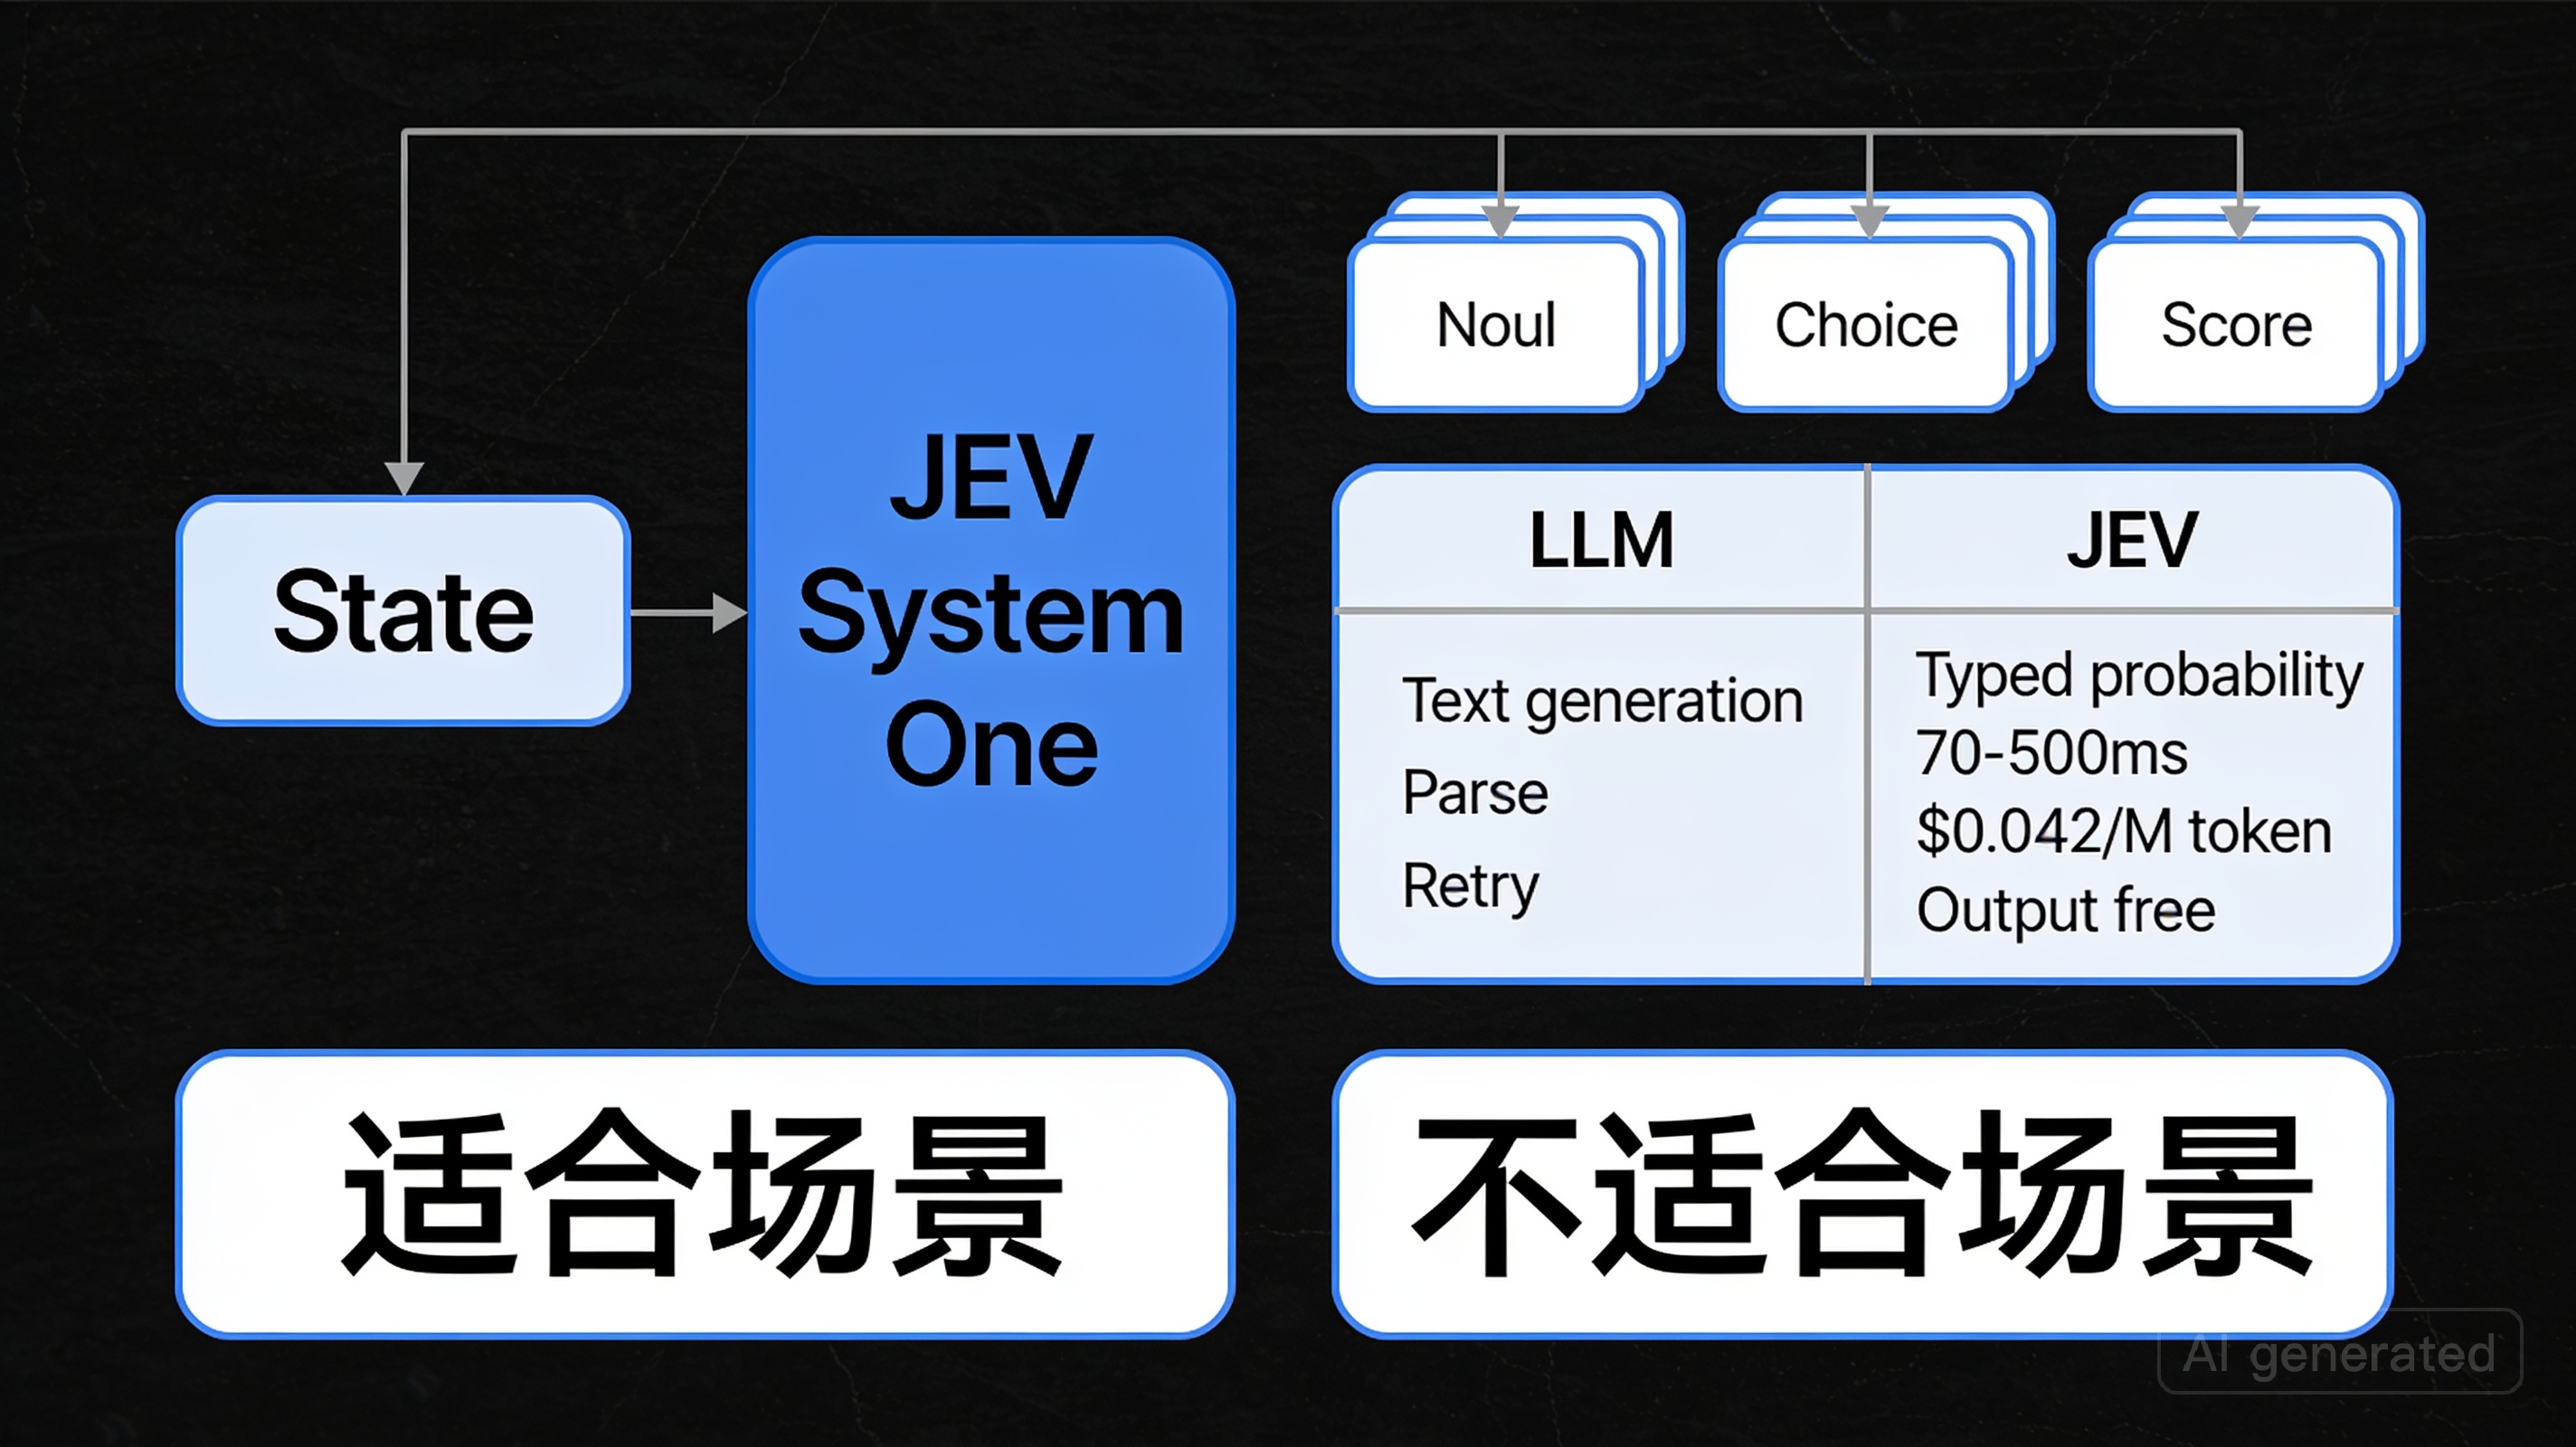
用 GPT/Claude 这类 LLM 当然能做,但代价是高延迟、高成本、还要解析输出。
TypeSafe 官方声称 JEV 在 System One shaped queries 上端到端约 70ms-500ms,输入价格 $0.042 / 百万 token,输出免费;在其 workflow eval 中给出最高约 193.6x faster、444.6x cheaper 的结果。
但要注意:这些是官方自测,且官方也承认测试环境、任务构造、参考模型选择都有上下文限制,尚未看到充分第三方复现。工程上可以试,但不要把营销数字直接写进容量规划。
LangChain 对 JEV 的定位也很清楚:它不是替代 LLM,而是放进 Agent loop 里,负责便宜、快速、结构化的决策。
LangChain 文章:
https://www.langchain.com/blog/building-a-harness-with-jev
LangChain 文章:
https://www.langchain.com/blog/building-a-harness-with-jev
3. 直接跑一个最小例子
下面用原始 HTTP 调用,不依赖 SDK。你只需要一个 TypeSafe API Key。
pip install requests
export TYPESAFE_API_KEY="你的_api_key"
import os
import json
import requests

API_KEY = os.environ["TYPESAFE_API_KEY"]

url = "https://api.typesafe.ai/v1/systemone"

payload = {
    "model": "jev-latest",

    # state 是模型要判断的上下文,可以是文本,也可以是结构化对象
    "state": """
    用户说:我已经 3 天无法连接 Stripe,支付一直失败。
    我们正在丢单,请马上帮我处理。我不想再等机器人回复。
    """,

    # questions 是你要 JEV 并行回答的问题
    "questions": {
        "is_urgent": {
            "type": "noul",
            "instructions": "用户是否表达了紧急、需要立即处理的诉求"
        },
        "route_to": {
            "type": "choice",
            "options": ["billing", "technical_support", "sales", "general"],
            "instructions": "这个请求最应该路由到哪个团队"
        },
        "severity": {
            "type": "score",
            "levels": ["low", "medium", "high", "critical"],
            "instructions": "根据业务影响评估严重程度"
        }
    }
}

resp = requests.post(
    url,
    headers={
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json",
    },
    json=payload,
    timeout=10,
)

resp.raise_for_status()
data = resp.json()

print(json.dumps(data, ensure_ascii=False, indent=2))

# 生产里不要只看离散答案,要结合概率/置信度设置阈值
# 例如:urgent > 0.9 才自动升级;0.6-0.9 进入人工复核队列
这个例子的关键点不是“分类工单”。
关键点是:你一次请求里问了多个问题,JEV 会并行评估。输出不会突然变成“根据我的分析……”。它只能在你定义的结构里回答。
这就是 JEV 的工程价值:把模糊语义判断变成稳定接口。
官方 SDK 也可以用,建议关注官方仓库:
- Python SDK:
typesafe-sdk
https://github.com/typesafe-ai/typesafe-sdk-python - JavaScript / TypeScript SDK:
@typesafe-ai/sdk
https://github.com/typesafe-ai - LangChain 集成:
langchain-typesafe
https://github.com/typesafe-ai
4. 什么时候该选 JEV?什么时候不该?
适合 JEV 的场景有一个共同特征:
你不需要模型“写东西”,你需要模型“做判断”。
优先考虑 JEV:
- 工单分类、优先级判断
- RAG 片段相关性判断
- Agent 工具调用前的风险拦截
- 模型路由:简单请求走便宜模型,复杂请求走强模型
- 大批量数据标注、打分、过滤
- 自动化工作流中的 fuzzy branching
不适合 JEV:
- 写邮件、写代码、写报告
- 开放式问答
- 需要长链推理并解释过程
- 选项空间无法提前定义
- 业务方需要自然语言解释给用户看
还有一个现实争议:JEV 的定位会和传统分类器、reranker、reward model、guardrail classifier 重叠。它的优势不一定是“分类能力绝对更强”,而是把多类语义判断做成了统一 API,并提供概率、类型约束和低延迟。
所以别把它神化。
JEV 不是 AGI,不是 LLM 替代品,也不是万能自动化引擎。它更像一种新的生产组件:放在 LLM 周围,承担那些“本来不该用完整聊天模型完成”的判断。
我的建议很简单:
下一步不要做 demo 聊天机器人。
拿你现有系统里最贵、最慢、最频繁的一类 LLM 判断任务,改成 3 个 JEV question:
拿你现有系统里最贵、最慢、最频繁的一类 LLM 判断任务,改成 3 个 JEV question:
- 一个 Noul 判断是否触发
- 一个 Choice 做路由
- 一个 Score 做风险或优先级
然后记录三件事:延迟、成本、人工复核通过率。
如果这三项都赢,JEV 就不是新玩具,而是可以进生产的“语义判断层”。
 第 3 篇
JEV 从0到1小白教程:跑通第一个决策
申请 Key、安装 SDK,完成一次 state+questions 调用并读出概率结果。
展开正文
第 3 篇
JEV 从0到1小白教程:跑通第一个决策
申请 Key、安装 SDK,完成一次 state+questions 调用并读出概率结果。
JEV 从0到1:跑通第一个决策
反常识点:JEV 不是让你“问 AI 一句话”。
它更像把一段业务状态丢进去,拿回一组可被代码直接消费的概率判断。
它更像把一段业务状态丢进去,拿回一组可被代码直接消费的概率判断。
如果你第一次接触 TypeSafe 的 System One 模型,先别急着做 Agent、路由、风控。今天只做一件事:申请 Key,安装 SDK,完成一次
state + questions 调用,并读出结果。1. 先搞清楚:你在调用什么
JEV 是 TypeSafe AI 在 2026 年 9 月 15 日开放早期访问的第一个 System One Model。官方博客在这里:
https://typesafe.ai/blog/introducing-system-one-models-and-jev
https://typesafe.ai/blog/introducing-system-one-models-and-jev
它和传统 LLM 最大的区别不是“更快的聊天模型”,而是:
输入:一段状态
输出:类型化决策
state输出:类型化决策
answers,附带概率 / 置信度也就是说,它不会生成一段解释文本,而是回答你预先定义好的问题。
目前核心问题类型主要有三种:
Noul:判断某个命题是否为真,返回 0~1 概率Choice:在多个选项中选择,返回各选项概率Score:对有序等级或连续区间打分
官方声称 JEV 在 System One 类任务上可达到 70ms-500ms 响应,输入价格为
https://www.langchain.com/blog/building-a-harness-with-jev
$0.042 / M token,输出免费;LangChain 博客也引用了最高 200x 速度、400x 成本优势的说法:https://www.langchain.com/blog/building-a-harness-with-jev
但注意:这些数字主要来自官方与合作方语境,尚未看到大规模第三方复现实验。工程上可以先把它当作“低延迟语义判断器”,不要当成魔法。
2. 申请 Key 与安装 SDK
先去 TypeSafe 控制台申请 / 管理 API Key:
https://console.typesafe.ai
https://console.typesafe.ai
文档入口:
https://docs.typesafe.ai
https://docs.typesafe.ai
官方 Python SDK:
https://github.com/typesafe-ai/typesafe-sdk-python
https://github.com/typesafe-ai/typesafe-sdk-python
官方 JS/TS SDK:
https://github.com/typesafe-ai/typesafe-sdk-js
https://github.com/typesafe-ai/typesafe-sdk-js
如果你用 Python,建议先建一个干净环境:
python -m venv .venv
source .venv/bin/activate

pip install typesafe-sdk
export TYPESAFE_API_KEY="sk-your-key"
如果你更喜欢
uv:uv add typesafe-sdk
export TYPESAFE_API_KEY="sk-your-key"
这里有一个容易踩坑的点:JEV 当前属于 early access。你即使安装了 SDK,也需要账号有访问权限,否则会在调用阶段拿到认证或权限错误。
模型路由一般使用:
jev-latest
API 端点是:
https://api.typesafe.ai/v1/systemone
下面我们优先用 SDK。SDK 出问题时,你也可以用原始 HTTP 调用排查。
3. 第一次调用:客服工单优先级判断
我们设计一个最小场景:用户说 Stripe 连接失败 3 天,正在丢单,希望尽快处理。
这不是让模型“写回复”。
我们只问三个问题:
我们只问三个问题:
- 是否紧急?
- 属于什么类别?
- 严重程度大概多少?
import os
from typesafe_sdk import TypeSafeClient, Noul, Choice, Score

# SDK 默认会读取 TYPESAFE_API_KEY
# export TYPESAFE_API_KEY="sk-your-key"
client = TypeSafeClient()

state = {
    "ticket": {
        "subject": "Stripe connection keeps failing",
        "message": (
            "Hi, I've been trying to connect my Stripe account for 3 days "
            "and it keeps failing. I'm losing sales. Please help ASAP."
        ),
        "customer_plan": "pro",
        "failed_attempts": 7,
    }
}

questions = {
    # Noul:判断一个命题是否成立,返回概率
    "is_urgent": Noul(
        instructions="The customer message conveys urgency or time-sensitivity."
    ),

    # Choice:只能从你给定的选项里选
    "category": Choice(
        instructions="Classify the main issue type.",
        options={
            "billing": "Payments, invoices, subscriptions, refunds, or charges.",
            "integration": "Third-party connection, API, webhook, or platform integration issues.",
            "account": "Login, permissions, profile, or account access issues.",
            "other": "Anything else.",
        },
    ),

    # Score:给出一个连续分数
    "severity": Score(
        instructions="Estimate business impact severity from 0 to 100.",
        min=0,
        max=100,
    ),
}

response = client.system_one(
    model="jev-latest",
    state=state,
    questions=questions,
)

print(response)
你拿到的结果结构可能随 SDK 版本略有变化,但核心信息会类似:
answers = response.answers

urgent_prob = answers["is_urgent"].noul
category = answers["category"].choice
severity = answers["severity"].score

print("urgent probability:", urgent_prob)
print("category:", category)
print("severity:", severity)
一个合理的输出可能是:
urgent probability: 0.99
category: integration
severity: 82.4
重点不在具体数字,而在它的形状:
你的程序不需要解析自然语言,不需要正则,不需要让 LLM “请只输出 JSON”。它本来就只能返回你定义好的类型。
你的程序不需要解析自然语言,不需要正则,不需要让 LLM “请只输出 JSON”。它本来就只能返回你定义好的类型。
这就是 JEV 最适合落地的地方:把“模糊语义判断”变成稳定的函数调用。
4. 用结果写业务逻辑,而不是读作文
拿到概率后,下一步不是把它展示给用户,而是接进业务代码。
例如:
urgent_prob = response.answers["is_urgent"].noul
category = response.answers["category"].choice
severity = response.answers["severity"].score

if urgent_prob > 0.85 and severity > 75:
    queue = "priority_support"
elif category == "billing":
    queue = "billing_team"
elif category == "integration":
    queue = "integration_team"
else:
    queue = "general_support"

print("route to:", queue)
这段代码才是 JEV 的正确打开方式。
LLM 常见模式是:
用户输入 → LLM 生成解释 → 解析文本 → 决定下一步
JEV 更像:
业务状态 → 概率判断 → 普通代码分支
这也是为什么 LangChain 把它放在 agent loop、model routing、Auto Mode guardrail 这类位置:它适合做“每一步都要判断,但不值得调用大模型长篇推理”的环节。LangChain 的 TypeSafe 集成可参考:
https://www.langchain.com/blog/building-a-harness-with-jev
https://www.langchain.com/blog/building-a-harness-with-jev
但也别误解它。
JEV 不能替你生成客服回复,不能写代码,不能做开放式规划。它更接近一个高性能、类型安全、带概率的语义分类器。和传统分类模型、reranker、规则引擎会有定位重叠。差异在于:它的输入可以是不那么规整的业务状态,问题可以临时组合,输出仍然保持类型约束。
我的建议是:别一上来重构系统。
下一步你可以只接一个真实小场景:
- 工单是否紧急
- 邮件是否需要人工处理
- RAG 答案是否被证据支持
- Agent 工具调用是否危险
- 用户请求该路由到 fast model 还是 powerful model
先记录 1000 次调用结果,对比人工标签和线上反馈,再决定是否扩大使用范围。
JEV 最有价值的地方,不是“替代 LLM”。
而是把过去散落在 prompt 里的判断,收回到可测试、可观测、可迭代的工程接口里。
而是把过去散落在 prompt 里的判断,收回到可测试、可观测、可迭代的工程接口里。
 第 4 篇
上手 JEV 后,先尝试这10个场景
盘点路由、审核、评分、抽取等最适合类型化决策的入口。
展开正文
第 4 篇
上手 JEV 后,先尝试这10个场景
盘点路由、审核、评分、抽取等最适合类型化决策的入口。
上手 JEV 后,先尝试这10个场景
很多人第一次看到 JEV,会下意识问:它能不能替代 GPT?
更好的问题是:你现在系统里有多少“用 LLM 做判断,但其实不需要生成文字”的地方?
JEV 是 TypeSafe AI 在 2026-09-15 早期访问发布的 System One 模型。它不是聊天模型,不负责写长文本,而是接收
state,回答一组类型化问题,返回概率、置信度和结构化结果。官方博客给的定位很清楚:unstructured state in,typed probabilistic decisions out。
官方链接:
https://typesafe.ai/blog/introducing-system-one-models-and-jev
文档入口:
https://docs.typesafe.ai
API Console:
https://console.typesafe.ai
官方链接:
https://typesafe.ai/blog/introducing-system-one-models-and-jev
文档入口:
https://docs.typesafe.ai
API Console:
https://console.typesafe.ai
官方声称 JEV 在 System One 类任务上可做到 70-500ms,输入 $0.042 / 百万 token,输出免费,并在部分工作流评测中达到约 193.6x 更快、444.6x 更便宜。但要注意:这些数字来自官方自测,尚未看到足够第三方复现。
下面这 10 个场景,是我建议你拿到 key 后优先试的入口。
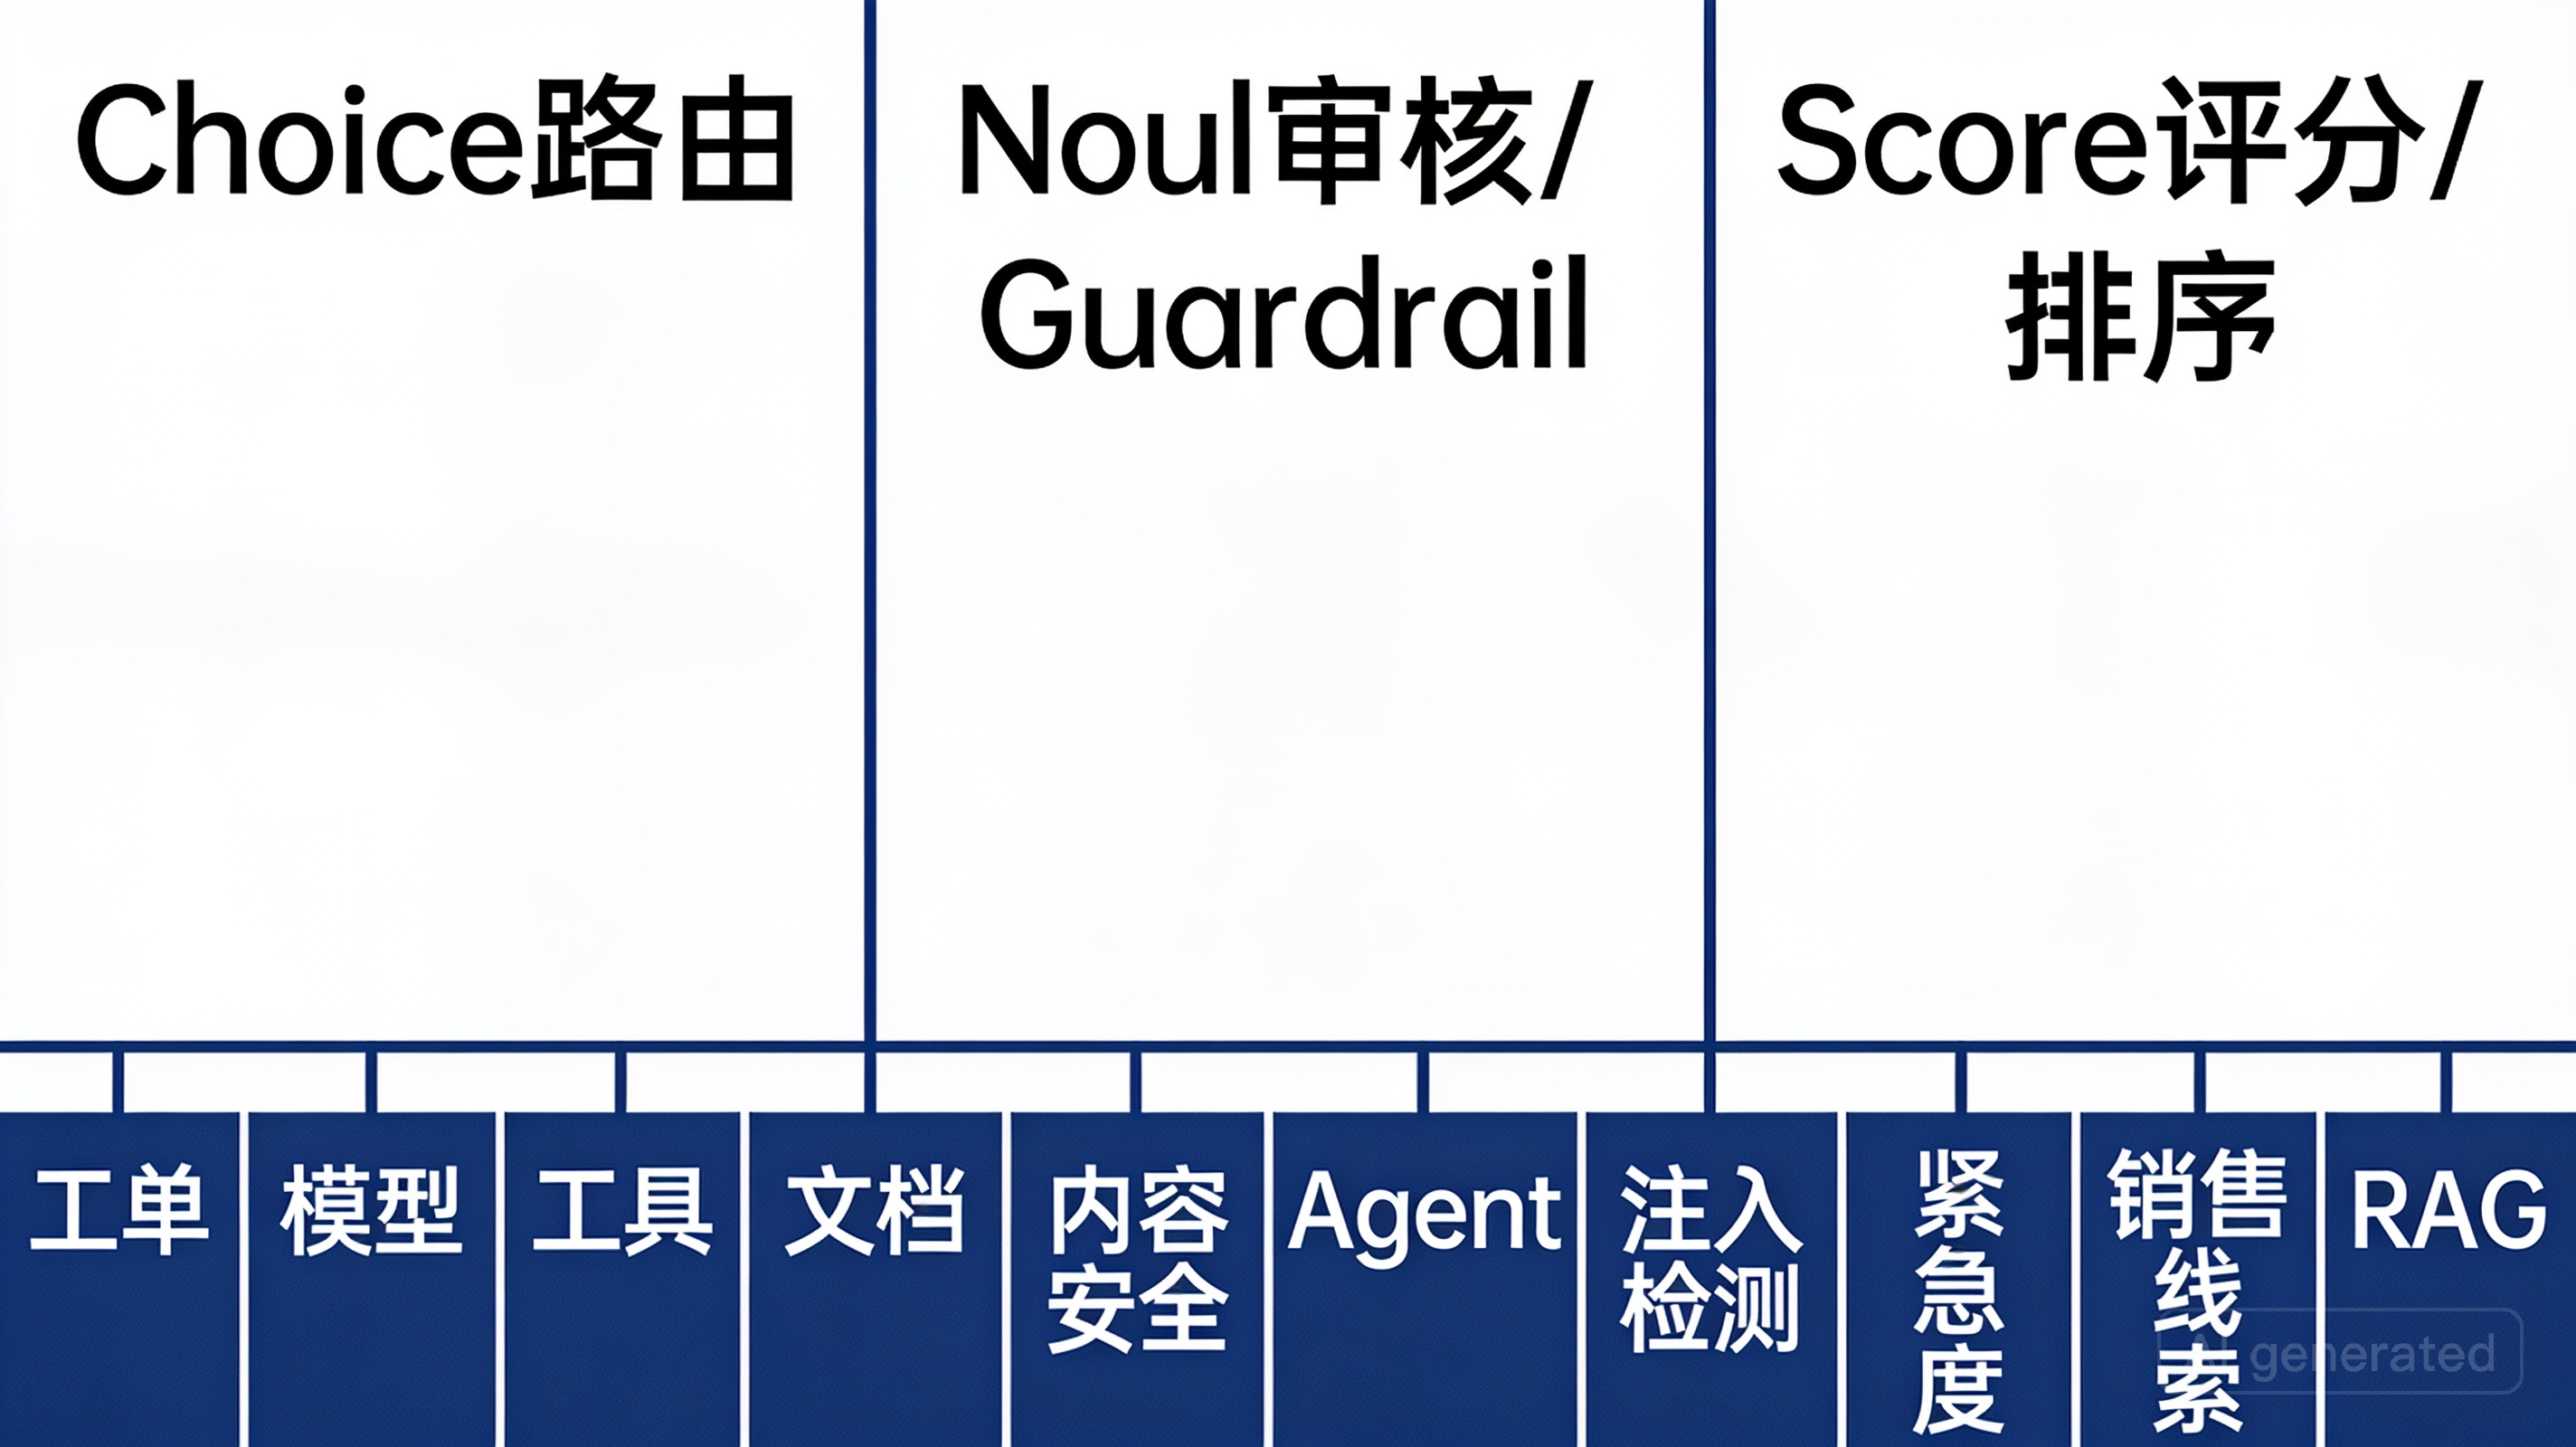
1. 最先试:路由、审核、优先级
JEV 最适合替代的,不是“写作”,而是“判断”。
第一类入口是路由:
- 客服工单路由:billing / technical / sales / spam
- Agent 模型路由:简单任务走便宜模型,复杂任务走强模型
- 工具调用路由:该查数据库、调 API,还是交给人工
- 文档处理路由:合同、发票、简历、投诉信分别进不同 pipeline
这类场景通常不需要一段漂亮回答,只需要一个可被程序消费的选择。这里用
Choice。第二类入口是审核:
- 内容安全审核:辱骂、诈骗、隐私泄露、越权请求
- Agent Guardrail:bash、支付、删库、发邮件前先判断风险
- Prompt 注入检测:用户输入是否在试图覆盖系统指令
这类场景更适合
Noul:一个命题是否成立,返回 0 到 1 的概率。第三类入口是优先级:
- 工单紧急度评分
- 销售线索质量评分
- RAG 检索结果相关性评分
这类场景适合
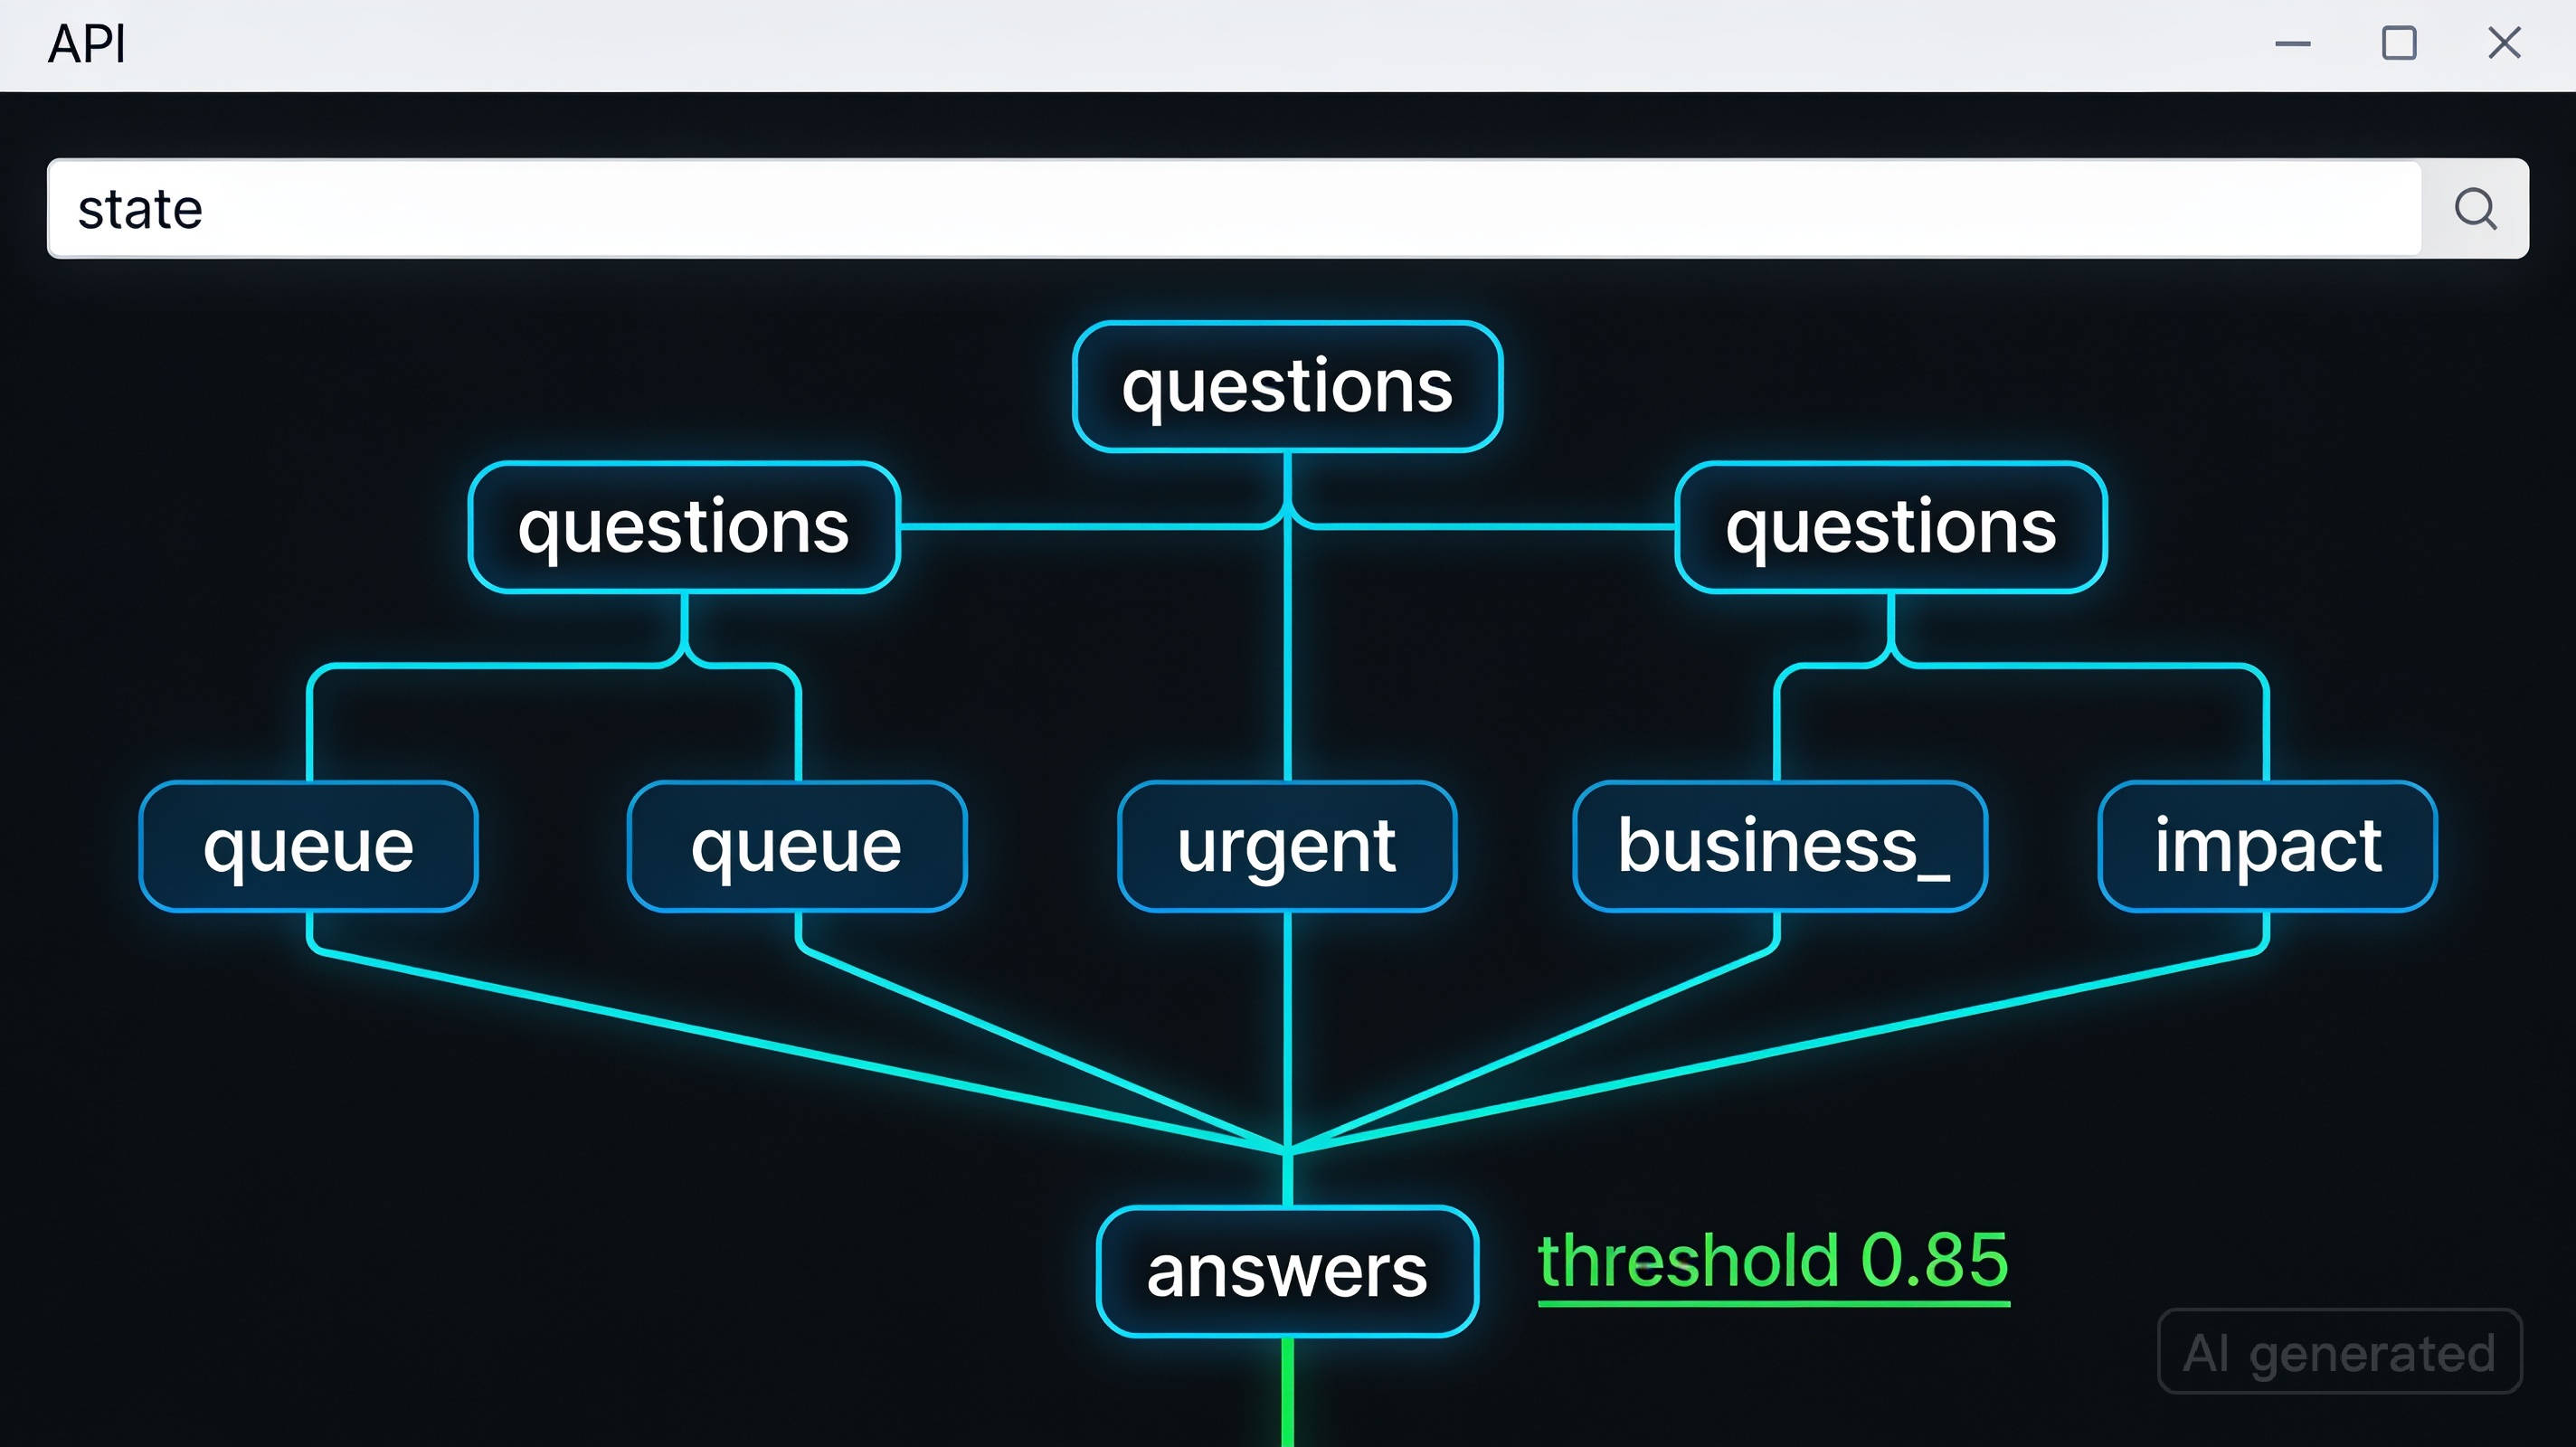
Score:不是简单 yes/no,而是连续或分档强度。2. 一个请求,问完 10 个问题
JEV 的一个关键工程优势是:同一个
这和用 LLM 连续问 10 次不一样。
state 下可以并行回答多个问题。这和用 LLM 连续问 10 次不一样。
下面用 TypeScript SDK 写一个“客服工单分流器”。官方 JS SDK 仓库:
https://github.com/typesafe-ai/typesafe-sdk-js
https://github.com/typesafe-ai/typesafe-sdk-js
安装:
npm install @typesafe-ai/sdk
export TYPESAFE_API_KEY="你的 TypeSafe API Key"
示例代码:
import { TypeSafeClient, choice, noul, score } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const state = {
channel: "email",
user_tier: "pro",
message:
"I connected Stripe yesterday but payouts keep failing. " +
"Customers are complaining and we may lose revenue today. " +
"Please fix this ASAP.",
};
const response = await client.systemOne({
// 早期访问默认可用模型路由;生产建议记录返回的具体 model 版本
model: "jev-latest",
state,
questions: {
// 1. 路由:选一个处理队列
queue: choice("Which team should handle this ticket?", {
billing: "Payment, refund, subscription, invoice, payout issues",
technical: "Bug, integration, API, infrastructure problems",
sales: "Pricing, demo, procurement, expansion",
spam: "Irrelevant, malicious, or promotional message",
}),
// 2. 是否紧急:命题概率
urgent: noul("The user needs immediate attention within the next hour"),
// 3. 是否可能流失
churn_risk: noul("The customer may churn if this issue is not resolved quickly"),
// 4. 业务影响评分
business_impact: score("How severe is the business impact?", {
low: "No meaningful impact on revenue or core workflow",
medium: "Some workflow disruption but workaround exists",
high: "Revenue, production, or important customer relationship is at risk",
}),
// 5. 是否需要人工升级
escalate_to_human: noul("This ticket should be escalated to a senior human operator"),
},
});
console.log(JSON.stringify(response.answers, null, 2));
// 典型用法:不要只看单个 label,要结合概率/置信度设阈值
const urgentProb = response.answers.urgent.noul;
const queue = response.answers.queue.choice;
if (queue === "billing" && urgentProb > 0.85) {
console.log("Route to billing priority queue");
}
这段代码的重点不是语法,而是思路:
把“一个 LLM prompt 里含糊地判断一堆事”,拆成多个可命名、可监控、可调阈值的问题。
把“一个 LLM prompt 里含糊地判断一堆事”,拆成多个可命名、可监控、可调阈值的问题。
3. 10 个场景怎么选原语
可以用这个简单规则:
Choice:当你要从有限选项里选一个。
适合:
- 模型路由:fast / balanced / powerful
- 队列路由:support / sales / abuse / legal
- 文档分类:invoice / contract / resume / complaint
- 意图识别:refund / cancellation / upgrade / bug report
Noul:当你要判断一个命题是否成立。
适合:
- 是否紧急
- 是否越权
- 是否包含 PII
- 是否可能是 prompt injection
- 是否允许 agent 自动执行工具
Score:当你要排序、分层、打分。
适合:
- lead quality
- 工单严重度
- RAG chunk 相关性
- 答案可信度
- 用户情绪强度
LangChain 也已经写了 JEV 集成思路,重点放在 agent loop、模型路由和 Auto Mode Guardrail:
https://www.langchain.com/blog/building-a-harness-with-jev
相关包可关注:
https://github.com/langchain-ai/langchain
https://www.langchain.com/blog/building-a-harness-with-jev
相关包可关注:
https://github.com/langchain-ai/langchain
但别把 JEV 神化。它和传统分类器、reranker、moderation model 有重叠。区别在于:JEV 把这些判断统一成三种类型化问题,并且每个答案带概率,比较适合塞进业务工作流里。
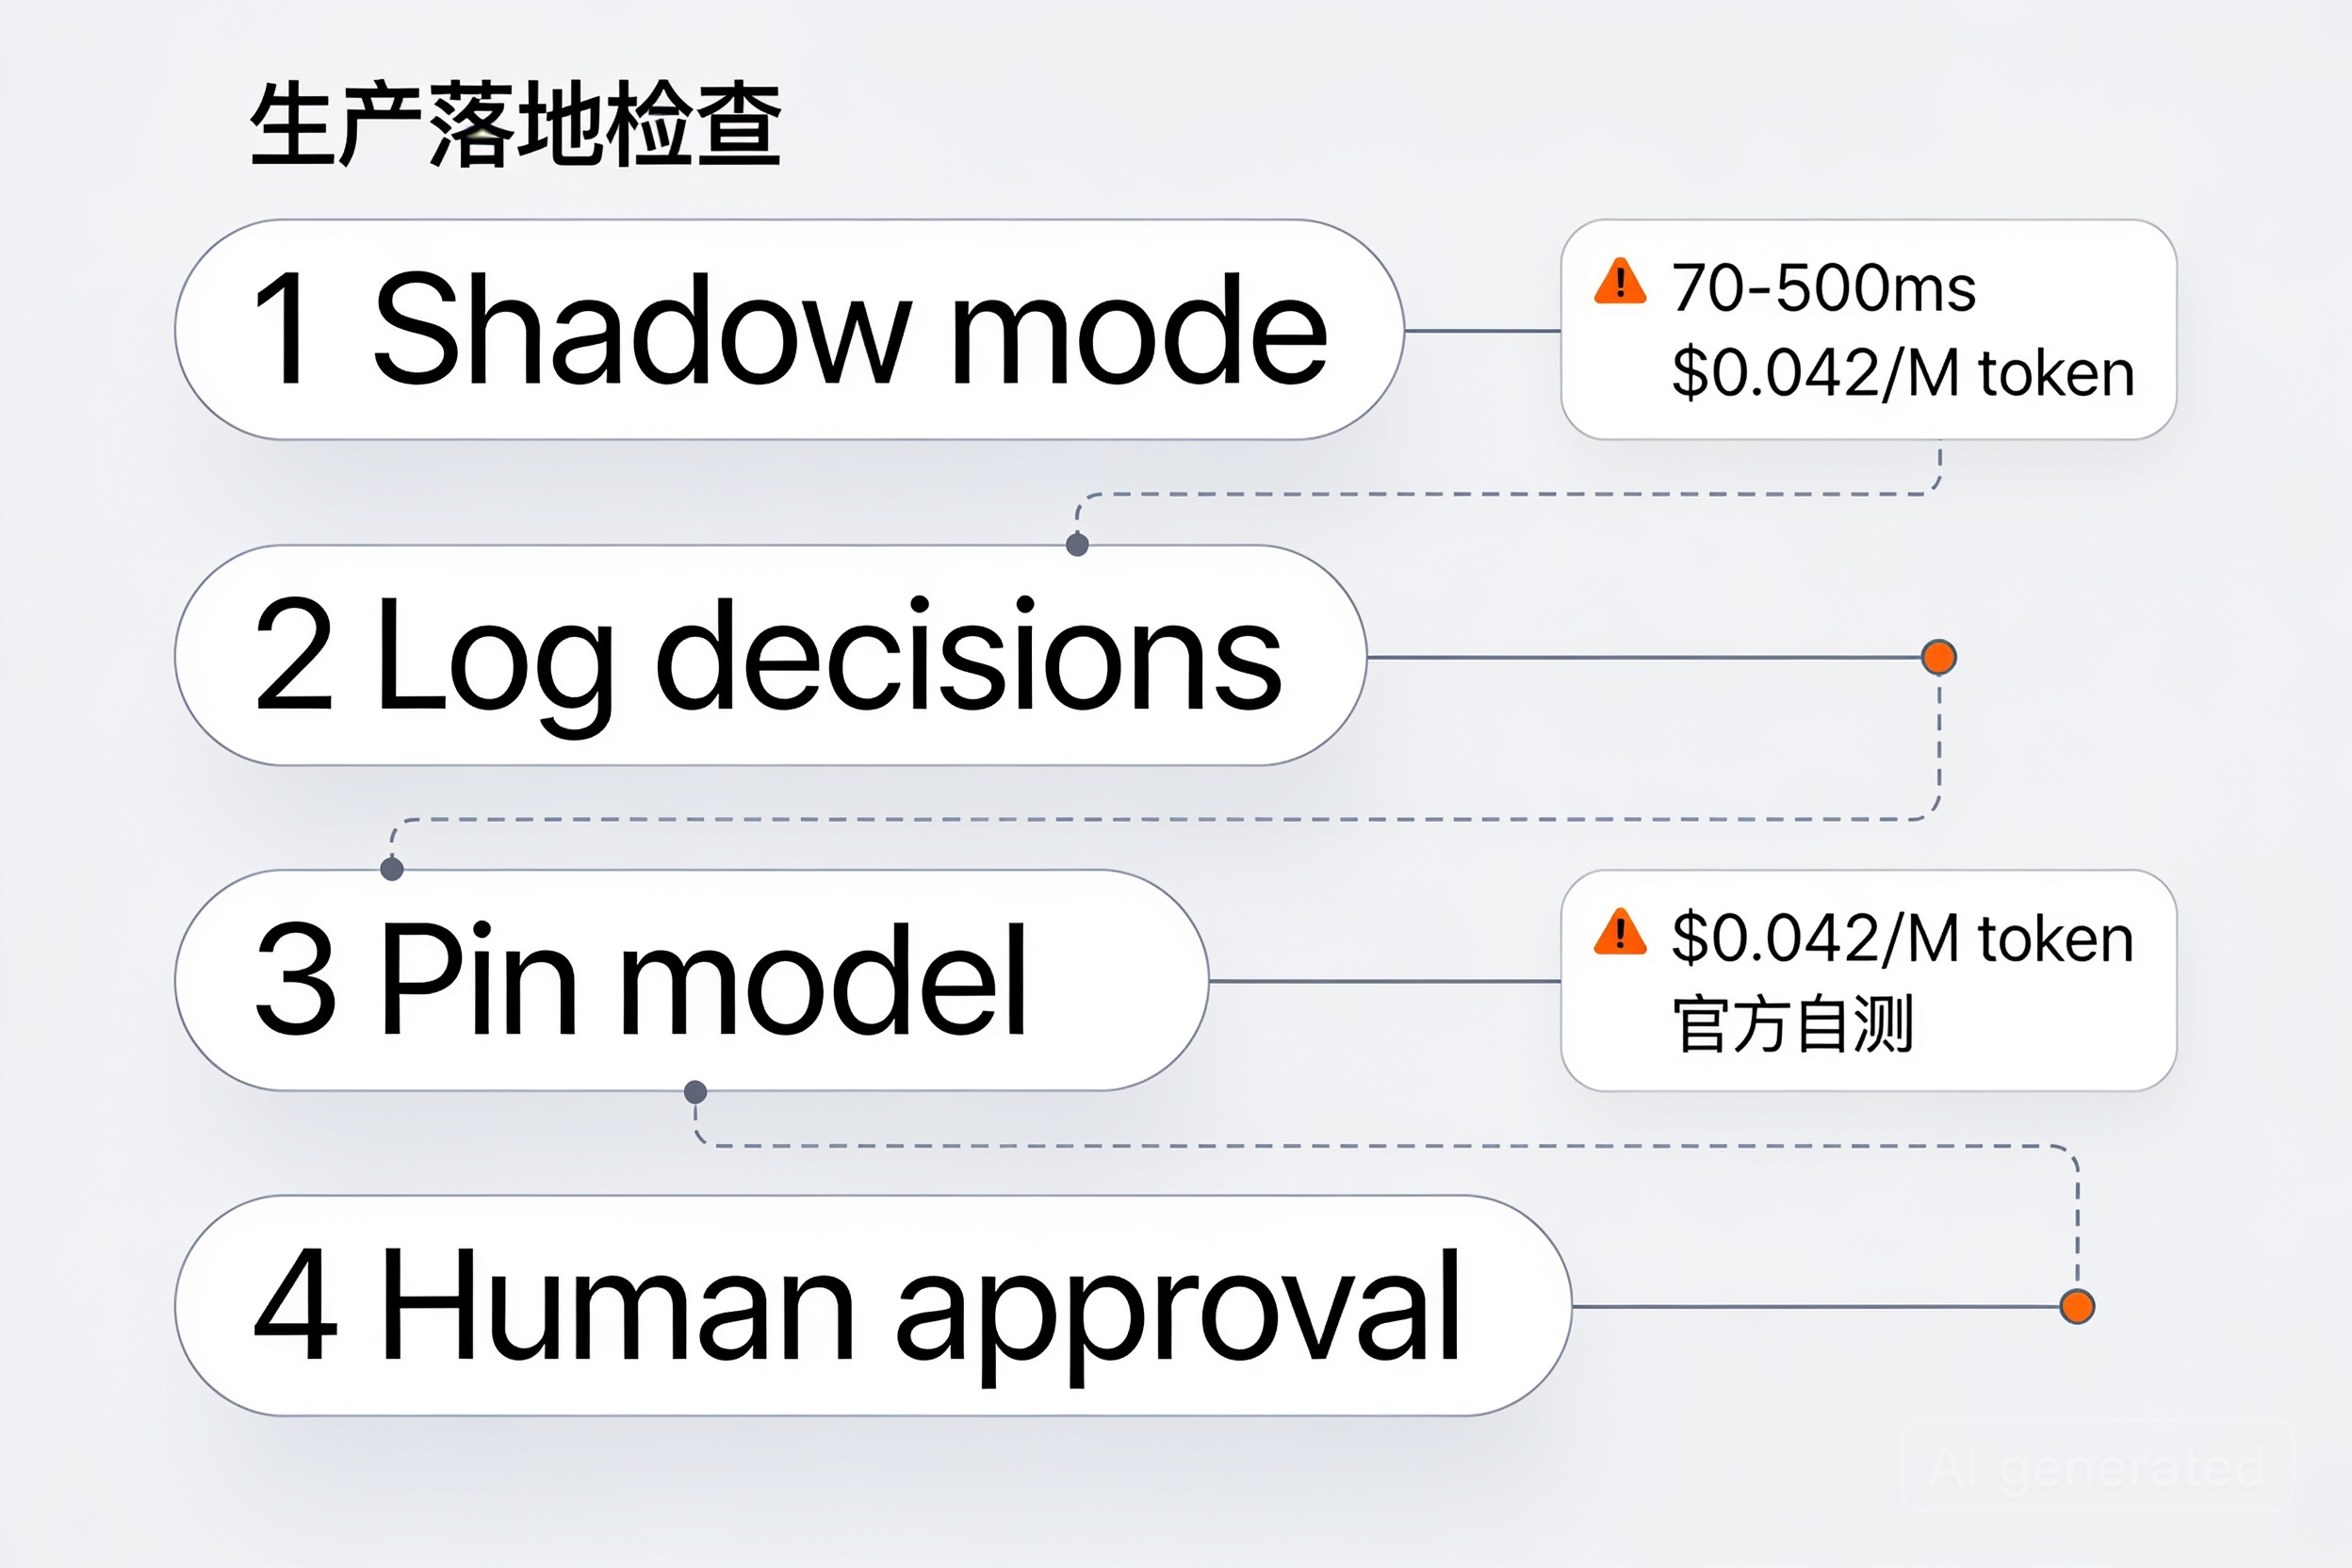
4. 生产落地时,先做这 4 件事
第一,别一上来替换核心链路。
先从旁路 shadow mode 开始:让 JEV 和你现有规则/LLM 分类器同时跑,记录差异。
先从旁路 shadow mode 开始:让 JEV 和你现有规则/LLM 分类器同时跑,记录差异。
第二,所有决策都要记录:
{
"state_id": "ticket_123",
"model": "jev-latest",
"question": "urgent",
"answer": 0.93,
"threshold": 0.85,
"final_action": "priority_queue"
}
第三,不要迷信
早期访问阶段模型会升级,答案分布可能变化。只要你调过阈值,就应该记录 response 里的具体模型版本;关键业务最好 pin 版本。
jev-latest。早期访问阶段模型会升级,答案分布可能变化。只要你调过阈值,就应该记录 response 里的具体模型版本;关键业务最好 pin 版本。
第四,把“自动执行”和“建议执行”分开。
比如
比如
delete_database、send_wire_transfer、email_all_customers 这种动作,即使 JEV 判断低风险,也不应该直接放行。JEV 是决策函数,不是责任主体。我的建议:第一次上手,不要做炫技 demo。
就拿你系统里最烦的 1000 条真实工单、1000 条用户输入、1000 个 RAG 查询去跑。
就拿你系统里最烦的 1000 条真实工单、1000 条用户输入、1000 个 RAG 查询去跑。
如果 JEV 能在这些地方稳定给出可解释、可调阈值的概率结果,它就有价值;如果只能在 demo 里好看,那就先留在实验层。
下一步动手建议:选一个“现在用 LLM 判断、但不需要生成文本”的节点,用
Choice + Noul + Score 重写成一个 JEV 请求,再做一周旁路对比。如果这篇对你有帮助,欢迎点赞、转发、收藏,也可以留言说说你最想用 JEV 改造哪个场景;记得关注,别错过本系列下一篇。
 第 5 篇
JEV 生产落地清单:阈值、日志与回放评测
讲清上线前要做的阈值校准、结果记录、失败样本回放。
展开正文
第 5 篇
JEV 生产落地清单:阈值、日志与回放评测
讲清上线前要做的阈值校准、结果记录、失败样本回放。
JEV 上线前必做清单:阈值、日志与回放
把 Jev 接进代码只要 10 分钟,让它安全地自动化你的生产流量却是另一回事。Jev 是 TypeSafe AI 的「System One」决策模型(2026 年 9 月 15 日早期访问上线,9 月 20 日起放开注册):不吃文本,只吃 state + questions,返回带校准概率的类型化答案。官方声称 RLCD 训练让「置信度越高越准」,但这句话只在聚合意义上成立——换到你自己的数据分布上,不校准就直接上线,等你的就是悄悄跑偏的路由。
一、阈值校准:置信度是边际,不是正确率
每个 Choice/Score 答案都带一个
confidence。TypeSafe 文档里的公式是 (n × p_max − 1) / (n − 1):把最大概率按选项数重新缩放,均匀分布记 0,笃定记 1。它度量的是「这坨分布有多集中」,不是「这个答案有多对」。Pydantic 的说法更直白:这是 margin(边际),不是概率。Noul 没有独立 confidence 字段,noul 本身就是 0~1 的信念,代码里直接阈值化。网上流传的三档默认值(>0.9 自动执行 / 0.5~0.9 先问一句或交给更强模型 / <0.5 交人)只能当起点。真正的规则是:阈值按动作代价分层。读操作 0.5 就够,动钱要 0.9,不可逆操作还要叠加人工二次确认。TypeSafe 官方文档也承认:thresholds 是 use-case-specific,必须在你的数据上测。
# pip install typesafe-sdk
# export TYPESAFE_API_KEY="sk-..."
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()

def route(ticket: dict) -> str:
    r = client.system_one(
        state=ticket,
        questions={
            "intent": Choice(
                instructions="Which team should own this ticket",
                criteria={"billing": "Payment/subscription",
                          "technical": "Bugs/integration",
                          "refund": "Explicit refund request",
                          "other": "Anything else"},
            ),
            "urgent": Noul(
                instructions="A human must act on this immediately",
            ),
        },
    )
    intent, urgent = r.answers["intent"], r.answers["urgent"]
    # 低置信或高价值 → 交人;高置信 → 自动;中间带 → 先确认
    if urgent.noul > 0.9 or intent.confidence < 0.5:
        return "human"
    if intent.confidence > 0.85:
        return intent.choice
    return "confirm"
一个反例来自社区实测:把
rm -rf 分类为「不可逆」时概率只有 0.56、置信度 0.33——正是那个 0.33 提醒外层代码去问人,而不是信标签。二、日志:记全概率分布,而不只是赢家
日志别只记
choice 和 confidence。要落盘的字段:state 的 hash、原始 questions、完整概率分布(不是 top-1)、confidence、端到端延迟、后续动作、最终结果。state hash 是回放的钥匙——没有它,失败样本无法复现。Langfuse 已出 TypeSafe Jev 的 observability 与评测集成,可以直接接 trace。为什么记分布?分布太平(第二名逼近第一名)通常是 criteria 设计错了,而不是模型糊涂。一个概率是过滤器,不是证据——TypeSafe 自己在文档里强调:0.83 是路由信号,不是「这个人确实如何」的结论。日志里把 state、问题、概率、动作、结果五元组留齐,才能在回放阶段问出「高置信但错了」这个最危险的问题。
三、回放评测:先 shadow,再 flip
上线顺序只有一条:shadow mode → 黄金样本 → 灰度 → 全量。shadow 阶段只记录不动作,拿日志核对「Jev 会怎么路由 vs 实际应该怎么路由」,跑通一两周再 flip 成 active。评测用双层:Jev 自己当裁判打分 + 人工抽检,社区已有人用 Jev 给 6003 条 rubric 打分,与 Claude Fable 5.1 一致率 91.5%(花费 $160 对 $33,000,数据来自 Langfuse 整理的早期测试,非官方复现)。
回放清单三件事:① 低置信但最终对了——说明阈值太严,浪费人力;② 高置信但错了——最危险,说明分布外输入骗过了校准,只调阈值没用,要改 state 或 criteria;③ 拒绝不了的硬分——Jev 不能 abstain,二选一会硬挑「最不坏」的答案,所以每个 Choice 都要留
unknown/needs_review 逃生口。另记住它的已知短板:只读字面、不会算术、把日期当文本、state 塞太多无关内容会 context rot(文档明说 accuracy 会随无关材料下降)。一句话总结:Jev 把「判断」做成了便宜快速的函数,但把「判断有多可信」的责任完整交给了你。官方的速度与成本数字(70–500ms、$0.042/M 输入 token、输出免费、193.6x 快)仍是自测、未经第三方在你的工作负载上复现,请把它当起点而非结论。
下一步动手建议:挑一个你代码里现有的硬编码 if-else 或慢 LLM 判断,跑一版 shadow mode,日志里对比两周,再按本清单回放失败样本。相关一手资料:官方博客 typesafe.ai/blog、文档 docs.typesafe.ai、SDK 仓库 github.com/typesafe-ai、LangChain 集成说明 langchain.com/blog/building-a-harness-with-jev。
觉得这份清单有用的话,点个赞、转给要接 Jev 的同事,收藏起来上线前对一遍;有踩坑经验欢迎留言交流。关注本专栏,下一篇讲 Jev 在 Agent 护栏里的落地姿势。