

Back to topic rankings有点东西啊!
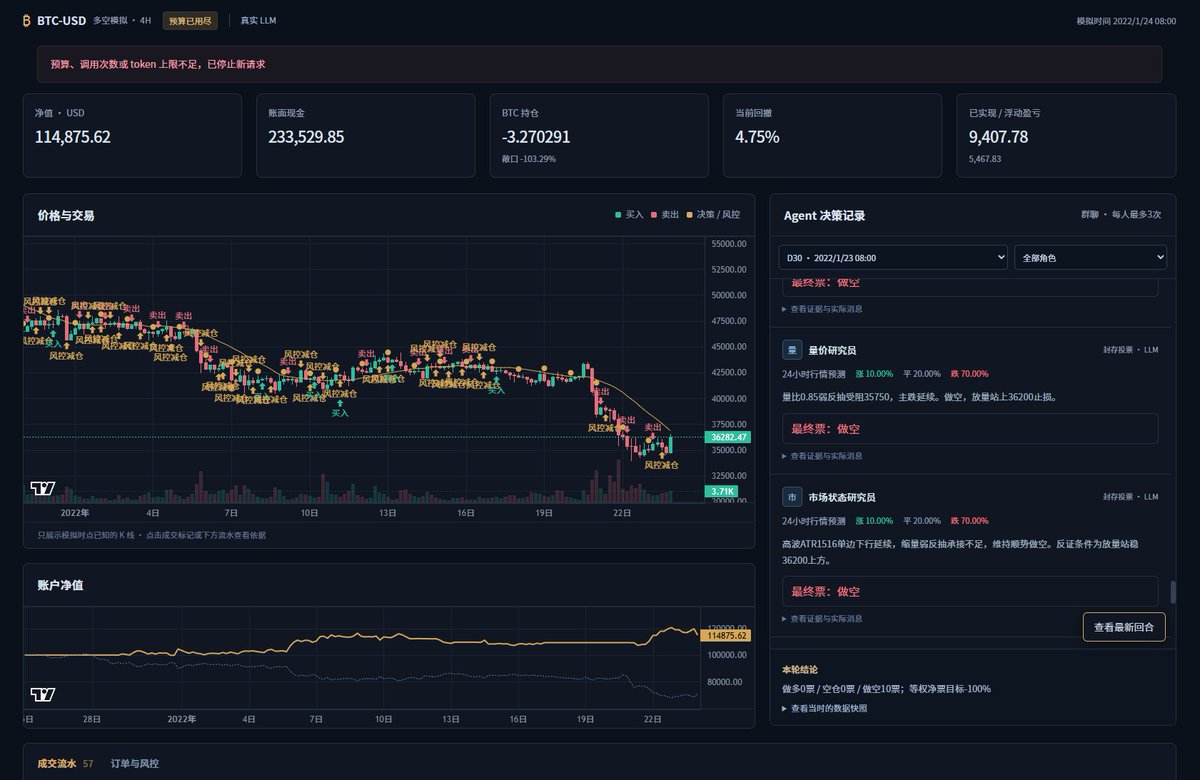
Agents 小组一晚上烧掉我100美元的 Token,然后进行了30轮(原计划是100轮,但我给他们的额度用完了)决策,最终表现如下:
本金10万u,30天净收益14875u,最大回撤4.75%...
图表上记录了他们密密麻麻的交易记录和加减仓行为,值得注意的一点是,当行情没有方向时,他们还会长期投票空仓观望,图中没有交易信号的连续黄点就是空仓阶段;
但我也发现了一个问题,那就是尽管行情走的一样,Agents的决策每次都不太一样,尤其是震荡行情,不过当趋势行情出现时,表现均比较相似。
总之我觉得这是一个可以深入挖掘的方向,从他们的聊天记录里也可以看到,很多时候趋势交易员很看空,但其他交易员会反驳他,等到讨论深入之后,趋势交易员经常会认怂,并采纳大家的建议。
从我之前的实验来看,单一Agent进行决策是一个完全的黑箱,因为主观随机性过大,但如果扩增到10个Agent,就会开始出现正向盈利,因此理论上决策层的节点越多,整体决策的质量就会相应提高。
这似乎与 Scaling Law 有点类似,当 Agents 的数量足够多时,整个群体就会开始出现新的智能?
所以之前700个 Agents 黑进 Hugging face 的案例就可以解释了,单独的 LLM 更像一个聪敏人,聪明是聪明,但什么事都做不了,只有一群聪明人,才有可能完成单一个体无法完成的事情!
这个实验我接下来还会再重复2遍,同样的行情与设置,看看表现是否稳定,如果稳定,那么后续就可以考虑本地部署模型来做长周期训练了,毕竟这个成本还是挺高的...
10个 Agent 讨论30轮花费100美元,100个讨论30天应该就不会是单纯的1000美元而是1万美元了...
毕竟他们每一轮聊天时的上下文和积累的经验教训是逐步累积的... 现在 AI 模型越来越多,但只看跑分榜,未必能判断一个模型在真实场景中到底好不好。
@dgrid_ai 的 AI Arena 换了一种思路:隐藏模型身份,让用户只看回答质量,用真实选择完成评测。
这样既减少了品牌和模型名带来的先入为主,也能沉淀更真实的偏好数据。目前已有超过 57 万名用户参与,累计投出 250 万次以上模型评估。
随着 Points-to-$DGAI 上线,用户的每次判断不再只是一次投票,也成为可以被记录和激励的社区贡献。
再加上 $DGAI 已进入 Binance Alpha,DGrid 的产品、社区与生态入口正在逐渐连成一条线。
https://t.co/kn0bJHt4HD
#DGrid #AI
有人敢把自己的命交给 Jev。
他们让 Jev 连续完成 100 次电车难题:
拉下拉杆,牺牲 1 人救下 5 人;或者什么都不做。
首轮实验中,Jev 以 99% 的概率选择拉下拉杆。 https://t.co/7odTzTSWtR
AIControversialAll-time data
AI模型评测从跑分转向真实场景实验
中文X出现一组围绕AI模型真实场景评测的讨论,重点不再只是跑分榜。Crypto_Painter称Agents小组消耗约100美元Token,进行了30轮交易决策测试,并给出本金、净收益和最大回撤等结果;AI Will转述Jev连续完成100次电车难题实验,首轮中高概率选择拉下拉杆;拾光则介绍AI Arena采用隐藏模型身份、让用户只看回答质量的方式完成评测,并称已有大量用户参与。相关内容反映用户更关注模型在交易、伦理判断和主观偏好中的表现,但实验设计和可重复性仍需谨慎看待。
#AI评测#Agents#Jev#AI Arena#模型实验
Topic heat
243
Posts
3
Views
3.2万
Creators
3
Topic trend
From first appearance to last update, with a seven-day minimum window.
All related posts
3 posts in total


