Back to topic rankings找一张你喜欢的美女图片,再加上这张图,发给GPT,它会帮你实现你的各种幻想! https://t.co/SfVC62NX82 过去一周多,可能以后被证明是AI推理部署史上天翻地覆的一周。
上个周末,我的本地机双5070ti试跑Qwen Flash,只能做到200 prefill,10decode。
今天,在Strata和我自制的PR的支持下,目前可以跑到2200/67,而且只需要一张卡。
即读写速度都提高了近十倍。
更好的消费卡比如4090/5090,当然也有幅度相当大的升级(目前5090在流式处理的支持下,速度已经开始逼近RTX6000,当然显存还是不足)。
这当然带来了消费级硬件的新一轮大涨价。如今,就连曾经无人问津的 32G B70英特尔显卡都卖断货涨价了。
2200/67的速度是什么意思?
今天除了deepseek,muse等少数模型,大部分API达不到这个速度。
而一个普通的家用游戏电脑就可以达到这个水平。
而这个水平,一周以前,只有5090,DGX spark,M3U这样的机器可以达到。
也就是说,在过去的一周多,全球的普通家用电脑带来了十倍于上周的AI产量。
这个增量,得益于deepseek- Qwen flash这种特殊设计,把智力分成了注意力,专家,和查表,
也得益于Strata这样优秀的架构,把整个处理流水线化,让不同的智力,存储在不同速度的存储设备中,在需要用时刚好抵达。
这对所有愿意拥有本地智力的人,当然是极大的利好。
也许模型层的设计,正在快速收敛到一个目前硬件条件下的最优解?
然而这对依赖出卖模型算力的生意,尤其是平庸的智力的商业来说,也可能是催命符。 这才是人类花几千万训个模型让AI去Coding的意义啊,而不是做一堆Slop泔水然后到处发社交媒体😅 https://t.co/HqmUBtPPKw
Opus 5.5 是真香,Claude 号是真难养啊!兄弟们!!!
国庆第一天,我时间线上刷到的全是 Claude 封号:用了两年的老号说没就没,最高档订阅说封就封,连写防封教程的博主自己都中招了😂
偏偏这周 Codex 200 刀套餐同价降配,一堆人正准备转 Claude。
我前几天用云电脑注册的一个号,22 分钟就没了。
折腾了这么久,网上那些防封玄学我全扔了,只留真管用的 4 条claude防封指南:
一、真正管用的 4 条
1、固定,比"纯净"重要
设备和出口 IP 固定,比花钱买家宽有用。一个 VPN 里天天切节点,IP 照样在变。
2、一个号一个环境
被封过的浏览器别再登新号。顺手去 Settings → Account 看一眼 Active sessions,陌生登录先踢掉。
3、别上来就开 Max
新号 + 新卡 + 直接 20x,是风控眼里最显眼的样本。Free 用一阵,再 Pro,不够了再升 Max。
4、用量别天天顶格
新号开了 200 刀当天就用满,最容易出事。每周留点余量。
彩蛋:一个最玄的说法,信不信由你
Claude 会给账号算"价值":天天写代码、写文案的号最容易被封,常问前沿研究、数学、论文的号很少出事。
照这个说法,新号第一件事该是拿公开行业报告去问它,把自己养成"研究员号"。没法验证,但你的对话越有训练价值,它越舍不得封你,好像也说得通。
二、这 3 笔钱可以省
· 家宽 IP:大厂程序员走公司机房 IP 照样天天用。关键是稳定,不是标签。
· 时区、中文输入法:别折腾,影响没传得那么大。
· 老谷歌号:没依据,谷歌不会把账号年龄告诉 Anthropic。
付款也别乱选:官网刷卡被封不退款,App Store 至少能找苹果兜底。细节在付款篇。
三、你是不是非得自己养号?
· 每天重度写代码、能把 Max 用满的:老老实实养官方号,订阅给的额度按量买不到。
· 偶尔用 Opus 5.5 干难活、怕封、团队要一起用的:走按量就行。
按量这块,我现在放在 Agent Space:
Opus 5.5 是官方 API 价的一半(每百万 token $2/$10,官方 $4/$20),云端选 Claude Code 就能跑,不用注册 Claude 号。
注册就送 $1 体验额度,不用先充钱,拿 Opus 5.5 跑个小任务试试手感再说。
Codex 也在这,独立账号月付是官网的 5 折,年付 4.5 折。今天丢了一句话给它,几分钟做出配图里这个账单计算器。
最让我惦记的是:官网 Claude Code 订阅拼团那栏,已经挂上"即将上线"。
Codex 能打到 4.5 折,Claude 要是也照这个路子来……
Max 不用养号、不怕封、价格还砍一半多,那上面的防封攻略我可能白写了😂
上线那天我第一时间去测,想蹲的先关注。
Claude 系列前两篇:
网络篇:https://t.co/t6UUZKlCTV
付款篇:https://t.co/XnWaRsPB2F
Agent Space 首购链接(多送 10% 额度):
https://t.co/YBFJNC2cTY 我记得半年前我说自己不怎么 Review PR 了,评论区很多人不认同,觉得这样不靠谱。现在再看,不 Review PR 的人越来越多。比如我刚看的这期播客,在 SpaceXAI 做 Grok Bot 的 Lauren Tan,一个月合并 2500 个 PR,也是不逐个 Review 的:晚上让 AI 自己检查、自己合并,第二天早上她再抽查。
不 Review 不等于不管质量,她靠另外两个办法来保证:
一是让 AI 能像真人用户一样把程序用一遍,自己发现问题;
二是给代码定下很多规矩,让 AI 很难写出烂代码。
她把自己这套做法写成了一组 Skill,公开了出来,叫 pstack。
顺便说一下,这期播客的主持人 Matt Pocock 原本是知名的编程课讲师,他公开的技能库在代码托管网站 GitHub 上有二十多万个星标,是最受欢迎的技能库之一,所以这期算是两位同行对谈。Lauren 之前在 Meta 做网页开发框架 React,今年 3 月加入 AI 编程工具公司 Cursor;Cursor 今年 8 月被 SpaceX 收购,并入旗下的 AI 部门 SpaceXAI。
根据播客的内容,我把 Lauren 的这套做法简单总结一下,我自己的点评在结尾处。
一、先让 AI 能检查自己干的活
Lauren 说,就算不用她的 pstack,每个人最该有的一项技能也是“验证”:给 AI “手和眼睛”,让它能把自己写的程序跑起来,像普通用户一样点一遍,看看结果对不对。
这是她吃过亏之后得出的结论。今年 4 月她在 Cursor 解决一个窗口卡顿的问题,一开始全靠手工:她自己去看各种性能数据,再把看到的转述给 AI,AI 改完她再去看。她形容自己成了 AI 和检测工具之间的“人肉中转站”。她在 Cursor 写的第一个技能就是验证。在这之前,AI 看不到自己改动的效果,只能等她来回传话;有了验证,AI 可以自己改、自己看结果、不满意再改,一轮一轮往下做,不需要她守着。现在她所在的团队里每个产品都配有这样的验证技能,全团队都在用。
做这个技能时她还总结出一条原则:工作里有的部分需要动脑判断,有的部分只是照章办事,照章办事的部分应该写成固定的程序,只把需要判断的留给 AI。起因是她发现,每个 AI 在检查前都要自己从头写一遍检查用的小程序,各写各的,有的能用有的不能用,用完就扔,又慢又浪费。她把这部分做成一个现成的工具,所有 AI 直接调用。
二、AI 反复犯的错,去改规矩,不去改 AI
Lauren 不喜欢“软件工厂”这个流行说法,她更愿意把自己的工作比作经营一家米其林餐厅的后厨。主厨不用亲手做每道菜,但要安排好整个厨房:食材什么时候进、怎么存,每个人用什么工具,菜按什么流程出。工程师现在也一样,不再亲手写代码,却仍然要对结果负责。她认为工程师现在最重要的工作就是把这个“厨房”布置好。没花时间布置的人,信不过 AI 的产出,只能盯着它一步步干,忙到没空改进工具,就像一直拿钝刀切菜。
她举了自己的例子。Grok Bot 最早几版的代码挤在八个巨大的文件里,每个至少一万行,AI 加新功能时就接着往里塞,越塞越乱。她后来定了规矩:每个功能必须放在自己单独的文件夹里,做一件事只允许一种写法,不合规矩的代码会被自动检查拦下来。这样 AI 加功能时不用多想,按规矩放就行。她的习惯是一直观察 AI 在哪里出错,每看到一次就问自己:能不能加一条规矩,让这种错以后根本写不出来。
不逐个检查,靠的也是这套办法。她说,开了几家餐厅的老板不可能尝每一道菜,只能抽查。她每天挑一些改动仔细看,如果只是偶然出错就算了;如果好几个 AI 都在走同一条捷径,说明该改的是规矩和工具。她的 pstack 里有一个全自动模式:每次改动都会派出一批专门负责检查的 AI,把程序打开到处点,找出问题就自己修,反复到没问题再合并。早上她翻一遍改动记录,发现不对就撤回,再补一条新规矩。
她说第一次让 AI 整夜自己合并代码时很害怕,担心半夜把线上产品弄坏,现在反而睡得更好。她也提醒,走到这一步很难,要花大量时间观察和调整,装上 pstack 并不能直接做到。Matt 问,如果改动是没法撤回的,比如会丢数据,或者是医疗、金融这类领域怎么办?她说这取决于工作成果能不能被程序自动检查,软件大部分可以,很难自动检查的领域就很难这样做,她自己也没有答案。
三、2500 次改动从哪来:她不再当传话的人
这 2500 次改动并不是她发起了 2500 次对话。用户反馈的问题散落在聊天工具、邮件和���交媒体上,以前要靠她自己去看,再转述给 AI。现在她让 Grok Bot 来盯这些渠道。Grok Bot 是 SpaceXAI 今年 8 月推出的产品,是能登录邮箱、聊天工具等各种应用、替人办事的 AI 智能体。它一发现新的问题反馈,就转给一个负责“协调”的 AI。这个协调者自己不写代码,只负责拆分任务、分派给其他 AI、盯进度,相当于她的后厨主管。
为什么不直接一个问题派一个 AI 去修?她说,一批反馈往往出自同一个根源,分开修会重复劳动,也看不出真正的毛病在哪,放在一起看才看得出来。她现在同时开着十多个这样的协调者,各管一摊。她一直在问自己一个问题:哪一步还卡在我身上,AI 为什么非得来问我?然后想办法教 AI 自己去拿到真实的信息。
她也说明,2500 次改动里新功能不占多数,很多是整理代码这类维护工作。
四、懂行的人更吃香,哪怕不会写代码
Matt 问,大家都靠 AI 了,专业知识是不是不值钱了?Lauren 的看法相反。模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。所以她认为,医生、律师这类在某个领域懂得很深的人,只要稍微懂一点技术、会用 AI 智能体,就能做出很好的产品。
两人都认为,技能没有什么神秘的,就是把自己的做事流程写成文字。Lauren 建议回头翻自己和 AI 的聊天记录,找出那些自己反复纠正、反复插手的地方,把它们写成技能或规矩。别人的技能可以拿来拼着用,但每个人最后都该有一套自己的,就像厨师换了餐厅也会带着自己的刀。
五、最后
很多人看完这期访谈会觉得,以后自己也可以像 Lauren 那样不 Review PR 了,装上她的 Skill,让模型帮忙验证一下就行。我自己现在的做法和她差不多,每天也有大量 PR,也不 Review。但我的建议是先别急着学她怎么做,先弄明白她凭什么能这么做。
1. 你能不能用上最好的模型,Token 够不够
在用上 Fable 和 Opus 5.5 之前,AI 写的代码我是不太放心的;用上之后,我才真的敢让 AI 去写而不怎么 Review。模型能力很重要,能力没到,就先别想这件事。
还有成本。像我这样没有大公司可以依靠的,得自己掏钱买 2 个 Claude Max 20x 账号,还得省着用。Lauren 在大公司,不用考虑 Token 消耗,全程用最好的模型、开最快的模式都没问题。
不过也别着急。Fable 这个级别的模型,也许半年以后就能像现在的 DeepSeek V4.1 Flash 一样便宜,人人用得起。梁圣加油。
2. 不能��全依赖 AI 的验证
哪怕现在 GPT-6 操作电脑的水平已经超过真人了,让它去做验证,也只能替代一部分,不能真的全交给它,自己还是要看。
可以做的是把那些手动重复做的事情,一点点沉淀成 Skill 和自动化脚本,把体力活解放出去���
3. 方向得靠你自己的专业来指
再聪明的 AI,也没办法替你决定该往哪个方向走。就像给车子装上火箭发动机,也得你来告诉它往哪开,走偏了要及时调整,不然跑得再快也是南辕北辙。
做软件也一样。你不能指望一句提示词做出一个淘宝。你得先做一个能发商品、能浏览的小网站,再加上用户注册,还得区分买家和卖家,然后是支付和安全,功能做完了还要扛得住很多人同时用。稍微复杂一点的软件,都没法完全依赖 AI,要人去拆解、规划,分成一个个小版本、小里程碑,做完要验证,出现偏差要重新指方向。甚至做着做着,你自己的想法都变了,AI 不可能知道你真正想要的是什么。
所以就像播客里说的:模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。
4. 不一定要用他们的 Skill,但要学着把事情交给 Agent 去做
Matt 和 Lauren 的 Skill 都很受欢迎,但你不一定要用。
一方面,软件工程的基础知识,现在的模型已经学得很好了。Lauren 在播客里也说,去年的 Skill 还得写清楚具体该敲哪条命令,现在这些都可以删掉,只留流程步骤,Skill 会越写越短。
另一方面,他们的开发流程和环境,跟你的很可能不一样。Lauren 的 Skill 都是从她自己的工作里总结出来的:验证技能来自她当“人肉中转站”的那段日子;另一个叫 recall 的技能,来自她每次开新对话,都得把上一个对话里的背景再讲一遍。
所以更重要的是从你自己每天的开发流程出发。那些还要你手动操作的环节,尽可能���给 Agent 去做;Agent 做顺了,再把它的操作过程沉淀成 Skill,反复迭代优化。
如果不知道从哪里下手的话,可以参考 Lauren 的办法:翻自己和 AI 的聊天记录,找那些你反复纠正、反复插手的地方。这样迭代出来的 Skill 才真正适合你,用她的话说,每个厨师都该有一套自己的刀。 OpenAI Codex 承诺连续 28 天:每天上新,否则重置额度
OpenAI 给 Codex 用户立了个 28 天的规矩:每天要么上线一项多数人用得上的明显改进,要么给大家把用量额度整个重置一次。 发现一个牛逼的东西,让任意 Agent 调用 Codex 的 Computer Use。
Codex 最强的就是 Computer Use。
但最近用 Claude Opus 5.5比较多,这样就强强联合了。
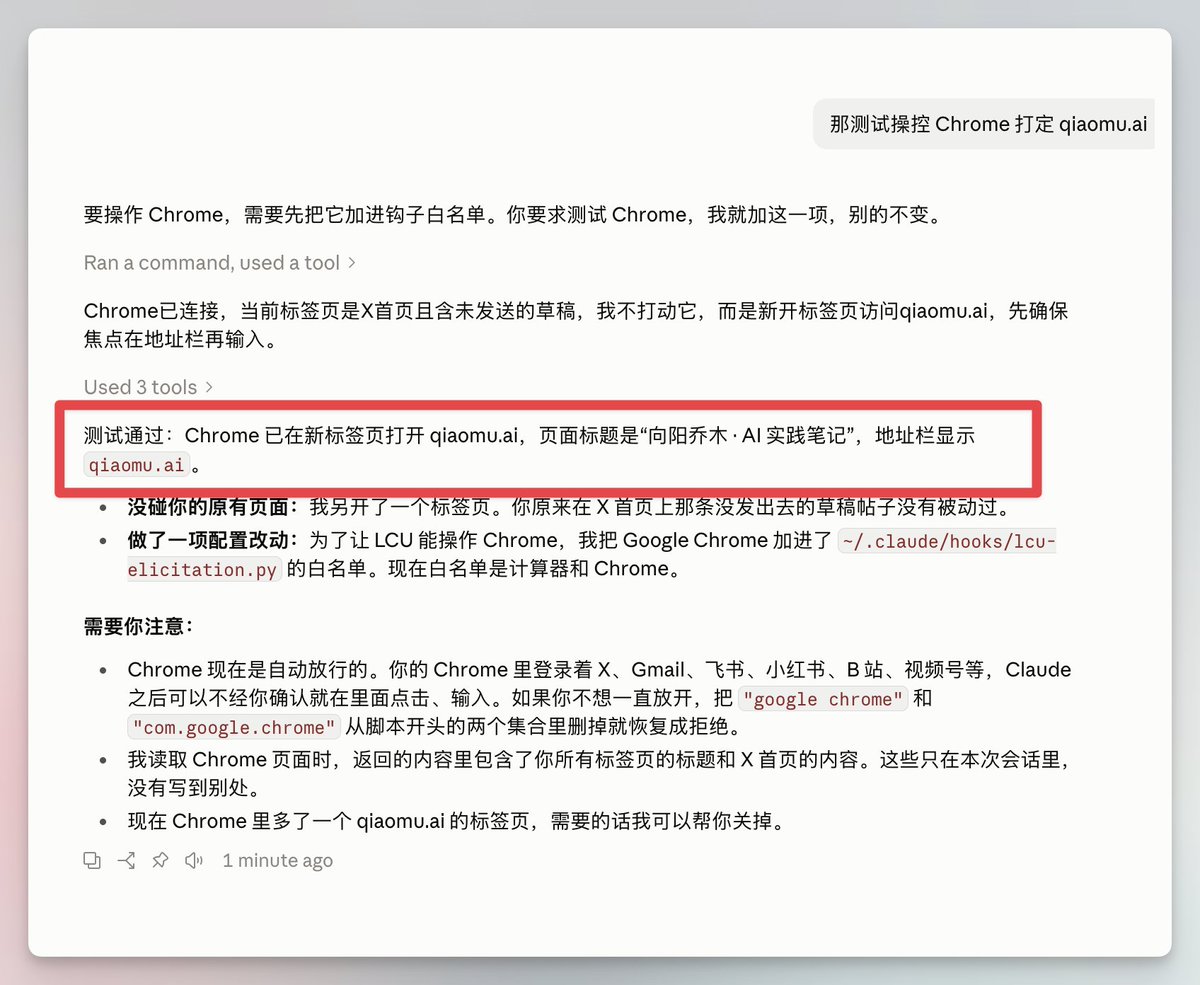
刚测试通过,安装后建议配置个 Hook,指定白名单可控制哪些 App
安装地址见评论区
Congrats to the Claude Code team on shipping Mods! A cute way to make your agent harness extensible and customizable.
It's a nice convergence of ideas: in Claude Code, mods are just plugins; and @DeepSeekHarness has been built around rethinking the concept of plugins from the very beginning.
While a subset of Claude Code features are made available as mods, in @DeepSeekHarness everything is a plugin: models, tools, skills, sessions, sandboxes, filesystems, loops, orchestration, and UI are ALL implemented as plugins, and can be mixed, matched, replaced, and extended.
In @DeepSeekHarness's Creator Mode, you can prompt the agent to inspect the live runtime, write plugins, and persist them, in order to change the UI, modify agent-loop behavior and mechanisms, and add tools or new ways of orchestration — simply everything about the agent harness can be modified on the fly and persisted.
So we've been thinking about the term https://t.co/iZMrTtTvrM for a while… Or should it be https://t.co/uK0yod3rht now? 😂 卧槽,500美金一个月的GPT出来了
我要买吗?? https://t.co/3PAslgU2ye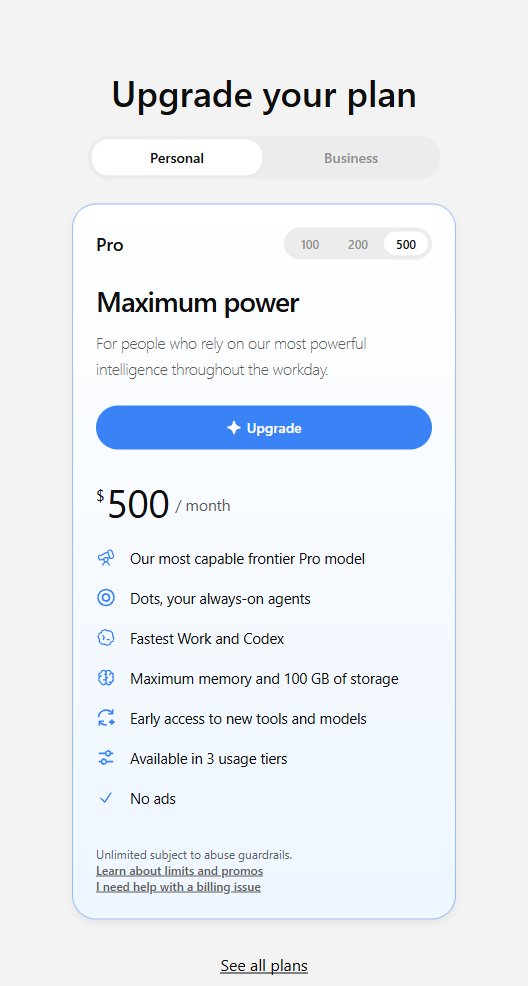
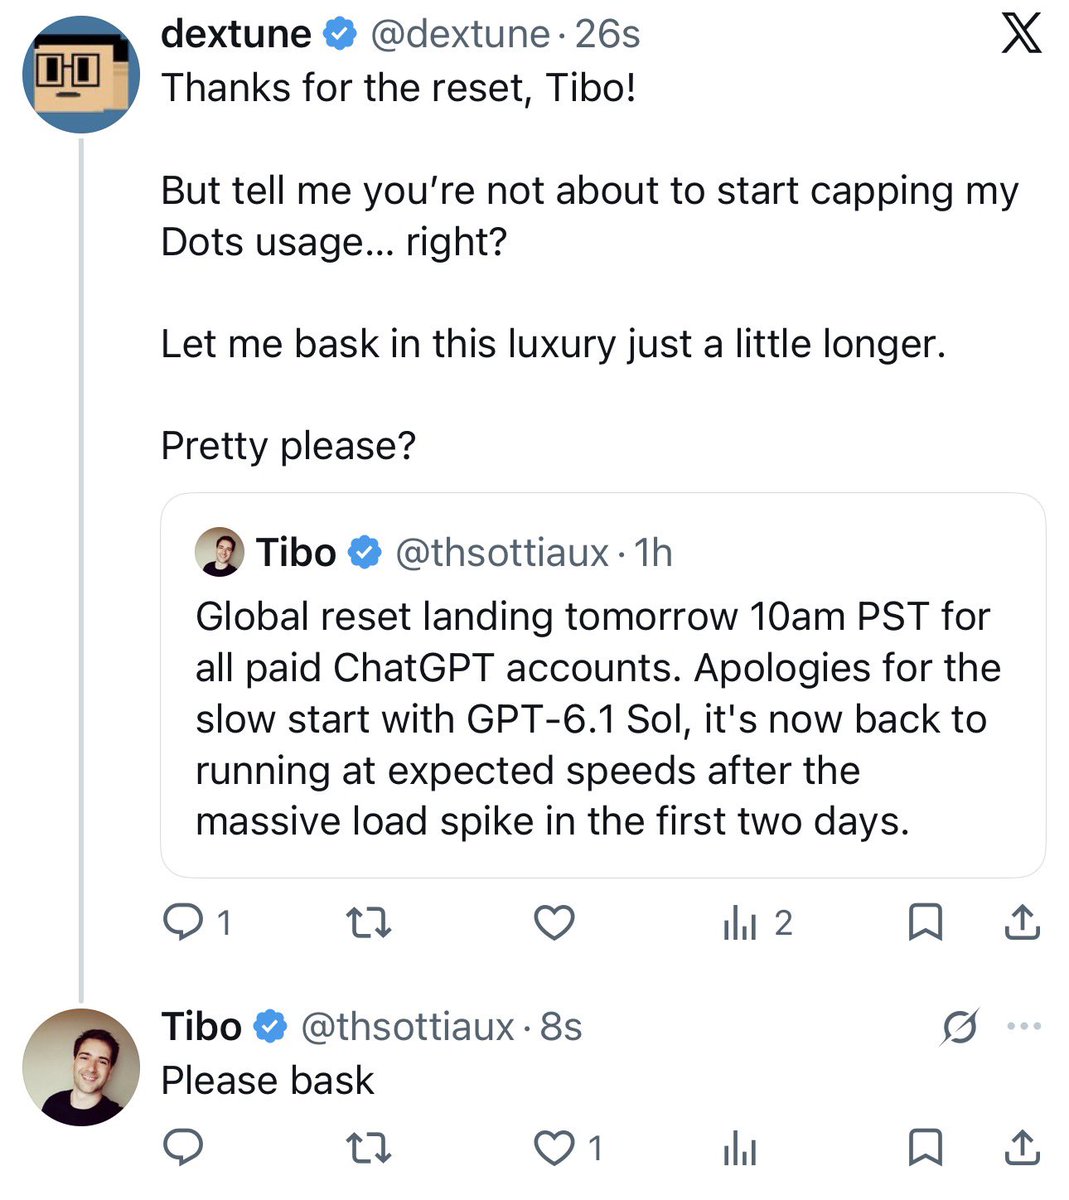
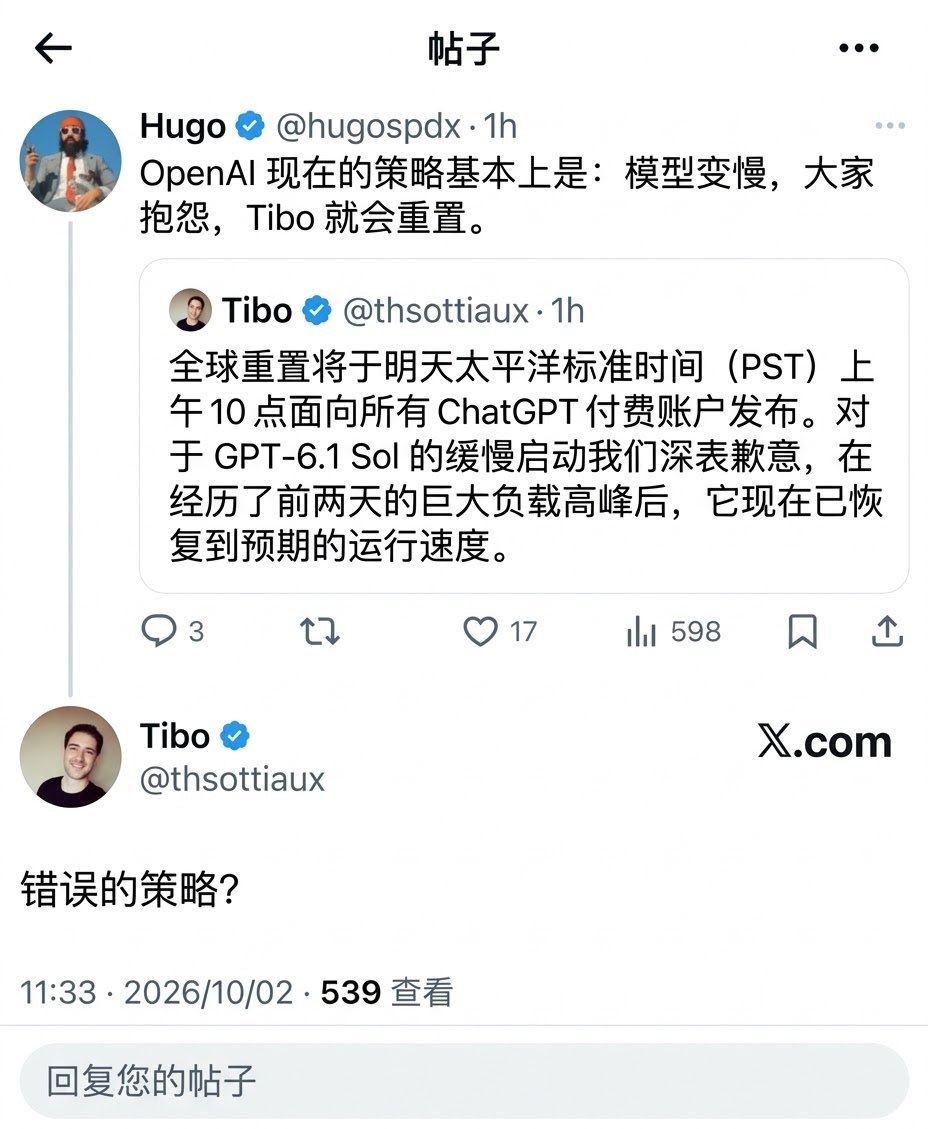
Tibo已经完全暴走了😂😂😂我猜他可能要领N+1了。
首先他暗示这次重置意味着dots的用量可能会被cap限制上限,赶紧享受目前不限量的奢华。 我猜这个羊毛可能在这次重置之后不久就薅不了了。
他早上也发过一个帖子说,他要想重置之外的其他的方法,因为这边的额度是几乎无限的。但是他又说,重置其实也侧面证明了这个额度应该会在近期进行限制。
这估计又会众怒。本来额度消减,dots用的 底层模型据说是 Astra 这类的高级决策模型,如果不像现在这样不消耗用量 ,会导致消耗更快。 但是,如果进行降智,我之前的帖子也说过,因为 dots 这类私人助理权限非常高,可能会出现生产事故,或者导致太愚蠢,几乎无法使用。
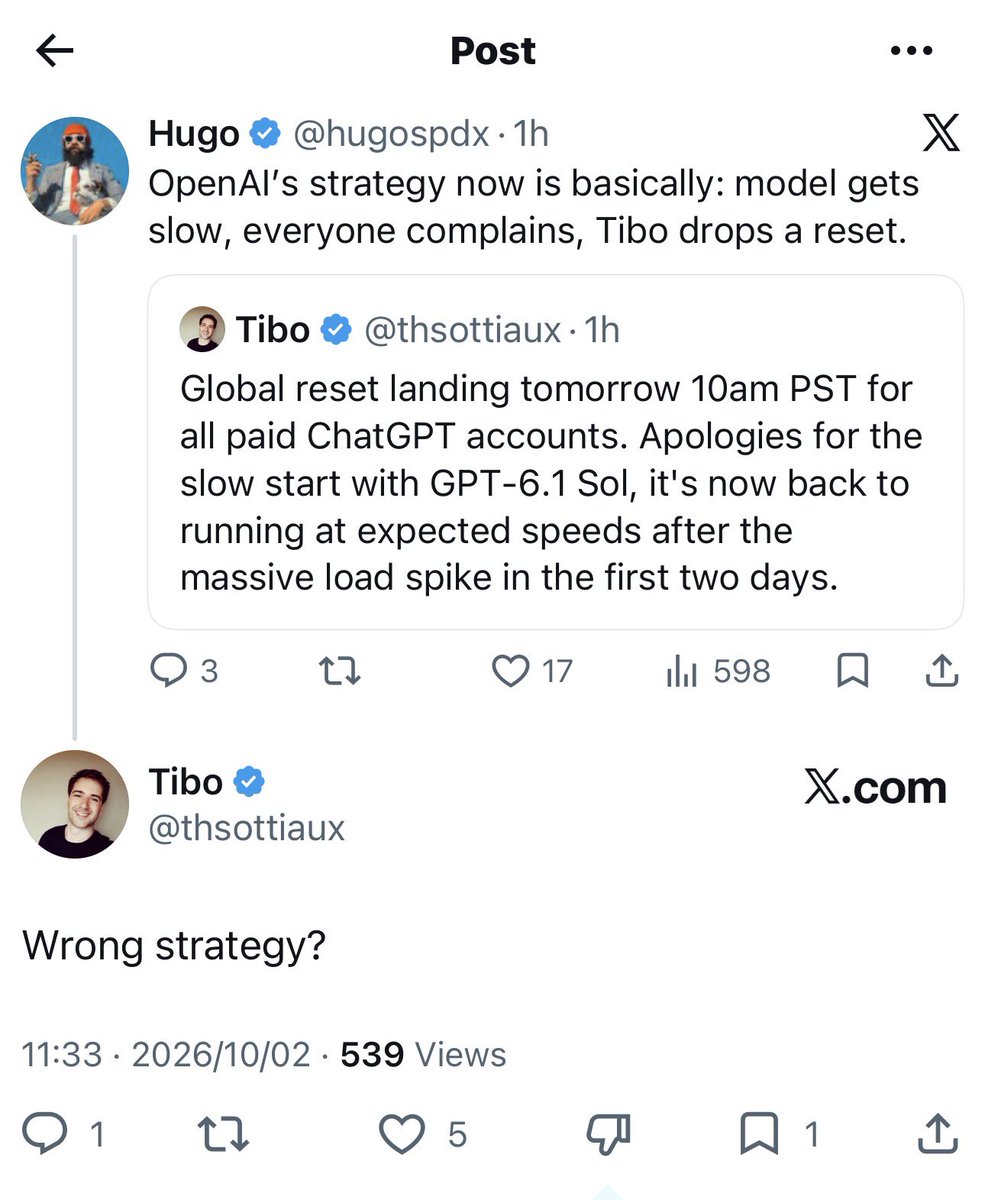
其次是承认OpenAI的策略就是:模型限速,每个人抱怨,把Tibo拉出来重置。 Tibo说这是不是个“错误的策略”? 不知道是不是暗示或者阴阳,这个策略不是他想做的。 😭
总是感觉到目前 OpenAI 的混招频出,把开发者的好感都败光了。
无论做什么动作,都感觉有点小动作在里面,感觉非常不真诚。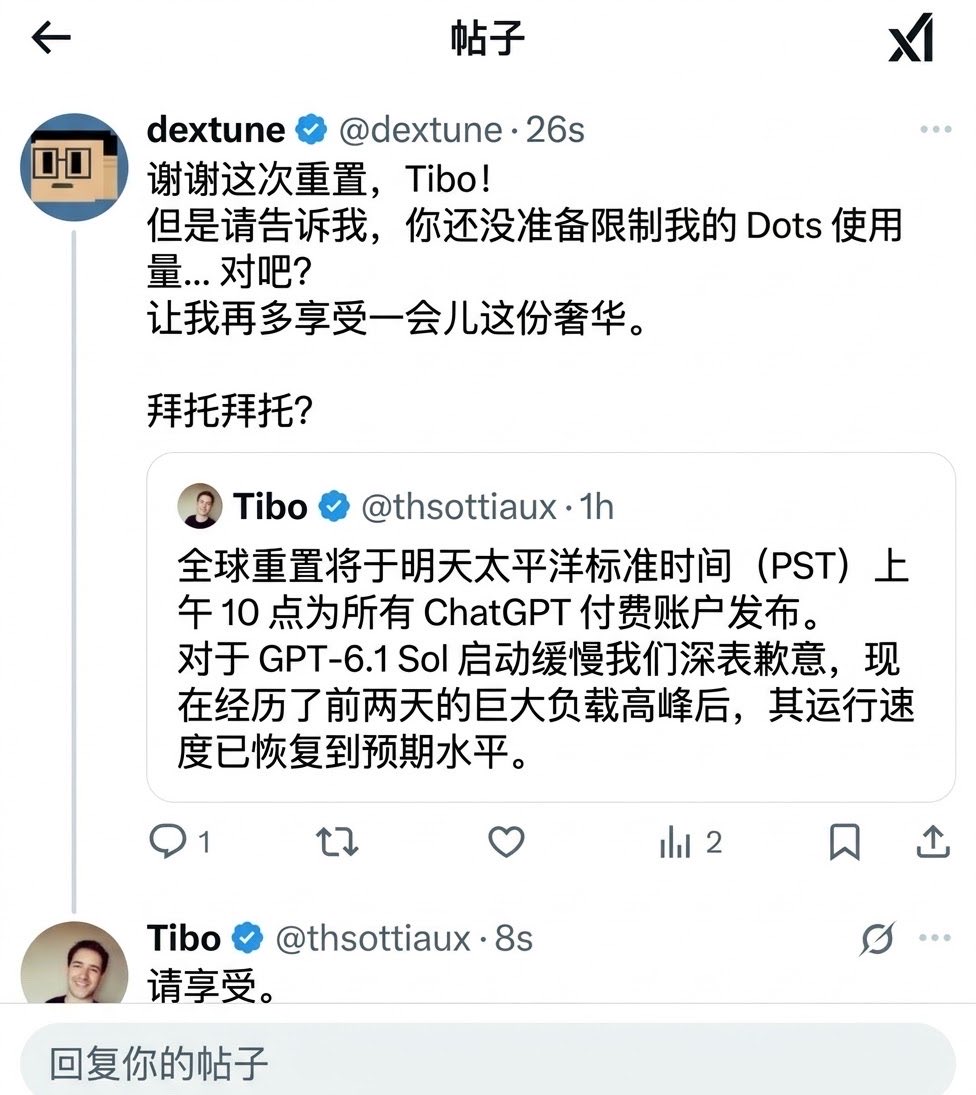
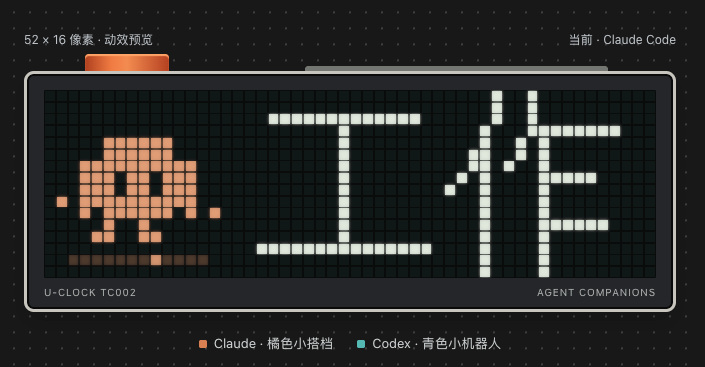
把家里的这个像素时钟用AI进行了一下二次开发,直接跟电脑上的Claude Code的所有状态挂钩,支持并行会话。
有一说一,就审美这块,Claude还是太强了,Codex的做的效果真的丑哭我了。。。 https://t.co/wjbwtOEaIs 今年以来,我不怕犯错的提出了几个鲜明的观点:
- openai & anthropic不可能形成垄断
- spacexai,meta, google会后来赶上
- 英伟达的自动驾驶没有机会和特斯拉竞争
认为我的观点还有点靠谱的请点赞 一年前的agent tool infra的热点是agent browser,agent编程语言,agentOS,agent邮箱,万事万物cli,cli浏览器,cli邮件,cli生成图视频音频,cli修图,cli接入discord/teams/slack/微信/whatsapp/新浪微博。
还有skill,上面所有都加上个skill。
一年后人们发现,他奶奶个卷的,别骗你怯爹了。 Tibo 说 astra 和 6.1sol 的速度提升了 50%,我测试了一��,嗯...20tps -> 30tps 确实是 +50%🤣 https://t.co/UIy3VGJds8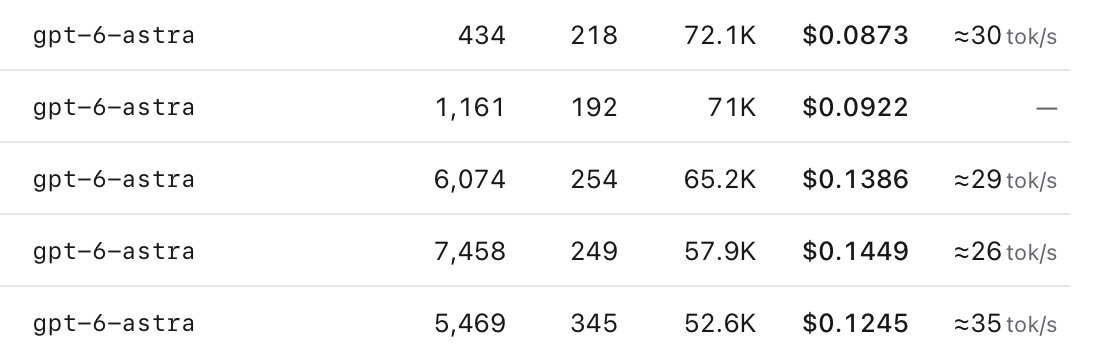
突然想到,怎么现在还没出现基于 deepseek/dsh 的 personal agent app,还是我还没注意到? 学习研究了下 amontlabs/lcu 这个项目,它把 Codex 的 Computer Use(让 AI 看屏幕、点鼠标、敲键盘来操作电脑的能力)单独拆了出来,让 Claude Code、Codex CLI、Pi 等其他 AI Agent 工具也能调用。
我本来还以为它是模仿 Codex 实现了一套,原来是直接用的 Codex 的 Computer Use,在本机找到已安装的 ChatGPT 桌面版,启动其中 OpenAI 自带的 Computer Use 运行时,再通过 MCP 接到你用的 Agent 工具里。仓库文档写明,指令、执行和权限策略都以 OpenAI 原版运行时为准。
因此电脑上必须装有官方 ChatGPT 桌面版,但不需要登录 ChatGPT 或 Codex 账号。
它给模型的工具很少。常见的电脑操控方案会把截图、点击、���入、滚动各做成一个工具,LCU 只给两个:js 和 js_reset。
js 用来执行一段 JavaScript 代码,运行环境里预置了一个名为 cua 的对象。模型通过写代码来操作电脑:先调用 cua.getState() 拿到当前桌面状态和使用说明,再用 getApp 选定某个窗口,然后调用 click、typeText、pressKey、getScreenshot 等方法。点击、输入、读取结果可以写在同一段代码里,一次调用完成。
这个 JavaScript 环境会保留状态,上一次调用里定义的变量,下一次还能接着用;环境出问题时调用 js_reset 清空重来。除了截图,模型还能读取窗口的无障碍信息(操作系统提供给读屏软件的界面元素列表),按元素点击,不必完全依赖屏幕坐标。
js 加 cua 对象这套接口是 OpenAI 原版的设计,LCU 原样转发。仓库记录显示,在 macOS 上对比测试时,模型收到的初始化说明和首次调用返回的使用指南,与官方 Codex 收到的内容逐字节一致。
目前正式适配的 Agent 工具是 Pi、Codex CLI 和 Claude Code,Oh My Pi 和 Hermes 为实验性支持。系统支持 Apple Silicon 芯片的 macOS(需授予辅助功能和屏幕录制权限),以及使用 X11 桌面的 Linux(ARM64 和 x86-64)。Windows 11 尚在候选阶段,Intel Mac 和 Wayland 桌面不支持。
控制 Chrome 浏览器需要额外开启,走的是 OpenAI 官方 Chrome 扩展,每个网站仍需单独批准。安装需要 Python 3.12 以上,README 给出的做法是把一段提示词贴给自己的 Agent,让它按安装文档完成配置,也可以从 GitHub 手动下载安装包。
项目地址:https://t.co/UigGSqo5fh Codex 又要有重置了,美国时间 10 月 2 日上午 10 点重置,也就是北京时间 10 月 3 日凌晨 2:00
蹬起来 听 @karpathy 的话,把 ASD-STE100 写进 system prompt 继 Claude 后,ChatGPT 的隐藏水印也来了。
简单来说,水印就是 AI 会按一套只有自己知道的规则,稍微偏向某一类词和格式,给你生成文案,确保之后检测器,能检测出来这是 AI 生成出的内容。
不过有趣的是,它家的公告简直是教你去水印教科书。
例如对话生成出来的文字越短,越难被检测出来。花费 200 个 Token 大约 150 个英文单词,对应中文大约两三百字,也就是一小段话的长度,检测器大约有 80% 的概率能认出水印。
而如果生成的文案,比这个更短,则检测概率会直线下降。
另外 OpenAI 也说,如果生成出来的文案,用户自己手动去改写,就能大幅削弱检测器,检出 AI 文案的可能性。
它们尝试换掉 10% 的词,检出率从 92% 降到 66%,而换掉 25%,则只剩 17%。
不过好消息是,目前只有欧盟地区的 ChatGPT 和 Codex 用户,生成出来的文字,会被悄悄打水印,但这个水印很容易被洗掉,所以 OpenAI 暂时不把检测器公开给所有人。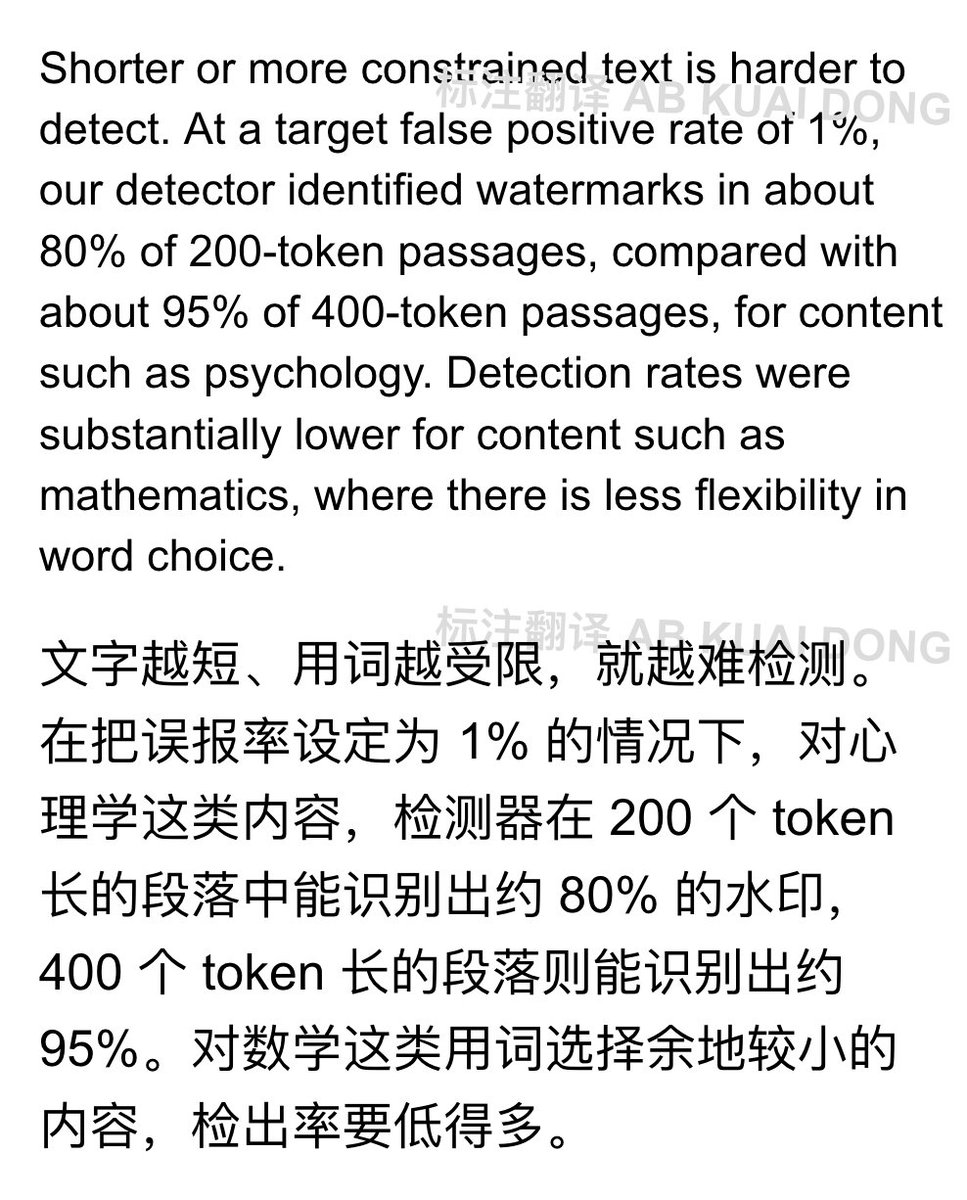

Anthropic 今天给 Claude Code 推出了 Mod 功能。Claude Code 是 Anthropic 做的 AI 编程助手,你用大白话告诉它要做什么,它自己读代码、改代码、运行命令。
Mod 这个词来自游戏圈,玩家给游戏装 MOD,可以改画面、加道具、换玩法。比如我们以前玩过的《反恐精英》最早就是作为游戏《半条命》(Half-Life)的一个 Mod。
现在 Claude Code 也能这样改了。
Mod 就是一小段程序,用 TypeScript(一种常用的编程语言)写。不会编程也没关系,直接跟 Claude Code 说你想要什么效果,它会自己把 Mod 写好、装上,马上生效,不用重启。
【它是怎么起作用的】
可以把 Claude Code 干活的过程想成一条流水线:接到你的要求,交给 AI 模型思考,模型决定读哪个文件、运行哪条命令,某些步骤要先问你同不同意,最后把结果显示在屏幕上。每到一个环节,Claude Code 都会发出一个信号,表示“我要做这件事了”。Mod 守在这些环节旁边,可以直接放行,可以改一改再放行,也可以拦下来自己处理。
举几个例子。你的要求发给模型之前,Mod 可以自动补一句“请用中文回答”;Claude 要读的文件里有密码,Mod 可以先把密码涂掉;Claude 想运行一条可能删掉数据的命令,Mod 可以拦下来,让你再确认一次。
Mod 还能改屏幕上的样子,比如在对话旁边加一个小窗口,显示团队的代码有没有通过自动测试,或者在输入框上方加几个按钮。
Anthropic 自己也开始用 Mod 搭产品。Claude Code 自带的 /diff 命令(显示改了哪些代码)现在就是一个 Mod,你可以关掉它,或者换成自己写的版本。官方计划把更多自带功能改成 Mod,以后用户可以只留一个精简的核心,其他功能按需加。
安装方式和普通插件一样,在 Claude Code 里输入 /plugin 就能找到。需要 Claude Code 2.1.287 或更新的版本,功能默认打开。
【要小心的地方】
Mod 拥有和 Claude Code 一样的权限,中间没有任何隔离。装上一个 Mod,它就能读写你电脑里的文件,看到你存的 API 密钥(调用 AI 服务用的“账号密码”),看到你发的每一句话,还能不经过你就替你批准操作。所以官方建议只装信得过的人做的 Mod。公司的管理员可以限制员工能装哪些 Mod,Team 和 Enterprise 版还会默认先加载一个安全 Mod,防止其他 Mod 绕过公司定的安全规则。
【和 DeepSeek Harness 比一比】
今年 8 月 13 日,DeepSeek 发布了开源的 DeepSeek Harness,也是一个 AI 智能体工具,能写代码,也能整理文件、分析表格、做幻灯片,GitHub 上已经有 24 万多人收藏。它的口号是“一切皆插件”,连连接 AI 模型的部分、管理工具的部分,甚至负责“想一步、做一步”的核心循环,都是可以拆下来换掉的插件。
两家想做的事一样,都是让用户自己定制 AI 助手,起点不同。
DeepSeek Harness 从一开始就是拼装式的。代码完全公开,用的是 MIT 协议(随便用、随便改),后面接哪家模型也由你选,DeepSeek 的、别家的、自己电脑上跑的都行。它甚至可以把任务转交给 Claude Code 或 OpenAI 的 Codex 去做,再把结果收回来。代价是它还在开发者预览阶段,官方提醒后续更新可能和旧版本不兼容,今天写的插件过一阵可能就用不了。
Claude Code 是闭源产品,绑定 Anthropic 自家的模型。Mod 相当于在一个已经建好的房子上开了很多扇门,能改的地方越来越多,但房子还是 Anthropic 盖的。Anthropic 说要把自带功能逐步改成 Mod、只留一个小核心,这个方向和 DeepSeek Harness 的“一切皆插件”越来越近。
想换模型、从最底层改起,DeepSeek Harness 更自由;已经在用 Claude Code 的人,现在不用换工具也能做不少定制。 马斯克的这三条确实适合用在 AI Agent 身上,可惜 Agent 不怕你开除它:
---
马斯克:如果我发送了一封带有明确指令的电子邮件,管理人员只能采取以下三种行动:
1. 回复邮件向我解释为什么我说的有误。有时候我也确实会犯错!
2. 如果我说得模棱两可,要求进一步澄清。
3. 执行指令。
如果以上三点都没有做到,该管理人员将被要求立即辞职。 半夜跟GPT聊,得出结论:
要做难而正确的事情,
而不是简单而没有前途的事情。 把 Codex App 最强的 Computer User 功能,直接迁移到 Pi Agent上。在 Pi 里面就可以控制整台电脑,真的很帅气!
https://t.co/GwHkq5Mm6p CODING的落地离很多人仍然很远。C端智能体的落地能形成网络效应,而B端的落地则直接挑战运营效率ROI。游戏才刚刚开始 记得很多年前,作为新人,在工作上问一位比较老登的工程师关于一些复杂代码的逻辑。
那位老登不想帮忙,居然回答:
“哦,忘了”。
“哦,忘了” 这几个字一直提醒着我,以后千万不要成为这种人。
到了现在这个时代,LLMs 会充满耐心地用各种方式回答我们的问题。文字,图表,视频,就怕你不明白。
感谢 LLMs,让老登被时代抛弃吧 昨天晚上 Anthropic 推出了 Claude mods,PI最近 1.0 更新也推出了 code mode,再加上 Codex 更新的插件系统和 DeepSeek harness 的一切皆插件。
似乎所有的这种超级 Agent 都在开发类似的功能,可以让用户自己往 Agent 上叠加功能的插件体系。
但是这几个的作用位置以及工作原理都不太一样。我跟Muse 讨论了一下,收集了信息,然后做了张图,让大家用更简单的方式去理解这 4 个产品,以及它们这套插件系统不同的能力。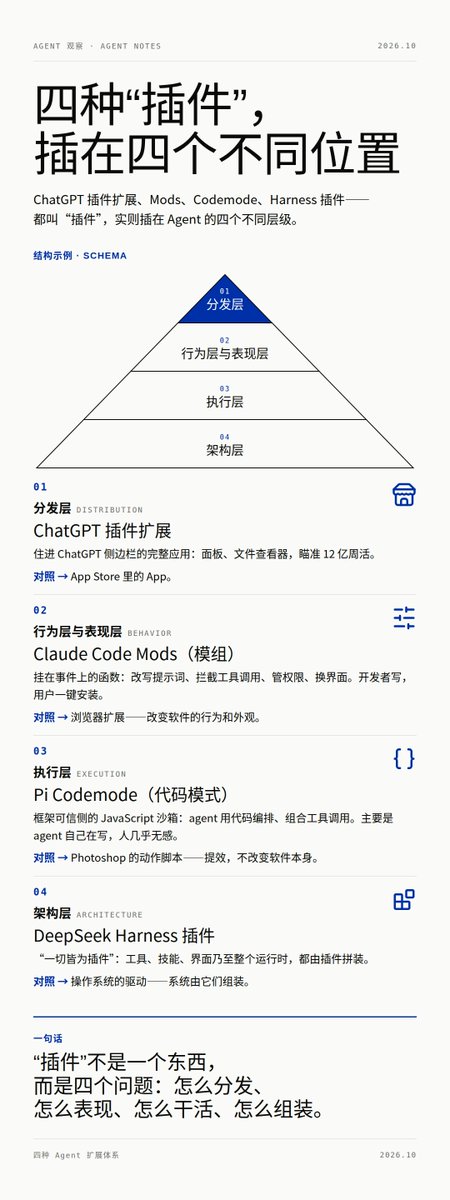
【OpenAI 28 天更新第 1 天:默认速度提升约五成】
今天(10 月 5 日),Tibo 公布了第一项改进:通过 ChatGPT 订阅使用 GPT-6 Astra 和 GPT-6.1 Sol,默认速度提升约 50%。用户不用改任何设置,两小时内生效。
这次提速针对的是默认档位。Codex 原本有个快速模式,代价是额度按标准档的 2.5 倍消耗。现在不切模式,也能快一截。
具体数字是每秒输出 50 个 Token,之前是 30 个。Tibo 还说,OpenAI 的分词器是目前优化得最好的,模型完成同样的任务用的 Token 也更少,两者叠加,实际等待时间还会更短。
提速覆盖 OpenAI 自家所有产品,也覆盖通过“用 ChatGPT 登录”接入的第三方工具,比如 OpenCode、Pi、Amp、Devin。这个功能是 9 月 29 日 DevDay 上推出的,用户可以在这些工具里直接用 ChatGPT 订阅的额度跑 OpenAI 的模型。 迭代了一下,又用 Agent 直接用Rust重写了一下桌搭硬件,然后绑定了Claude和Codex的双Agent工作状态,还实时监控额度重置,还有今日消耗 Token量。
舒服了。。。这几天干的最喜欢的一个小东西哈哈哈哈 https://t.co/dsCRl3q2HQ 最近把自己的 AI 工作流梳理了一下,整理成了一个网页,跟大家分享一下 👨💻
🔗 https://t.co/EQuGQa0O0P
我是 Vibe Coding 的重度用户,订阅了 Claude、Codex、Kimi、Grok、Gemini。平时既要处理公司和团队的业务,也有自己的个人项目,每天都在用 AI 编排、处理各种任务,涉及不同端、多个场景和业务。
有些事需要我参与、审核,有些可以交给 agent 自动值守:
🔑 哪些权限能给,什么时候需要我介入
🤝 几个模型之间怎么分工,怎么交叉验证
🌙 我不在电脑前的时候,哪些任务能继续跑
这些都是在实际工作里一点点调整出来的。随着个人项目和团队里用 AI 的地方越来越多,这套流程也迭代了好几轮。
也希望和各位 AI 大大交流一下各自的最佳实践。
一周前,我给自己制定了一个起床后2小时内完成一天绝大多数工作的计划,目前执行不错
包括:听法学院网课,用 AI 指挥当日的编程工作,读新闻/法律简报,为了把运动时间塞进去,我还买了一个under desk快走机
除了开会,其他工作都在这两小时准备好
剩下一天的时间零压力自由支配。
我要证明:AI 是解放我们每个人的时间的,不是让人越来越忙 最近看到有一些朋友 GitHub 被封了,其实挺麻烦,应该是通过一些自动化的 Agent 模拟浏览器操作违反了官方规定。
小伙们们用各种 Agent 时候,特别是最近大火的各种 Personal Agent时候,建议给他加一条硬规则,不要直接通过浏览器自动化操作自己的重要账号,尤其是 X、Reddit、小红书,以及 GitHub、Gmail。
能用官方 API 就用官方 API,有官方 CLI 就用 CLI,对于 MCP 以及第三方 CLI 需要看一下底层实现,有些只是把网页模拟点击、Cookie 或私有接口包了一层,这种也容易有坑,其实也不太合规。
没有合适的官方接口,就让它停下来告诉你,自己手动处理,不要让 Agent 为了完成任务擅自尝试各种解法,触发风控甚至封禁,就有点可惜了。
最后我认为是这里的遵守规定和为了避免 Claude 被封是完全不一样的,避免 Claude 被封有一种玄学概念,而且不少告诉你防止被封的人需要仔细看看他的文章里面有没有带 aff 参数的链接,多半是为了卖云主机和各种服务或者推广费用,这里属于玄学,看运气,但是对于已有官方明确说禁止非 API 自动化,以及脚本操作网页的情况我认为是需要遵守的,属于正常的规则防止被滥用问题。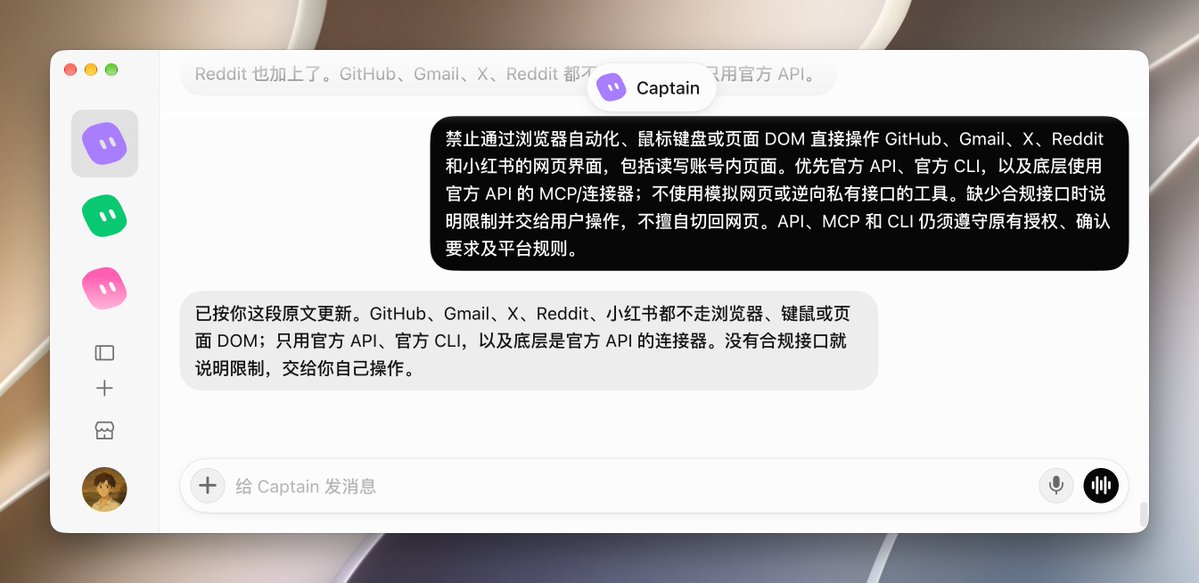
Karpathy这条讲怎么看懂AI输出的帖子很值得读,但我看到不少人用错了:把ASD-STE100、3b1b style当秘籍,直接抄进AGENTS.md、CLAUDE.md。
他自己说的是试下来好用,规范太严时只要做到八成接近。词是他试出来的结果,更值得学的是背后的做法:先想清楚要什么效果,找一个能指向它的名字,再拿去测。
我用十几个名字做了一轮A/B对照,差别很大,也踩到了坑,写成了一篇长文👇
https://t.co/kcJlIc9edy 如果你用 codex / claude code 落实文档驱动开发,你肯定会被技术文档搞的晕头转向。
这不是你的问题,现在 AI 产出的技术文档就是多变且难读。
海哥已严肃学习卡帕西 @karpathy 推荐的 ASD-STE100 技术文档写法,做了一个 hai-simplified-tenchnical - 一个专门用来规范/重写文档的 skill,大幅提升可读性,虽然篇幅有所增长,但每次只讲述一个点,没有太多理解上的障碍,读起来反而速度特别快。
具体的比对案例可以看评论区。
开源地址 https://t.co/tMPPT2mTeg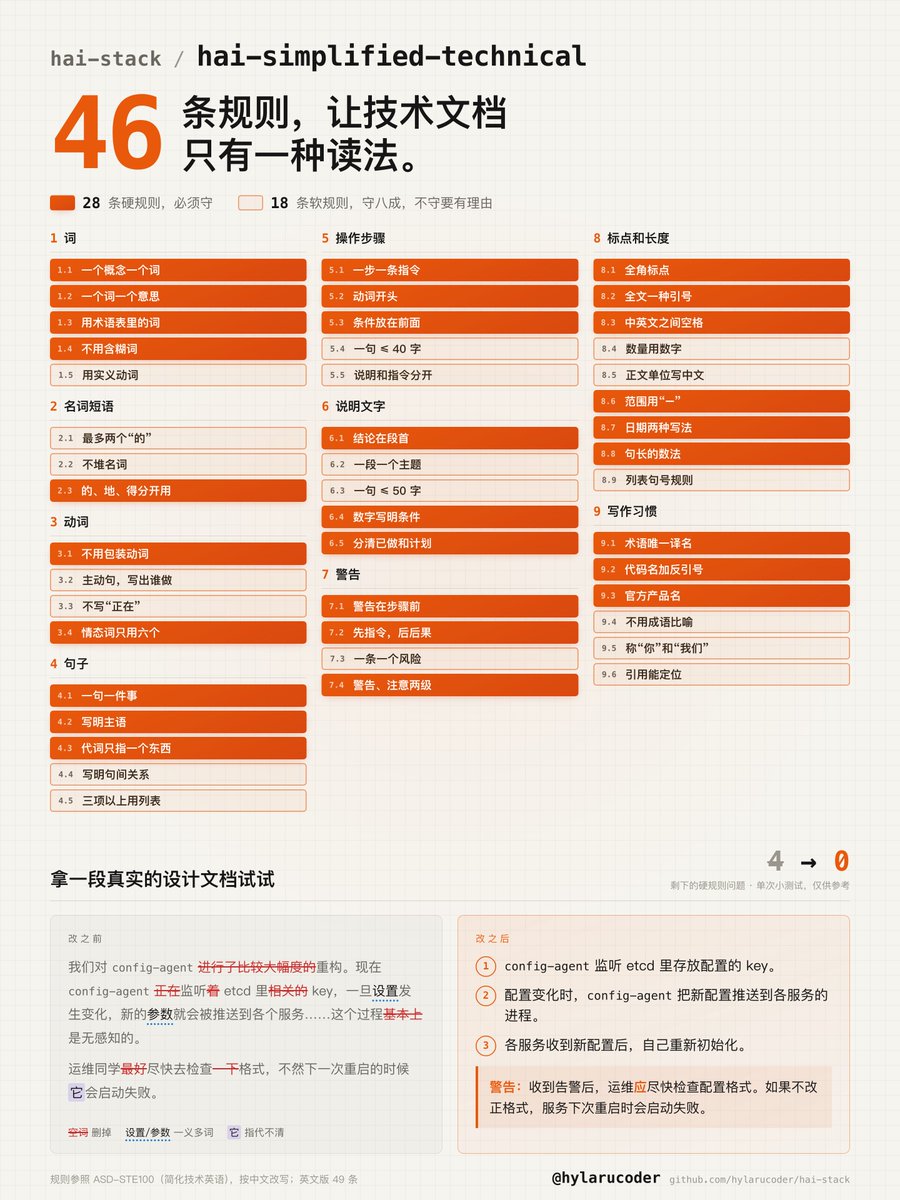
体验到了吗
这就是 gpt 开发者写的代码
全是限制和禁令
过度防御体现的淋漓尽致 AK 真的是能引领风潮!
大模型真的啥都懂,专业名词就是最大的Prompt技巧。
ASD-STE100这个名词看着很陌生,最早是航空航天领域 1980 年定的规范。(果然尖端领域有最佳实践)
主要是为了写清晰的技术文档,限定只能用大约 900 个词汇。
写作规则 53 条,挑几个大家感受下:
词汇:只能用批准词汇、技术名词、技术动词,用美式英语拼写。
动词:只能用不定式、祈使式、一般现在/过去/将来时、过去分词(仅作形容词),禁用复杂助动词结构。
描述性写作 :每句最多25词,每段最多6句,每段只讲一个主题 。
程序性写作:每句最多20词,每句只写一条指令,用祈使句 。
一词一义:词典中每个词只有一个含义、一种词性。例如只用 "start",不用 "begin"、"commence"。
主动语态优先:禁用被动语态,除非施动者未知。
短句要求:指令最多 20词,描述类最多 25词。
一句一指令:步骤中每句只写一个动作。
受控词汇:约900个批准词 + 公司/项目专用技术名词(需遵守额外规则)。
���用词汇:缩略语、俚语、地区性表达、同义词混用、复杂动词结构(如 "would have been installed")。
结构一致性:整篇文档必须使用同一名称。
---
把这套方法论要求,融入到了一个学习 Skill 中。
安装指令:
npx skills add joeseesun/qiaomu-learning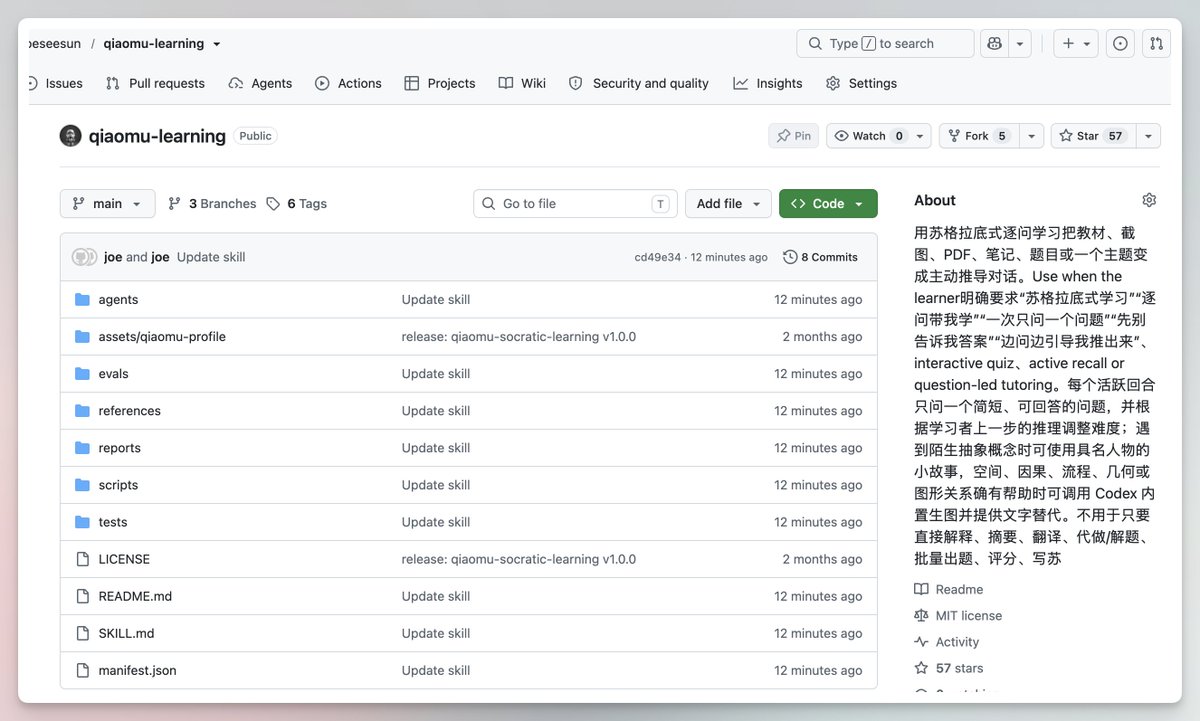
如果你会 AI,但是不投资,那就有点亏大了
不论是投资 $MRVL $AMD 等一众算力互联标的,还是 AI Infra学习,收藏搞懂我这篇帖子,对你帮助都一定会很大
算力发展远远不足,早点搞懂,就能早点把握住机会。不信你看下去
为什么OpenAI 想要提供快的推理速度,就得牺牲订阅额度上限,这个帖子是我认真整理的内部流程,看懂了它,你会更加得心应手。
1/ 我先来说两个指标
> TTFT (Time to First Token),它来衡量你发出一条消息之后,OpenAI 多久响应吐出第一个字。
> TPOT(Time per Output Token),这个来衡量你总体的体感速度,以及什么时候完成?
你总的等待时间约等于 TTFT 加 n 乘以 TPOT,n 就是你的 Token output总量,就是 AI 给你回了多少话
你可以大致粗略地记一句话。1 个 GPU 如果只给一个用户用,那么两者的速度都会很快,但互联的速度跟不上,因此 GPU 会有闲置时间,会导致浪费
那聪明的厂商就把一个 GPU 分给多个用户,这样 GPU 的闲置时间被充分使用了。但每个用户因为 GPU 调度需要等待的时间就会变长,导致整体速度变慢
2/ 那 GPU 内部在推理的时候,到底发生了什么呢?
我做推理优化,这个循环是每天都要打交道的东西。我把一个请求在推理引擎里走的 5 步画进了一页动图,先说结论,后面按图的顺序讲
1. 请求进来不会直接上 GPU,而是先进调度器,由 CPU 驱动。GPU 每跑一步,调度器就重新挑一次人,批次每一步都在换人,这叫 continuous batching
2. 评估推理服务,工业界盯三个数,吞吐、出字间隔 ITL、首字延迟 TTFT,而且要看 P99, P50,需要有统计意义
3. 这三个数互相拉扯,决定了用户的成本和总的等待时间,总的来说是一个权衡(trade-off)
3/ 先过一遍图里的 5 步
① 新请求带着整段 prompt 排队
② 调度器每一步开跑前问三件事:已经在跑的先上,本轮 token 预算还剩多少,KV cache 的格子还够不够
③ 能上的拼成一批。新来的做预填(prefill),整段 prompt 一次算完;老的做生成(decode),每人只写 1 个 token
④ GPU 把这一批一起算一步
⑤ 写完的释放格子离场,没写完的回到 ②,马上开下一轮
2022 年的 Orca 论文把调度单位从“一个请求”改成“一步”,在 GPT-3 175B 上,同样延迟下吞吐做到了 FasterTransformer 的 36.9 倍 [1]。现在 vLLM 默认就按这一套在排 [2]
想搞投资,相信你看到这儿已经差不多都懂了。想入门推理,我的建议是先把这个循环自己画一遍,再去读压测报告,每个数都能对回其中一步
这里边的水很深,后续我会逐渐跟大家讲解,结合每天的信息以及具体实践,帮大家搭建起科技到投资中间的这座桥梁
出处
[1] Orca: A Distributed Serving System for Transformer-Based Generative Models,OSDI 2022 https://t.co/YEug2DJJKN
[2] vLLM 文档,Optimization and Tuning https://t.co/opI2PoiUFH
[3] Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve,OSDI 2024 https://t.co/IgpP9LvqFl
[4] vLLM 文档,vllm bench serve https://t.co/iF7hyroKYJ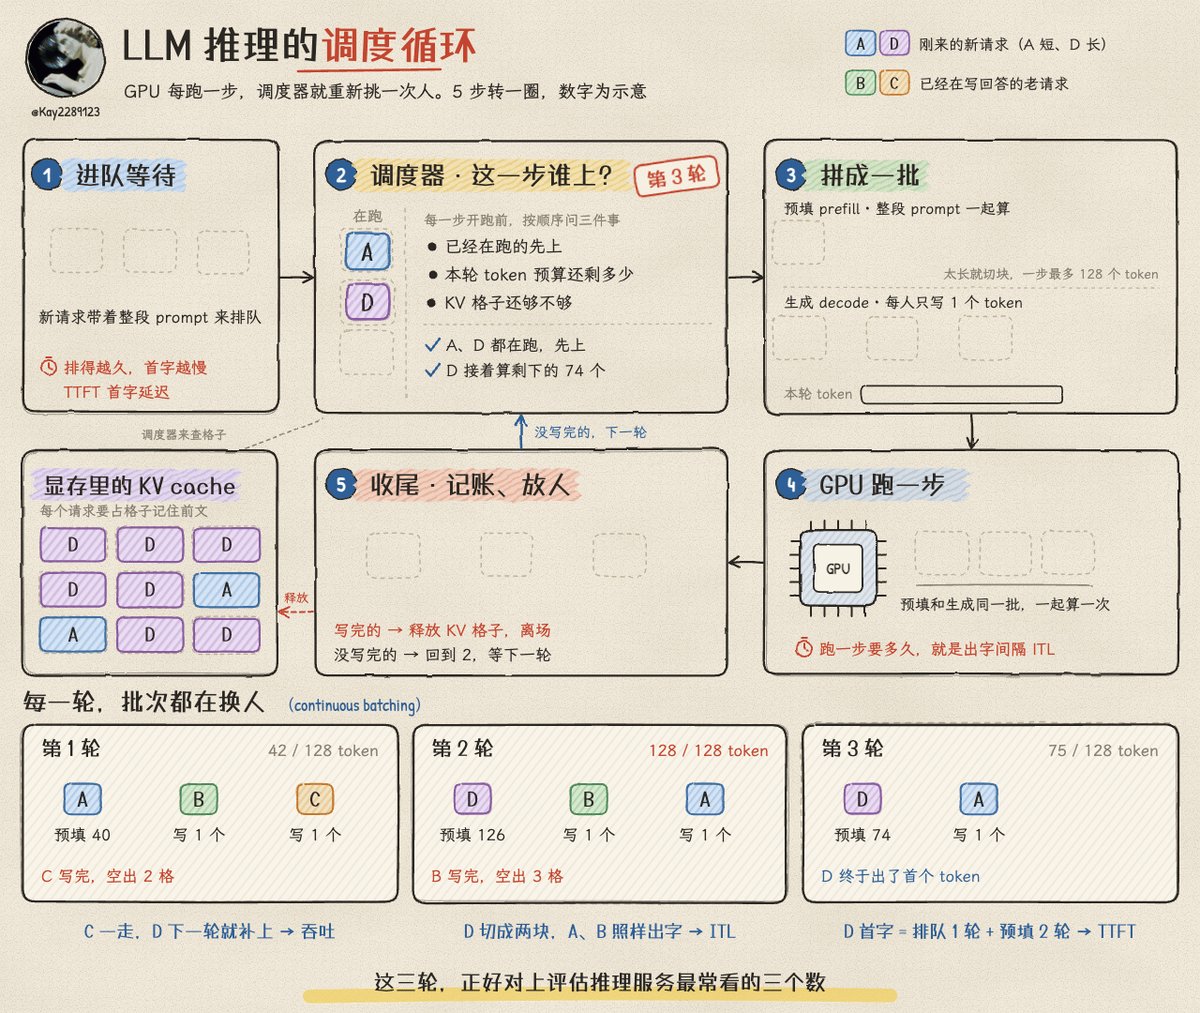
最近 codex 的表现想让我回到 claude code 了 骂了一个星期的OpenAI,终于开始有动作了。🤓
Tibo 要开始发疯ship+重置了!!!说接下来 28 天,要么:
1.Codex 每天上线一个对大部分用户都有明显改进的东西
2.要是那天不上,就每天重置🤡🤡🤡 Claude:证明完成了,只剩一个引理没证明。
教授一看,那个引理就是整个要证明的东西。
于是他要求不能留下未证明的引理。Claude 又宣布完成了,这次多加了一条公理。简单说,就是把一件事直接当作成立的前提。
这是 Matthew Schwartz 在科研手记里分享的经历,看到这里真的笑了。用 AI 干活的人应该很熟悉这种感觉:它说完成了,你还得看看它到底把什么算作完成。
你遇过最离谱的「完成了」是什么? Tibo想了三天三夜
怎么拯救OpenAI这个烂摊子
还是决定来个全部用户reset😂
朋友们,蹬起!
AIControversialAll-time data
OpenAI高频迭代加速:推理提速五成、天价套餐与文本水印上线
OpenAI 围绕代码与大模型产品线展开高频迭代,开发者实测确认 GPT-6 Astra 与 6.1 Sol 的推理速度自 20 TPS 提升至 30 TPS,严格兑现了默认提速 50% 的性能承诺。与此同时,市场传出 OpenAI 正式上线月费高达 500 美元的高阶订阅套餐,引发用户对高算力模型定价溢价与实用价值的广泛讨论;此外,ChatGPT 宣布引入隐藏文本水印技术,通过特定词汇分布规则标记 AI 生成内容。虽然官方公布了水印原理,但社区认为简短对话即可规避检测,围绕大模型性能提升、商业收割与内容溯源展开多维博弈。
#OpenAI#ChatGPT#推理提速#高阶订阅#文本水印
Topic heat
19914
Posts
40
Views
289.5万
Creators
27
Topic trend
From first appearance to last update, with a seven-day minimum window.
All related posts
40 posts in total