seekinganythingbutalpha

seekinganythingbutal…

@ivanalog_com最近同步 10/2/2026, 12:05:17 AM

Focus on 1) Technology and Dividend Blended 2) Drawdown protection. Check highlights and articles. No investment advice. Now building ModelDock

Iceland

7日排名
#940
总粉丝
16.5K
7日涨粉
+196
7日爆帖
40
7日曝光
55.2K
帖均曝光
1.4K

Ranking History

Today’s rankings update in real time. Historical records retain daily top-five entries for growth, posts, and reach. Click to view a poster.

No daily top-five records yet.

粉丝趋势

近7日每日已结算数据

内容表现趋势

曝光/互动与爆帖数均按自然日结算

爆帖趋势

近7日每日爆帖数

帖均曝光趋势

每日总曝光 ÷ 每日爆帖数

Participated Topics

Participated in 1 topics

View topic rankings

随着大模型在工程实践中的深入渗透,开发者社群围绕Claude与Codex的多智能体(Agent)实机协同以及系统提示词(System Prompt)优化展开密集落地实测。技术博主实操展示了利用Agent直接以Rust重写桌面硬件控制系统,并实现Claude与Codex双智能体工作状态与Token消耗的实时联动监控;与此同时,开发者结合业界前沿建议,积极引入ASD-STE100等标准化受控语言规范作为System Prompt,显著提升了大模型在复杂代码理解与架构设计中的精准度。讨论认为,从单纯向LLM问询代码到部署多Agent自主协同全流程,AI辅助编程正加速从单点工具迈向全链路自动化接管。

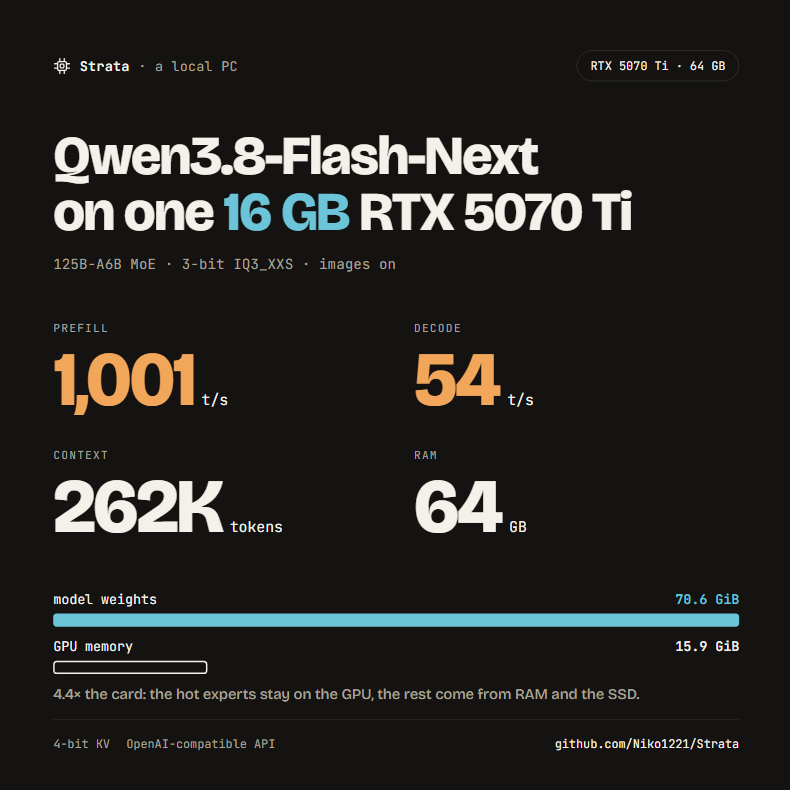
Participated post: 过去一周多,可能以后被证明是AI推理部署史上天翻地覆的一周。 上个周末,我的本地机双5070ti试跑Qwen Flash,只能做到200 prefill,10decode。 今天,在Strata和我自制的PR的支持下,目前可以跑到2200/67,而且只需要一张卡。 即读写速度都提高了近十倍。 更好的消费卡比如4090/5090,当然也有幅度相当大的升级(目前5090在流式处理的支持下,速度已经开始逼近RTX6000,当然显存还是不足)。 这当然带来了消费级硬件的新一轮大涨价。如今,就连曾经无人问津的 32G B70英特尔显卡都卖断货涨价了。 2200/67的速度是什么意思? 今天除了deepseek,muse等少数模型,大部分API达不到这个速度。 而一个普通的家用游戏电脑就可以达到这个水平。 而这个水平,一周以前,只有5090,DGX spark,M3U这样的机器可以达到。 也就是说,在过去的一周多,全球的普通家用电脑带来了十倍于上周的AI产量。 这个增量,得益于deepseek- Qwen flash这种特殊设计,把智力分成了注意力,专家,和查表, 也得益于Strata这样优秀的架构,把整个处理流水线化,让不同的智力,存储在不同速度的存储设备中,在需要用时刚好抵达。 这对所有愿意拥有本地智力的人,当然是极大的利好。 也许模型层的设计,正在快速收敛到一个目前硬件条件下的最优解? 然而这对依赖出卖模型算力的生意,尤其是平庸的智力的商业来说,也可能是催命符。
Posts 1 Views 84.0KHeat 1.2K
#Claude#Codex#双Agent协同
近7日爆款推文

按近 7 日曝光排序,展示前 10 条。

1
1.7万 followers
Views8.4万
过去一周多,可能以后被证明是AI推理部署史上天翻地覆的一周。 上个周末,我的本地机双5070ti试跑Qwen Flash,只能做到200 prefill,10decode。 今天,在Strata和我自制的PR的支持下,目前可以跑到2200/67,而且只需要一张卡。 即读写速度都提高了近十倍。 更好的消费卡比如4090/5090,当然也有幅度相当大的升级(目前5090在流式处理的支持下,速度已经开始逼近RTX6000,当然显存还是不足)。 这当然带来了消费级硬件的新一轮大涨价。如今,就连曾经无人问津的 32G B70英特尔显卡都卖断货涨价了。 2200/67的速度是什么意思? 今天除了deepseek,muse等少数模型,大部分API达不到这个速度。 而一个普通的家用游戏电脑就可以达到这个水平。 而这个水平,一周以前,只有5090,DGX spark,M3U这样的机器可以达到。 也就是说,在过去的一周多,全球的普通家用电脑带来了十倍于上周的AI产量。 这个增量,得益于deepseek- Qwen flash这种特殊设计,把智力分成了注意力,专家,和查表, 也得益于Strata这样优秀的架构,把整个处理流水线化,让不同的智力,存储在不同速度的存储设备中,在需要用时刚好抵达。 这对所有愿意拥有本地智力的人,当然是极大的利好。 也许模型层的设计,正在快速收敛到一个目前硬件条件下的最优解? 然而这对依赖出卖模型算力的生意,尤其是平庸的智力的商业来说,也可能是催命符。
4
1.7万 followers
Views6.3K
单卡游戏电脑上最强的 Qwen3.8-Flash-Next runtime 是 Strata,实测推荐。 Strata 按专家被路由选中的频率(离线画像)给 24,576 个专家排序,最常用的放进显存。生成时没命中的,由 CPU 算一部分,其余经 PCIe 交给 GPU;读提示时则成批流式送进 GPU。 GPU 算热门,CPU 补冷门,快慢协同。 KV 也是流式的:只有 12 层稀疏注意力有 KV,每个 token 只读约 2K 个位置,所以完整 KV 放内存,显存只留工作集。 再加上 MTP 投机解码,16 GB 显存 + 64 GB 内存的游戏电脑就能流畅跑 Flash。