中文开发者分享AI编程与桌面软件操作的新实践,涉及Codex配合REA下载微信视频号视频、研究WorkBuddy读取微信聊天记录,以及Claude Code项目级记忆和Skill规则复用。宝玉称,视频下载需要多步对话,Codex最终通过配置本地代理完成;Andy Stewart自述使用REA配合算力舱研究聊天记录读取方式,但可见帖子没有呈现完整过程。Jason Young认为,项目记忆能够保留设计决策、开发红线和待修复问题,提高更换工具的成本;向阳乔木建议借鉴Skill中的验收、数据和画面控制规则。讨论延续智能体操作软件与开发工作流优化的脉络,但缺少兼容性、数据授权、稳定性及效率对照,不能据此确认普遍适用性。
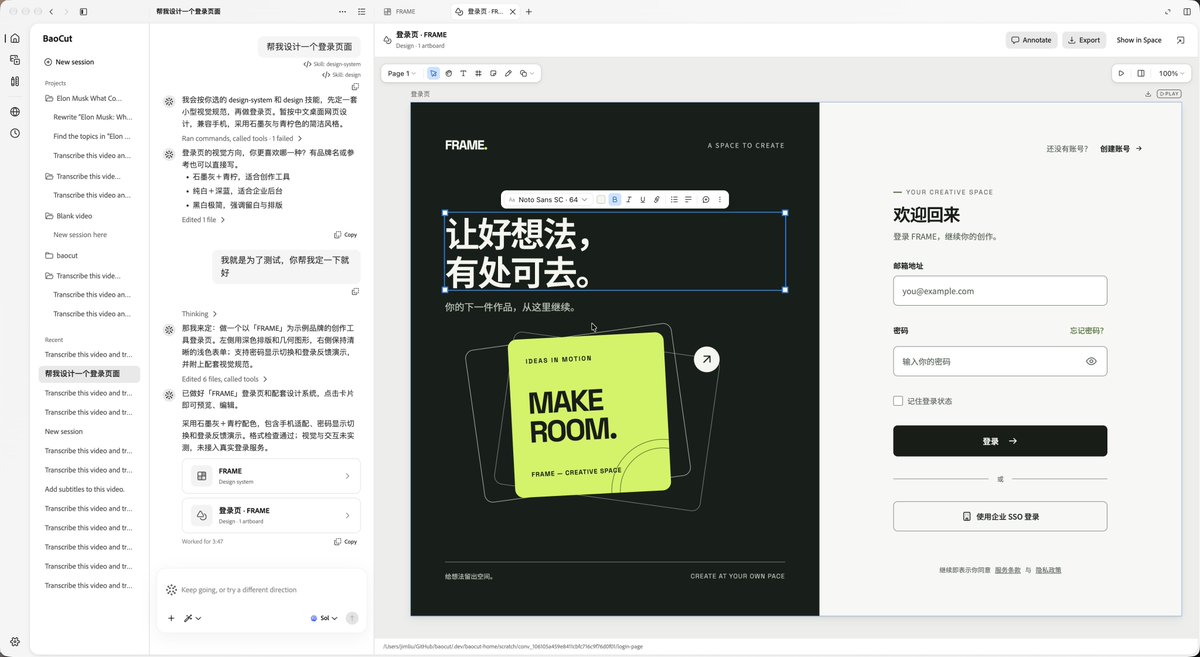
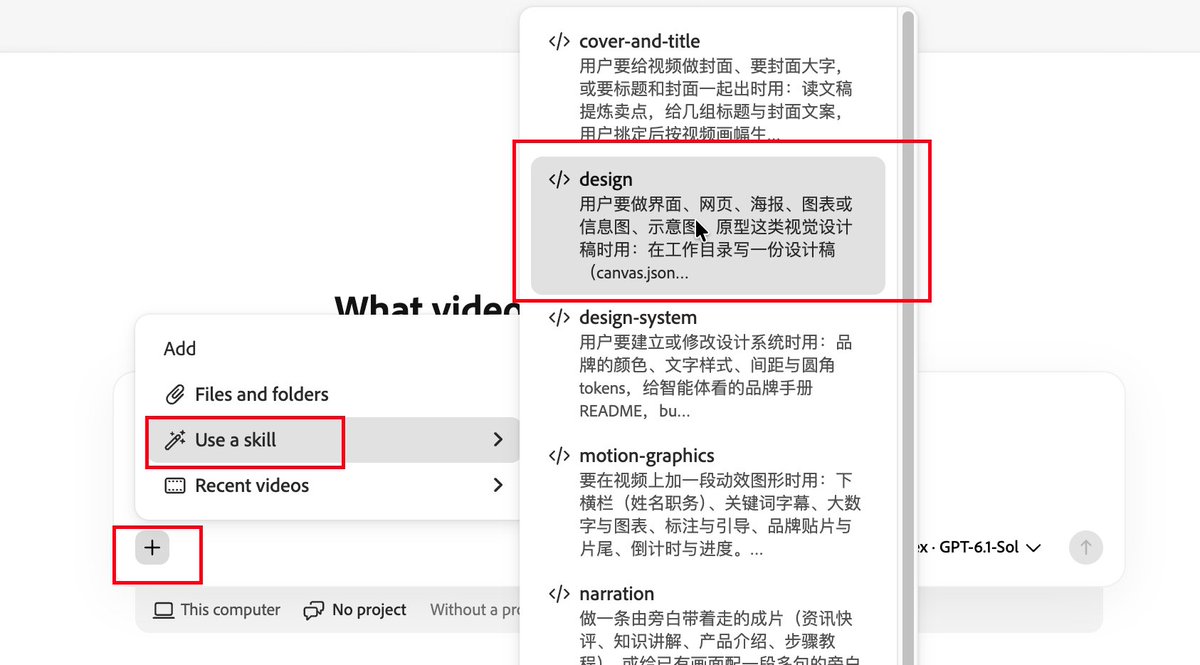
Participated post: 这两天逆向玩上瘾了,又逆向了最新的 Claude Design。没想到 GPT-6.1 Sol 接上 Claude Design (最新 Artifacts 里面那个版本)的 Skill 后,设计能力有很大提升,可能因为 Claude Design 会默认使用 Claude Design System Skill。
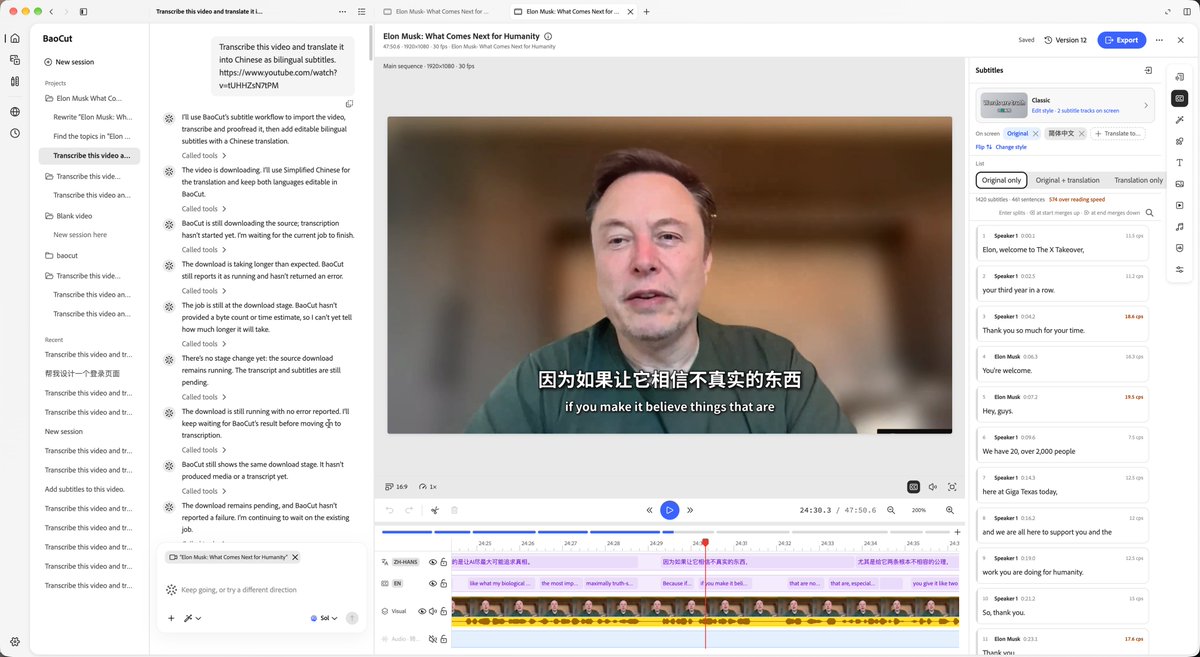
本来我做 BaoCut 只想做一个专注于视频剪辑的 Agent,结果把 Claude Slides 和 Claude Design 也给加进去了。
都说做产品经理克制很重要,但有时候好东西就忍不住加进去,知易行难,我还得继续修行。
理论上来说,可以把 Claude Design 和 Claude Slides 作为 Skill 的,但是没办法支持编辑修改和标记,所以先只是集成到 BaoCut 中。
当然 baocut 是开源的,skill 和前端代码你都看的到:
Design Skill 相关 commit:https://t.co/z7KXbLollt
如果你只是想试试,可以下载 baocut 或者本地运行,使用你本机 agent cli(比如 codex),会话的时候选一下 design skill。
当然 baocut 最强大的还是视频相关的功能,比如你可以用本地模型去转录,基于转录结果去翻译字幕,生成切片等等。
https://t.co/LRJH4rgT4f
#Codex #REA #微信自动化
OpenAI 围绕代码与大模型产品线展开高频迭代,开发者实测确认 GPT-6 Astra 与 6.1 Sol 的推理速度自 20 TPS 提升至 30 TPS,严格兑现了默认提速 50% 的性能承诺。与此同时,市场传出 OpenAI 正式上线月费高达 500 美元的高阶订阅套餐,引发用户对高算力模型定价溢价与实用价值的广泛讨论;此外,ChatGPT 宣布引入隐藏文本水印技术,通过特定词汇分布规则标记 AI 生成内容。虽然官方公布了水印原理,但社区认为简短对话即可规避检测,围绕大模型性能提升、商业收割与内容溯源展开多维博弈。
Participated post: 我记得半年前我说自己不怎么 Review PR 了,评论区很多人不认同,觉得这样不靠谱。现在再看,不 Review PR 的人越来越多。比如我刚看的这期播客,在 SpaceXAI 做 Grok Bot 的 Lauren Tan,一个月合并 2500 个 PR,也是不逐个 Review 的:晚上让 AI 自己检查、自己合并,第二天早上她再抽查。
不 Review 不等于不管质量,她靠另外两个办法来保证:
一是让 AI 能像真人用户一样把程序用一遍,自己发现问题;
二是给代码定下很多规矩,让 AI 很难写出烂代码。
她把自己这套做法写成了一组 Skill,公开了出来,叫 pstack。
顺便说一下,这期播客的主持人 Matt Pocock 原本是知名的编程课讲师,他公开的技能库在代码托管网站 GitHub 上有二十多万个星标,是最受欢迎的技能库之一,所以这期算是两位同行对谈。Lauren 之前在 Meta 做网页开发框架 React,今年 3 月加入 AI 编程工具公司 Cursor;Cursor 今年 8 月被 SpaceX 收购,并入旗下的 AI 部门 SpaceXAI。
根据播客的内容,我把 Lauren 的这套做法简单总结一下,我自己的点评在结尾处。
一、先让 AI 能检查自己干的活
Lauren 说,就算不用她的 pstack,每个人最该有的一项技能也是“验证”:给 AI “手和眼睛”,让它能把自己写的程序跑起来,像普通用户一样点一遍,看看结果对不对。
这是她吃过亏之后得出的结论。今年 4 月她在 Cursor 解决一个窗口卡顿的问题,一开始全靠手工:她自己去看各种性能数据,再把看到的转述给 AI,AI 改完她再去看。她形容自己成了 AI 和检测工具之间的“人肉中转站”。她在 Cursor 写的第一个技能就是验证。在这之前,AI 看不到自己改动的效果,只能等她来回传话;有了验证,AI 可以自己改、自己看结果、不满意再改,一轮一轮往下做,不需要她守着。现在她所在的团队里每个产品都配有这样的验证技能,全团队都在用。
做这个技能时她还总结出一条原则:工作里有的部分需要动脑判断,有的部分只是照章办事,照章办事的部分应该写成固定的程序,只把需要判断的留给 AI。起因是她发现,每个 AI 在检查前都要自己从头写一遍检查用的小程序,各写各的,有的能用有的不能用,用完就扔,又慢又浪费。她把这部分做成一个现成的工具,所有 AI 直接调用。
二、AI 反复犯的错,去改规矩,不去改 AI
Lauren 不喜欢“软件工厂”这个流行说法,她更愿意把自己的工作比作经营一家米其林餐厅的后厨。主厨不用亲手做每道菜,但要安排好整个厨房:食材什么时候进、怎么存,每个人用什么工具,菜按什么流程出。工程师现在也一样,不再亲手写代码,却仍然要对结果负责。她认为工程师现在最重要的工作就是把这个“厨房”布置好。没花时间布置的人,信不过 AI 的产出,只能盯着它一步步干,忙到没空改进工具,就像一直拿钝刀切菜。
她举了自己的例子。Grok Bot 最早几版的代码挤在八个巨大的文件里,每个至少一万行,AI 加新功能时就接着往里塞,越塞越乱。她后来定了规矩:每个功能必须放在自己单独的文件夹里,做一件事只允许一种写法,不合规矩的代码会被自动检查拦下来。这样 AI 加功能时不用多想,按规矩放就行。她的习惯是一直观察 AI 在哪里出错,每看到一次就问自己:能不能加一条规矩,让这种错以后根本写不出来。
不逐个检查,靠的也是这套办法。她说,开了几家餐厅的老板不可能尝每一道菜,只能抽查。她每天挑一些改动仔细看,如果只是偶然出错就算了;如果好几个 AI 都在走同一条捷径,说明该改的是规矩和工具。她的 pstack 里有一个全自动模式:每次改动都会派出一批专门负责检查的 AI,把程序打开到处点,找出问题就自己修,反复到没问题再合并。早上她翻一遍改动记录,发现不对就撤回,再补一条新规矩。
她说第一次让 AI 整夜自己合并代码时很害怕,担心半夜把线上产品弄坏,现在反而睡得更好。她也提醒,走到这一步很难,要花大量时间观察和调整,装上 pstack 并不能直接做到。Matt 问,如果改动是没法撤回的,比如会丢数据,或者是医疗、金融这类领域怎么办?她说这取决于工作成果能不能被程序自动检查,软件大部分可以,很难自动检查的领域就很难这样做,她自己也没有答案。
三、2500 次改动从哪来:她不再当传话的人
这 2500 次改动并不是她发起了 2500 次对话。用户反馈的问题散落在聊天工具、邮件和���交媒体上,以前要靠她自己去看,再转述给 AI。现在她让 Grok Bot 来盯这些渠道。Grok Bot 是 SpaceXAI 今年 8 月推出的产品,是能登录邮箱、聊天工具等各种应用、替人办事的 AI 智能体。它一发现新的问题反馈,就转给一个负责“协调”的 AI。这个协调者自己不写代码,只负责拆分任务、分派给其他 AI、盯进度,相当于她的后厨主管。
为什么不直接一个问题派一个 AI 去修?她说,一批反馈往往出自同一个根源,分开修会重复劳动,也看不出真正的毛病在哪,放在一起看才看得出来。她现在同时开着十多个这样的协调者,各管一摊。她一直在问自己一个问题:哪一步还卡在我身上,AI 为什么非得来问我?然后想办法教 AI 自己去拿到真实的信息。
她也说明,2500 次改动里新功能不占多数,很多是整理代码这类维护工作。
四、懂行的人更吃香,哪怕不会写代码
Matt 问,大家都靠 AI 了,专业知识是不是不值钱了?Lauren 的看法相反。模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。所以她认为,医生、律师这类在某个领域懂得很深的人,只要稍微懂一点技术、会用 AI 智能体,就能做出很好的产品。
两人都认为,技能没有什么神秘的,就是把自己的做事流程写成文字。Lauren 建议回头翻自己和 AI 的聊天记录,找出那些自己反复纠正、反复插手的地方,把它们写成技能或规矩。别人的技能可以拿来拼着用,但每个人最后都该有一套自己的,就像厨师换了餐厅也会带着自己的刀。
五、最后
很多人看完这期访谈会觉得,以后自己也可以像 Lauren 那样不 Review PR 了,装上她的 Skill,让模型帮忙验证一下就行。我自己现在的做法和她差不多,每天也有大量 PR,也不 Review。但我的建议是先别急着学她怎么做,先弄明白她凭什么能这么做。
1. 你能不能用上最好的模型,Token 够不够
在用上 Fable 和 Opus 5.5 之前,AI 写的代码我是不太放心的;用上之后,我才真的敢让 AI 去写而不怎么 Review。模型能力很重要,能力没到,就先别想这件事。
还有成本。像我这样没有大公司可以依靠的,得自己掏钱买 2 个 Claude Max 20x 账号,还得省着用。Lauren 在大公司,不用考虑 Token 消耗,全程用最好的模型、开最快的模式都没问题。
不过也别着急。Fable 这个级别的模型,也许半年以后就能像现在的 DeepSeek V4.1 Flash 一样便宜,人人用得起。梁圣加油。
2. 不能��全依赖 AI 的验证
哪怕现在 GPT-6 操作电脑的水平已经超过真人了,让它去做验证,也只能替代一部分,不能真的全交给它,自己还是要看。
可以做的是把那些手动重复做的事情,一点点沉淀成 Skill 和自动化脚本,把体力活解放出去���
3. 方向得靠你自己的专业来指
再聪明的 AI,也没办法替你决定该往哪个方向走。就像给车子装上火箭发动机,也得你来告诉它往哪开,走偏了要及时调整,不然跑得再快也是南辕北辙。
做软件也一样。你不能指望一句提示词做出一个淘宝。你得先做一个能发商品、能浏览的小网站,再加上用户注册,还得区分买家和卖家,然后是支付和安全,功能做完了还要扛得住很多人同时用。稍微复杂一点的软件,都没法完全依赖 AI,要人去拆解、规划,分成一个个小版本、小里程碑,做完要验证,出现偏差要重新指方向。甚至做着做着,你自己的想法都变了,AI 不可能知道你真正想要的是什么。
所以就像播客里说的:模型越来越强,卡住人的已经变成你能不能把自己想要什么讲清楚。
4. 不一定要用他们的 Skill,但要学着把事情交给 Agent 去做
Matt 和 Lauren 的 Skill 都很受欢迎,但你不一定要用。
一方面,软件工程的基础知识,现在的模型已经学得很好了。Lauren 在播客里也说,去年的 Skill 还得写清楚具体该敲哪条命令,现在这些都可以删掉,只留流程步骤,Skill 会越写越短。
另一方面,他们的开发流程和环境,跟你的很可能不一样。Lauren 的 Skill 都是从她自己的工作里总结出来的:验证技能来自她当“人肉中转站”的那段日子;另一个叫 recall 的技能,来自她每次开新对话,都得把上一个对话里的背景再讲一遍。
所以更重要的是从你自己每天的开发流程出发。那些还要你手动操作的环节,尽可能���给 Agent 去做;Agent 做顺了,再把它的操作过程沉淀成 Skill,反复迭代优化。
如果不知道从哪里下手的话,可以参考 Lauren 的办法:翻自己和 AI 的聊天记录,找那些你反复纠正、反复插手的地方。这样迭代出来的 Skill 才真正适合你,用她的话说,每个厨师都该有一套自己的刀。
#OpenAI #ChatGPT #推理提速
OpenAI在开发者大会发布个人AI助手Dot后正式开放网页端体验,并同步将Codex客户端资料库重构为全新的Space功能,加速推进云端Personal Agent生态落地。实测反馈显示,Dot支持自定义配置并与桌面代码环境联动,但其在Codex内的创建引导与跨端同步体验仍显割裂。与此同时,科技圈发现顶级域名dot.com已被马斯克买下并定向跳转至旗下Grok Bot下载页,引发巨头抢夺下一代智能体流量入口的戏谑与博弈。行业观察指出,随着Meta推出Muse、Manus推出Cue以及OpenAI推出Dot,2026年云端个人智能体赛道正进入大厂全面卡位的新周期。
Participated post: 2026 年 9 月 29 日,OpenAI 在旧金山 Fort Mason 办了今年的开发者大会 DevDay。主讲是 CEO Sam Altman。其他几位上台的人都在做这些产品。产品团队的 Holly 演示了新产品 Dots。后训练(模型预训练之后做对齐和能力调优的阶段)研究负责人 Tejal 讲了模型怎么反过来帮 OpenAI 做研究。Codex 的演示由 Romain Huet 来做,他在 OpenAI 负责开发者体验,去年 DevDay 主题演讲里的 Codex 演示也是他做的。整场演讲分三块:面向用户的常驻智能体 Dots 和协作空间 ChatGPT Space,给开发者的新模型和新工具,以及帮开发者做分发、赚钱的渠道。
1. Dots:一直在线、会主动干活的智能体
Sam 把 Dots 比作电影里那种一直在身边帮忙的 AI 助手。他认为订餐厅、买机票这类代办虽然有用,但和这项技术能做的事比起来太小了。他想要的 AI 知道正在发生什么,也知道你在意什么,不用你事事交代。
Dots 是常驻在线的智能体(Agent),有自己的云端电脑和浏览器,能写代码、跑测试。它的权限跟着用户走,能直接用用户已经在 ChatGPT 里连好的插件,覆盖 4000 多个应用。除了在 ChatGPT 里对话,之后还可以给它发短信、打电话。目前每人先有一个 Dot,以后可以配一整组。Dots 跑在 本月早些时候发布的 GPT-6 Astra 上,Sam 称它是 OpenAI 对齐做得最好的模型。用户可以限定 Dot 能用哪些应用、能不能操作电脑,也能给它的各类操作写自定义指令,愿意交出多少责任就放多少权。
Sam 说,他自己的 Dot 每天早上会把夜里进来的消息过一遍,挑出紧急的提醒他。他说这让他拿回了一部分注意力,没那么离不开手机了。他还举了一个更重的例子:把应用从一个即将停用的旧 API 上迁走。这个 API 可能散落在代码库各处,改了哪里会连带弄坏什么,事先看不出来。Dot 可以追踪依赖关系,找出所有要改的地方,写代码、跑测试,最后把 PR(代码合并请求)交给团队审。他让听众想想,过去做这件事要几个人、花多久。
开场视频里,用户把自己的 Dot 改名叫 Alfred。Alfred 和另一个 Dot 帮用户上线���站,改董事会材料,在婚礼蛋糕商家取消后找好备选。它们还发现财务会和女儿的演出撞了期,提出改时间。每件事都是 Dot 推进到需要人确认的地方,再由人拍板。
2. ChatGPT Space:人和智能体一起用的工作区
Sam 认为,现有的生产力软件几乎都没考虑过人和 AI 一起干活。ChatGPT Space 以页面为单位,可以在里面写计划、做调研、生成图片和数据。页面和文件像网盘一样放在同一个空间里。Dot 能直接在页面上工作,在评论里 @ 它,它就会接活。页面本身也能带指令,比如“每天去看 API 平台的 Slack 频道,把发现更新到这里”。之后 Space 里还会加入演示文稿,格式做成智能体方便读写的样子,团队成员可以和各自的 Dot 一起改。
在 Holly 的演示里,页面用斜杠命令就能插入交互图表、表格和可运行的原型。她 @ 自己的 Dot(名叫 Dotty),让它把一组数据改成柱状图。图表可以按反馈类型筛选,Dotty 每小时刷新一次。她还让 Dotty 把“某位工程师在我 Slack 私信里提过的新手引导数据”补进 FAQ。Dotty 能看到她的上下文,所以这种模糊的指代也找得到。
3. OpenAI 内部怎么用 Dots
Holly 用一个虚构的歌单应用 Blossom Music,模拟发布前一天的状况。早上 Dotty 已经做了几件事:发现发布评审会提前,改好了日历;看完前一晚测试用户的反馈;注意到设计团队临时改了首页,把新设计发给她。她让 Dotty 直接把这个设计做出来。Dotty 调用她笔记本上的 Codex 构建应用,在 iPhone 模拟器里跑起来,再提交 PR。现场的语音演示卡住了,Dotty 一直回复“还在查”。Codex 线程也报过一次错,她重试后才继续下去。
她说,Dots 真正改变 OpenAI 工作方式的地方在 Slack。Dots 在公司 Slack 里有自己的身份,员工就开始把它们当作代理人。被同事 @ 到的零碎请求,直接转给自己的 Dot 处理。建群时,大家从一开始就把各自的 Dot 拉进来,Dot 带回结果时所有人都能看到。
工程师走得更远。有人在反馈频道贴出会话 ID 和一个用户 bug,某位工程师的 Dot 就会接手排查,提 PR 修复。她说这是真实情况:工程师们的 Dots 每天这样修掉几十个 bug,Dots 这个产品本身有很多部分就是 Dots 写的。
4. 上线范围和企业用的 Specialist Dots
Dots 和 Space 当天向 ChatGPT Pro、Business Premium 和 Enterprise 用户开放。Dot 包含在套餐里,和它的对话不占用额度。
企业客户还可以预览 Specialist Dots。这是由公司统一设置、供整个团队使用的虚拟同事,负责会计、市场、法务这类工作量大的事。公司给它目标和背景,审核它的产出,给它反馈,反馈在全公司共享。OpenAI 也在和微软合作,把 Specialist Dots 接入 Agent 365(微软用来管理企业智能体的工具),企业可以用已经在用的微软工具来管理它们。
5. 新模型:更便宜的 GPT-6.1 Sol,更快的 UltraFast
Astra 发布这几周,用户的要求集中在两点:更便宜,更快。GPT-6.1 Sol(转录稿误作 Soul)的能力接近 Astra,价格是它的五分之一。缓存输入(重复发送、已被缓存的上下文)比标准输入便宜 95%。智能体需要反复读同一批上下文、长时间迭代,这对它们尤其省钱。Sam 说 Sol 在某些方面比 Astra 还聪明,定位是开发者的日常主力模型。
UltraFast 是新的速度档,API、ChatGPT 和 Codex 里都能用。原有的 Fast 档是两倍速度、两倍价格;UltraFast 是八倍速度、六倍价格,每秒 300 个 Token。它现在可以配合 Astra 用,之后也会支持 Sol。现场让两个模型用同一个提示词,做一个 DevDay 配色的火箭。UltraFast 的火箭已经升空时,标准速度的还没做完。
订阅也跟着调整。新推出的 500 美元档 Pro 订阅叫 Pro 500,额度最高,是 Plus 的 25 倍。它可以在 ChatGPT 和 Codex 里用 UltraFast,还能通过“用 ChatGPT 登录”在合作方的应用里使用。Pro 200 重新开放,继续提供所有前沿模型。
另外预览了 Decisions API。它给 Luna 模型一组预先定义好的选项,让模型从中选一个,比如给请求分流、给图片分类、决定智能体下一步做什么。任务收窄成选择题之后,响应时间可以压到一秒以内,同时保留图像理解、多语言和安全防护。Romain 后来补充说,做机器人的朋友看中的是它能处理视觉输入:机器人可以根据看到的东西,近乎实时地快速行动。
6. 模型开始帮 OpenAI 做研究
Sam 提到,去年这个时候,他和 Jakob 在一次直播里预测,一年内会出现第一个“AI 研究实习生”,当时几乎没人相信。几周前 OpenAI 宣布达成了这个目标:有了一个能接手定义清晰的研究任务的系统,这类任务原本要熟练的研究员花大量时间和精力。
Tejal 的方向是电脑操作(computer use,让模型像人一样操作桌面和浏览器)。她举了两个例子。
第一个是让模型优化电脑操作的运行框架(harness,包在模型外面、负责调用工具和管理步骤的代码)。模型在循环里持续寻找能同时降低延迟、提升效果的改动,团队把找到的改进合进生产环境的框架,并用于后训练。结果是延迟改善了两倍以上,已经上线。
第二个是模型帮忙改进了监控和拒绝训练,让 Astra 在不安全的场景里更会拒绝。Astra 在电脑操作压力测试上因此达到业内领先,操作时出错更少,也更贴合用户的本意。
她给出了几项内部数据。今年夏天之后,研究工作消耗的 Token 量急剧上升。1 月时,模型能做好 15 分钟以内的短任务,需要一天以上的任务大多会失败;到 7 月,超过三分之一的一天量级研究任务,模型能在无人干预下完成。她还提到,Astra 这类模型已经帮忙解决了 100 多个悬而未决几十年的数学问题,也在参与针对耐药感染的新抗生素、古代语言研究、可再生能源和工业机器人等方向的工作。
7. 给开发者的底层工具
Sam 说,OpenAI 想让开发者用上自己内部用的东西。
第一件是 Codex 的运行框架。它同时支撑着 Codex、ChatGPT Work 和 Dots,目标是用最少的 Token、最快拿到准确结果,现在已经开源。第二件是 Codex 完全上云:在手机上开始的任务,可以在浏览器或桌面端接着做,合上笔记本任务也不会中断。
云端能力带来了 Codex Security Cloud。它在��端环境里持续寻找漏洞,并准备好验证过的修复方案供人审核,这次新增了自动去重、定时扫描和新界面。Sam 说这是为了给防守方更好的工具,因为“我们看得到接下来会发生什么”。
新的 Agents API 进入公开测试。它包含运行框架、托管、记忆、多智能体控制等功能,是 Codex 和 Dots 用的同一套技术,也加入了电脑操作能力。现场的例子是一个网站测试智能体,会自己打开浏览器、点击页面、测试流程。基础设施方面,OpenAI 和 AWS 合作推出由 OpenAI 驱动的 Bedrock(AWS 的托管 AI 服务)托管智能体,AWS 客户可以直接使用 OpenAI 的前沿模型、Codex 和 ChatGPT Work。
隐私方面预览了 OpenAI Private Intelligence。其中的零数据留存(ZDR)配合私有安全处理,可以在不把用户内容存到 OpenAI 服务器的情况下做安全检测;私有推理则把隐私保护延伸到推理阶段。Sam 说这套方案是和最大的一批客户一起设计的,目的是让他们能把模型用在最敏感的工作上。
性能方面,Responses API 一年里增长了 100 倍,可靠性保持在 99% 以上。首个 Token 的等待时间缩短了 45%,工具调用和工作流提速 30% 以上。
8. Romain 的 Codex 演示
演示从手机上的 Codex 开始。Romain 人还在会场外,让 Codex 替他跟观众打招呼、讲一个会场的冷知识。接着他用几张会场照片生成的 3D 场景演示 UltraFast,一边说一边改:把小人放到座位上,把直播画面投到场景里的大屏幕上。现场语音没连上,他改成了打字。
Codex 命令行工具(CLI)这次全面翻新。他让 UltraFast 写一个应用,从观众里随机抽三个人送明年的门票,几秒就写完;改成抽六个人,也几乎是瞬间完成。命令行现在支持由 GPT Live 驱动的双向实时语音,不只是语音转文字,但现场没能演示出来。
后面几段演示了多模态和电脑操作。游戏 Astra Adventures 从一张纸上的草图开始,几轮之后画面还很粗糙,借助图像模型,才变成有质感、能用在正式游戏里的美术。然后他让 Astra 通过浏览器自己学着玩这个游戏,屏幕左边显示模型的决策,右边显示它按下的按键。
他又用“应用快照”(app shot)把自己记录飞行课程的应用作为上下文交给 Codex,让它在各种屏幕尺寸下审查这个应用并截图。Codex 自己在模拟器里点开了各项功能。云端 Codex 现在和本地版用同样的工具,包括插件和电脑操作。他顺手把一个“用 Rust 重写整个后端”的任务丢到云端,打算稍后在手机上查看。
最后一个演示用的是 Hugging Face 借来的可编程小机器人 Micro Duck,它名叫 Lavender。Romain 前一晚让 Codex 把它接好:视觉用 Astra,图像生成用 GPT Image 2.5,语音交互用 GPT Live 1。机器人现场看着观众画了一幅画。他说,OpenAI 做 Dots 和 Codex 用的,就是 API 里开放给开发者的同一批工具。
9. 分发和变现:让开发者在 ChatGPT 上做生意
ChatGPT 每周大约有 12 亿人使用。Sam 承认,此前类似的尝试效果参差不齐。他说这次有信心,是因为开发者拿到的是 OpenAI 自己做 ChatGPT 用的工具。
第一项是“用 ChatGPT 登录”(Sign in with ChatGPT)。用户登录第三方应用时,可以直接用自己 ChatGPT 套餐里包含的 Token,开发者不必替新用户垫付模型费用。首批有 16 家合作方。
第二项是插件扩展(plugin extensions)。开发者可以把编辑器、仪表盘乃至整个工作区,做成原生嵌在 ChatGPT 和 Codex 里的应用。现场展示了三个例子。一个是会议应用:在 ChatGPT 里看日历上的会议,点“记笔记”后,页面变成团队和 Dots 一起跟进待办的 Space。一个是 Figma:打开设计稿、看团队评论、让 ChatGPT 改稿。还有一个是 Adobe:在 ChatGPT 里使用 Photoshop 的功能。ChatGPT sites(在 ChatGPT 里生成的网站,几个月里已有数百万个)现在也能接入插件和数据。访客用自己的账号登录、带上自己的智能体,看到的内容因人而异。
用户发现插件的渠道也扩大了。除了在插件库里搜索,ChatGPT 还会在对话中识别出能帮上忙的插件,用户当场就能连接。插件审核流程也简化了:开发者可以跟踪审核进度,看到需要修改的地方,申请人工复审,更新工具时也不用从���提交。
第三项是 OpenAI Marketplace,首批有 30 多家合作方,包括 CodeRabbit、Notion、Vercel。企业客户可以用已经和 OpenAI 签下的采购承诺额度来买这些产品,有承诺额度的开发者也能在这里花。通过和模型推理托管公司 Baseten(转录稿写作 Base10)合作,市场里还能用到开源模型。
10. 收尾:一次额度重置,和“文艺复兴”的说法
当天的后续安排里,Peter 会讲 OpenAI 对开源社区的投入,包括新的 OpenClaw Enterprise Harness(OpenClaw 是一个开源 AI 智能体项目)。还有一个 Codex 游戏工作室环节,观众可以用 Codex 做复古游戏,每人能领一台 DevDay 限定的 chromatic computer,用来玩自己做的游戏。最后是 Sam、Tibo (Thibault) 和 Tejal 的现场问答。
Sam 和 Tibo 还在台上按下按钮,给全世界的用户重置了一次用量额度。Sam 说 OpenAI 已经做过太多次重置,Tibo 一直想把公司改名叫“重置公司”。
最后 Sam 说,他不喜欢把 AI 比作新一轮工业革命,那意味着人变成巨大机器里的齿轮,转得越来越快;生活里有些部分不能也不该被自动化。他希望,如果做对了,AI 带来的会更像一场新的文艺复兴:让人对自己的生活有更多掌控,有更多工具去创造、学习和探索。
#OpenAI Dot #Codex #Personal Agent
中文 X 创作者继续围绕 AI 写作去味、Skill 工具和 Agent 课程分享形成高收藏讨论。余温称写作时只加入“禁止使用状语”就能明显减少 AI 味并提升小说质感,铁锤人随后转述类似体验;Viking 分享 show-me Skill,强调让 AI 用最小图示解释技术问题,而不是堆砌长段文字;G哥则分享开源 AI Agent 课程,并称可替代某些付费课程。讨论显示用户关注点正从单条 Prompt 转向可复用工作流、图解能力和系统化学习资源。
Participated post: 怎么感觉 Anthropic 和 OpenAI 对调了😂
OpenAI 宣布断供 Cursor 后不到两小时,Anthropic 联合创始人、首席算力官(Chief Compute Officer)Tom Brown 在 X 上回应:Cursor 从 2024 年的 Sonnet 3.5 时代起就是 Anthropic 信任的合作伙伴,Anthropic 会继续增加算力支持 Cursor 里的 Claude 模型,也期待 Cursor 在 SpaceX 的下一步。
#AI写作 #去AI味 #提示词
中文X用户分享通过Microsoft Word使用Claude的体验,并讨论低价购买渠道与AI代充成本。实践哥Li称,Microsoft 365 Copilot已接入其所称的Claude Opus 5.5,自己在Word中试用成功,并将这一入口描述为不用担心封号的替代方案。雨哥向前冲则推荐在闲鱼购买17元的相关服务,但没有说明套餐、期限或授权方式。布丁另比较向上家拿货与自行处理支付的代充模式,列出不同成本及支付失败风险。这组讨论延续AI工具接入与使用门槛的脉络,但候选材料未附官方模型说明、完整订阅条件或支付记录,不能确认模型版本、不封号承诺及报价的适用范围,也不能认定三帖对应同一种服务。
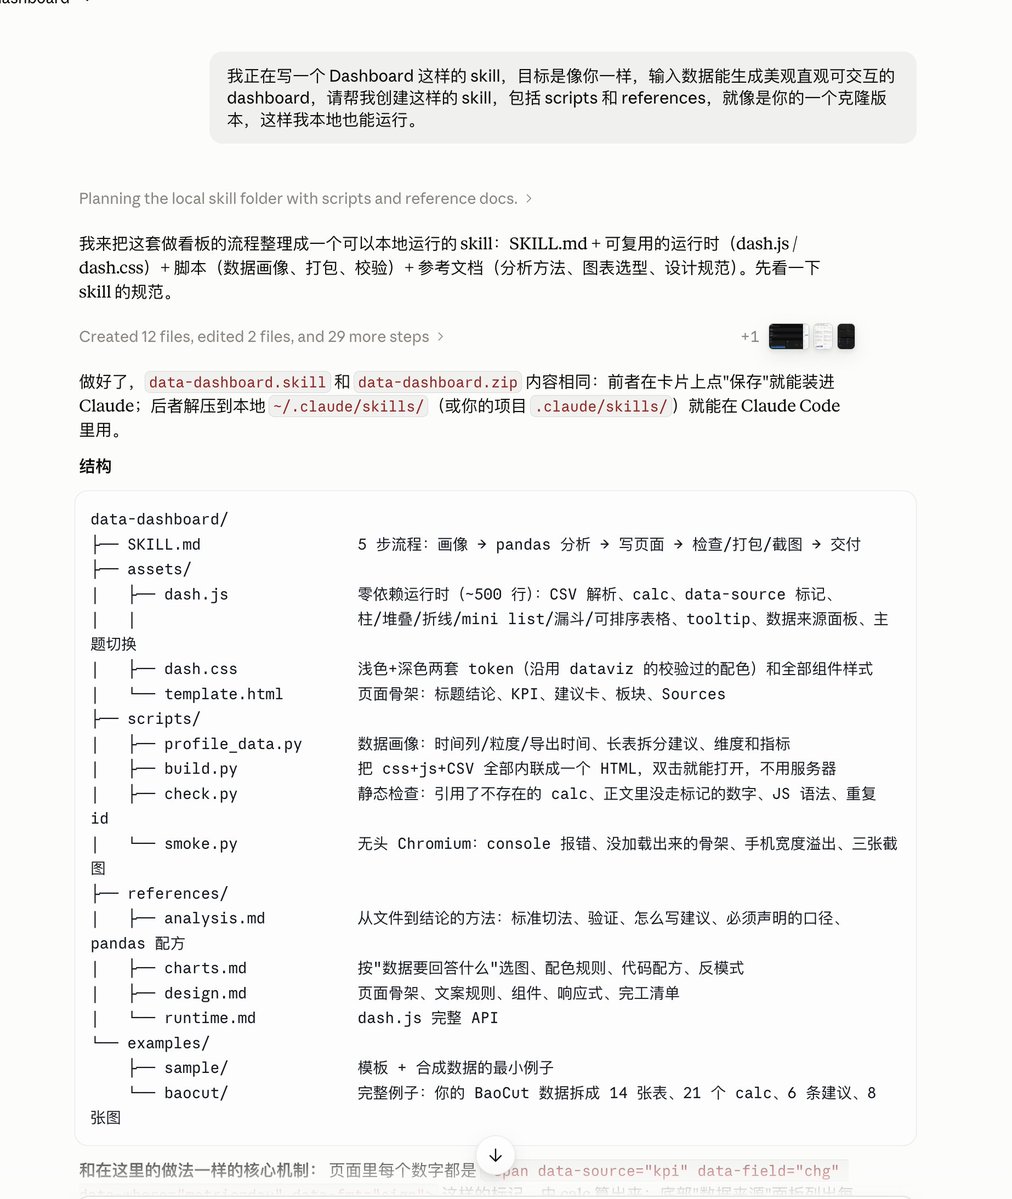
Participated post: 用 REA 小试牛刀逆向了 Claude Slides 的 Slides 编辑器,几乎完整功能。(图1)
我的用法很简单,不一定是最佳实践,仅供参考:
1. 先去 Claude Slides 上把核心的脚本和样式表下载下来(图2)
2. 按照 REA 官网的说明让 Codex 安装 REA
3. 使用 REA Skill 去逆向混淆后的代码(图3)
4. 用不了太久就能有一个目录结构不错的代码,但其实里面还挺乱的
5. 然后再用 Claude Code 5.5 去重写了一遍就变成结构良好类型完整的代码了
至于提示词,我没有直接逆向,而是换了个思路,先做个 Slides,然后在对话里面,说我要做一个 slides skill,让它帮我实现一个,要做的跟它的一样好,这样子出来的提示词,和原始的提示词肯定不一样,但是做出来的效果没什么差别。(图4是我用同样方法问 Claude Dashboard 的提示词)
完整的代码参考:https://t.co/I25w0FGgkV
#Claude #Microsoft Word #Microsoft 365 Copilot
中文开发者分享Muse与Grokbot接入本地模型的方案,将个人智能体讨论从跨环境协作延伸至持续运行成本。实践哥Li称,有显卡的用户可通过Tailscale组网,让Muse连接本地Qwen 3.8 Next Flash,并以“5毛钱电费”和“无限token”描述使用体验;可见教程在登录步骤处截断。Lonely随后转发“Muse无限token 2.0”方案,强化本地显卡运行的传播。Go学长则提醒,连Muse都无法注册的网络环境,不宜贸然购买Claude服务。讨论呈现本地推理降低云端额度依赖的期待,也涉及网络可达性门槛,但候选材料没有提供硬件配置、耗电周期或稳定性测试,不能确认所述成本及全天候运行效果。
Participated post: OpenAI 一次性公开 722 篇 AI 写的数学论文
OpenAI 把一个内部未发布模型做出的数学成果整体公开了:722 篇论文,归成 372 组结果,全部放在 GitHub 仓库 openai/math 里,谁都能看。
这个模型就是上个月宣称解决了纳维-斯托克斯方程问题(千禧年七大数学难题之一)的那个。它从 8 月 28 日开始训练,能力比 OpenAI 已发布的 GPT-6 Astra 更强,目前还没对外开放。
OpenAI 说,原有的数学测试题已经难不住模型了,所以改拿真实的未解数学问题来考它。前后一共给了模型大约 4000 道题,筛掉分量不够的,剩下这 372 组。平均每个结果花的算力,相当于在 ChatGPT Pro 里思考三个小时左右。
论文覆盖数论、代数几何、组合、数学物理等大部分数学分支。标题里能看到不少有名的问题,比如证明 π 的无理性测度(衡量一个数能被分数逼近得多好)等于 2,证明卡塔兰常数是无理数,还有黎曼 ζ 函数零点分布、特殊情形下的霍奇猜想。后两项 OpenAI 特别说明,用的流程和其他结果不同,其中黎曼 ζ 那篇的文字还经过人工润色。
这些结论可信吗?OpenAI 自己的说法是“处在不同验证阶段”。约 160 篇的主要结论附带了 Lean 形式化证明。Lean 是一种能让计算机逐步检查数学证明的编程语言,过得了 Lean,基本可以排除证明里的逻辑漏洞。剩下的论文还没形式化,OpenAI 承认其中可能有错,说会尽快修正,所有修订都保留历史版本。另外还附了 10 份模型推理过程的摘要,让人能看到模型是怎么想出来的。
发布方式本身也是这次的重点。9 月下旬,OpenAI 在普林斯顿高等研究院(爱因斯坦待过的那个研究所)支持成立了独立的“数学与人工智能顾问组”,成员是 Timothy Gowers、Edward Witten、Martin Hairer 等 9 位数学家,不拿 OpenAI 的钱。此前 25 位菲尔兹奖得主联名发公开信,批评 AI 公司抢着宣布破解名题的做法。
顾问组 9 月 29 日发布了一份建议,征集了 600 多位数学家的意见。核心要求有三条:AI 写的证明要按正规论文格式重写,并引用相关的已有文献;成果要放进不受 AI 公司控制、可长期引用的学术存档平台;AI 公司要出钱支持数学界去真正理解这些成果。顾问组还明确表示,不赞成 AI 公司在外界用不到的私有模型上攻数学难题,希望它们停下来。
OpenAI 这次回应了其中一部分:先放 GitHub,同时在找符合顾问组标准的社区托管平台;承诺资助一系列研讨会、学术会议,帮数学界消化这批成果;也表示正在推进“负责任地发布”这个模型。至于停止在私有模型上测试,OpenAI 没有回应。
对数学专业的人来说,接下来最实际的变化是:自己研究方向上的某个猜想,可能已经在这 722 篇论文里了,值得去仓库里翻一翻。
原文:https://t.co/uAxjHXhNeK
仓库:https://t.co/aPgNSqXevr
#Muse #Grokbot #本地模型
半导体巨头AMD宣布以约82亿美元全股票收购斯坦福大学李飞飞教授创立的空间智能公司World Labs,李飞飞随后出任AMD执行副总裁兼首席科学家,相关交易在科技界持续引发多空交锋。部分分析人士认为该交易展示了AI由传统语言大模型迈向物理空间对话与具身智能的新路径,对AMD抗衡英伟达生态具有战略意义;但中文技术社群亦出现激烈质疑,部分观点将该笔两年内完成的天价并购指责为学术圈资本运作与高溢价泡沫,对李飞飞担任首席科学家能否实质提振AMD研发能力提出严厉拷问。
Participated post: AMD 以 82 亿美元收购李飞飞的 World Labs
AMD 宣布以 82 亿美元收购 AI 创业公司 World Labs。交易完成后,World Labs 创始人李飞飞将加入 AMD,担任执行副总裁兼首席科学家。
李飞飞是斯坦福大学计算机科学教授。她主导搭建的 ImageNet 图片数据库,以及由它催生的图像识别竞赛,推动了计算机视觉(让 AI 看懂图像的技术)的突破。2024 年她创办 World Labs,专门做“世界模型”。她认为,AI 只靠读文字成不了真正的通用智能,还得理解物理世界:物体在哪里、空间怎么排布、东西怎么运动。
“世界模型”目前没有统一定义。从能看懂图像的语言模型,到能生成并持续运行一个逼真虚拟环境的模型,都有人叫它世界模型。World Labs 的第一款产��� Marble 属于后一类,输入文字或图片,就能生成一个可以在里面走动查看的 3D 场景。官方给它定了两个用途:做娱乐内容,以及给机器人搭建训练用的虚拟环境。
AMD 为什么要买一家做模型的公司?在 AI 芯片市场,AMD 的主要对手英伟达除了卖芯片,还提供配套的软件和模型。以世界模型为例,英伟达已经推出了 Cosmos 系列开放权重模型(任何人都能下载、自己部署),开发者买英伟达的芯片,顺手就能用上这些工具。AMD 公开发布过的只有文本和视频模型。买下 World Labs,AMD 就能补上这块短板,用 AMD 显卡的开发者以后也更有可能拿到针对自家硬件优化过的世界模型。
AMD 还表示,搞清楚最前沿的 AI 模型怎么跑,会直接影响它下一代芯片怎么设计。World Labs 的说法是,现在做 AI,模型研究、系统和算力三方面必须紧密配合。李飞飞在宣布交易的文章里写道,团队已经拿出了实际成果,接下来要扩大规模、覆盖更多人,也要离硬件更近。
两家公司早有合作。去年双方在模型训练和推理优化(让模型跑得更快、更省资源)上建立了合作关系;今年初 AMD 在 CES 的发布会上,李飞飞也作为嘉宾到场。
世界模型受重视,主要是因为机器人缺训练数据。大语言模型可以拿互联网上的海量文字来学,机器人要学的是在真实环境里怎么动、怎么操作,这类数据很少,采集成本也高。世界模型能批量生成逼真的虚拟场景,让机器人在里面练,这样产出的数据叫“合成数据”。自动驾驶汽车、工厂机器人,以及特斯拉、Figure 在做的通用人形机器人,都要靠这类数据。
这笔交易还需要监管部门批准,预计今年年底前完成。
#AMD #李飞飞 #World Labs
Anthropic 正式推出极致低价的小模型 Claude Haiku 5.5,引发人工智能行业与资本市场的强烈连锁反应。受每百万输入Token仅0.1美元等极具杀伤力的定价冲击,港股大模型概念股遭遇重挫,MiniMax跌超9%至12%,智谱亦下跌超6%,市场认为其彻底击穿了依赖低价模型的厂商叙事。与此同时,官方针对高阶用户赠送的200美元API额度在开发者社区引发了风控担忧,有长期正常使用的老用户反馈领取额度后账号迅速遭遇封禁,促使开发者怀疑赠额背后存在更严苛的合规风控机制。
Participated post: Anthropic 发布 Claude Haiku 5.5:小模型价格降到上一代的十分之一
Anthropic 今天发布了 Claude Haiku 5.5。Haiku 是 Claude 家族里最小、最便宜的一档,排在 Sonnet 和 Opus 之下,主要用来跑量大、对成本敏感的任务。
这次最大的变化是价格。处理 10 万 Token 以内的请求,Haiku 5.5 每百万 Token 输入 0.1 美元、输出 0.5 美元,比 Haiku 4.5 便宜 90%。超过 10 万 Token 的长请求是 0.5 和 2.5 美元,便宜一半。上一代 Haiku 收到的请求里约 90% 都在 10 万 Token 以内,所以按官方估算,平均运行成本降了约 75%。
10 万 Token 大约是一本中篇小说的长度,客服对话、文档摘要、分类打标这类日常任务,基本都在这个范围里。
价格降了,能力也上来了。官方公布的测试里,操作电脑完成多步骤任务(OSWorld 2.1)的成绩从 Haiku 4.5 的 15.7% 涨到 72.4%;在命令行里自主完成编程任务(Terminal-Bench 4.0)从 0 涨到 39.2%。Anthropic 说它是目前速度最快的模型(Opus 开快速模式除外),Asana 实测任务完成延迟降低了 30% 以上。
官方推荐的用法有两类。一类是批量的重复活,比如摘要、分类、数据库查询,以及实时客服、浏览器自动操作这种要求响应快的场景。另一类是给大模型打下手:写代码时让 Opus 5.5 或 Sonnet 5.5 当主力,把零碎的子任务分给 Haiku 5.5 去做,也就是当子智能体。
Haiku 5.5 也是第一个能调节“投入力度”(effort)的 Haiku 模型,从低到最高分五档。简单任务开低档省钱,难的任务开高档换效果,开发者可以按任务选。
Haiku 5.5 今天起在 Claude API 以及亚马逊 AWS、谷歌云、微软 Azure 上可用,模型名 claude-haiku-5-5。
同时宣布的还有两件事。
Sonnet 5.5 读取缓存的价格减半,降到每百万 Token 0.1 美元。缓存就是把反复用到的内容(比如很长的系统提示词、整个代码库)存起来,下次直接读取,不用重新算。智能体任务里这部分开销占大头,官方估算这次降价让 Sonnet 5.5 跑大多数智能体任务便宜约 20%。
本周起,Max 和 Team 订阅用户每月会拿到一笔 API 额度:Max 5x 送 100 美元,Max 20x 送 200 美元,Team 最多 500 美元,团队成员共用。
#Claude #Haiku 5.5 #Anthropic
在特朗普于白宫力推“超级智能”(SI)倡议并签署巨头合作备忘录后,相关叙事迅速向资本炒作与行业立法垄断争议蔓延。马斯克宣布计划将旗下 AI 业务整合更名为 SpaceX SI,特朗普亦拟筹建超级智能部队,直接引爆了以“.si”为后缀的国家顶级域名的投机狂潮,部分意向转让标价甚至飙升至近70万美元;与此同时,财经与科技观察人士尖锐抨击山姆·奥特曼与达利奥等头部巨头以“AI毁灭人类”为名煽动末日恐慌,质疑其试图绑架美国政府立法建立准入壁垒以实现大模型垄断。事件反映出超级智能叙事正从最初的政商作秀演变为寡头合谋与投机资本跟风的新战场。
Participated post: Anthropic、Meta、Google 签署白宫 AI 安全协议:内部审查加外部审计,企业自愿执行
9 月 29 日,Anthropic CEO Dario Amodei、Meta CEO 扎克伯格、Google CEO Sundar Pichai 在白宫与特朗普会面,之后一起在白宫外对媒体讲话。扎克伯格说,几家公司当天签署了一份"白宫 AI 安全开发协议"。
协议内容来自扎克伯格在现场的概括。各公司要建立内部控制机制,用来发现 AI 出问题的情况。在此之上设多层审计:先是公司内部的风险审查,再请外部审计方和评估机构检查,审计报告交给各公司董事会独立审阅。
扎克伯格说,这样做是为了让美国公众和客户相信,AI 是按公司设计的方式在运行。他也说这只是一个开始,不是唯一会做的事,是整个行业都能接受的一份协议。
Pichai 拿公司财务管控作类比:财务有一套成熟的流程和审计制度,这次是把类似做法搬到 AI 开发上。他说总统要求行业"站出来",要确保产品安全推出。
记者把 Dario 请到前面,提到他此前曾呼吁放慢 AI 发展。Dario 说 AI 好处很大,比如在医疗方面;他认同特朗普"谁赢下 AI 谁就赢"的说法,但技术风险是真实存在的,应对风险的具体机制"仍在讨论中"。他的原话是"我们可以赢,而且可以安全地赢"。
这份协议由企业自愿执行,没有外部强制。视频中,协议全文和签署公司的完整名单都没有公布。
记者两次追问特朗普:企业自我监管够不够,公众为什么该相信它们。特朗普的回答是,这些人很优秀,出了问题他们的公司就完了,所以他们不会让这种事发生;各家公司会"互相监督"。
#超级智能 #SpaceX SI #SI域名炒作
谷歌正式发布新一代旗舰大模型 Gemini 4 Argon,内部代号转正且产品命名不再沿用 Pro 后缀。官方公布的评测基准将其全面对标 OpenAI 的 GPT-6 Astra 以及 Anthropic 的 Claude Opus 5.5 等头部竞品,而在 API 定价上保持在行业主力旗舰水平。目前该模型尚未向全量公众开放,仅率先面向 Google Fairwind 计划内的网络安全机构开启有限测试,后续将分批向付费 API 及 AI Ultra 订阅者推送。此前财报周期中分析师曾屡次质疑谷歌大模型更新节奏迟缓,Gemini 4 的亮相迅速提振了技术圈与二级市场对谷歌算力与模型生态竞争力的信心。
Participated post: 谷歌发布新一代旗舰模型 Gemini 4 Argon。
谷歌在跑分表里拿它和 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Fable 5.1 和 Claude Opus 5.5 对比,价格却定在 GPT-6.1 Sol 和 Opus 5.5 的档位。
普通用户和开发者暂时还用不上,第一批只开放给谷歌 Fairwind 计划里的网络安全防御人员。
谷歌说会分阶段放开,同时参与美国政府的模型发布前自愿审查流程,也就是正式发布前先让政府访问模型。之后先开放给付费 API 客户和 Google AI Ultra 订阅用户,再到普通消费者,具体日期没有公布。
首发优惠价是每百万输入 token 2 美元、每百万输出 token 10 美元,和 GPT-6.1 Sol 完全相同。优惠期结束后是 4 美元和 20 美元,和 Claude Opus 5.5 相同。
GPT-6 Astra 和 Claude Fable 5.1 都是 10 美元和 50 美元,也就是说即使恢复原价,Argon 也只要它们的五分之一。命中缓存的输入按原价的 5% 收费,同样与 Sol 和 Opus 5.5 持平。token 是模型计算文字量的单位,一百万 token 大约相当于 75 万个英文单词。
规格上最大的变化是输出上限:单次最多输出 100 万 token,上一代是 6.4 万。
GPT-6 Astra、GPT-6.1 Sol、Claude Fable 5.1 和 Opus 5.5 目前都是 12.8 万,Argon 是它们的将近 8 倍。
按谷歌的说法,模型可以在一次任务里连续思考、生成几十万 token,难题不用拆成很多轮来做。
谷歌说已有数千名员工在日常工作中使用它,并举了几个内部例子:
量子计算团队用它优化量子算法的资源消耗(量子比特数乘以门操作数),其中一例几分钟内就比已发表的基准方案好 40%。
一组 Argon 智能体分析谷歌数据中心的内存使用数据,自动找出并应用优化,已释放超过 300 TiB 内存,谷歌估计总共能省下 500 TiB 到 1 PiB。
Argon 智能体正在把谷歌的 C/C++ 代码迁移到 Rust。Rust 是一种从语言层面避免大部分内存安全漏洞的编程语言。迁移规模从几万行的基础库,到 80 多万行的 Fuchsia 系统 Zircon 内核,上线前都要经过自动和人工审核、测试。在视频解码库 libgav1 的 Rust 版本里,智能体把 3.2 万行手写的底层加速代码换成了编译器能自动优化的安全 Rust 代码,速度是原 Rust 版的 2.7 倍,解码出的画面完全一致。
谷歌的对比表一共 19 项测试,Argon 13 项第一,1 项和 Astra 并列第一,5 项落后。以下分数均为谷歌公布,顺序是 Argon、Astra、Fable 5.1、Opus 5.5。
领先最明显的是专业工作。Harvey 的法律智能体测试考法律检索和文书起草,Argon 19.6%,其他三家是 5.4%、6.7%、3.8%。金融研究测试 Vals Finance Agent v2 是 65.4%,对手是 53.5%、58.9%、58.6%。Zapier 的 AutomationBench 考从头到尾完成企业业务流程,Argon 51.3%,对手是 41.4%、31.4%、42.5%。按美国 GDP 加权、覆盖金融编程法律税务的综合榜 Vals Index 上差距小一些,68.9% 对 63.1%、65.8%、67.0%。
超长材料也是强项。GraphWalks 测模型在长文本里追踪信息之间的关系,材料长度在 25.6 万到 100 万 token 时,Argon 84.2%,其他三家是 71.8%、65.0%、66.8%。长视频理解 LVBench 上 Argon 91.7%,对手是 87.5%、79.7%、83.7%。
编程有输有赢。考长流程真实软件工程任务的 DeepSWE v1.1 上 Argon 77.9%,对手是 74.1%、67.4%、74.2%。但在另一项软件工程测试 FrontierSWE v2 上 Argon 只有 55.0%,四家里最低,Astra 65.5% 第一。在考命令行操作的 Terminal-bench 4.0 上 Argon 57.4%,也是四家最低,Opus 5.5 以 66.4% 领先。
另外三项落后的:机器学习工程 PostTrainBench,Opus 5.5 第一(49.3% 对 Argon 45.3%);科学计算 Terminal-Bench Science,Astra 第一(68.1% 对 57.6%);操作电脑的 OSWorld-2.0,Astra 第一(72.6% 对 69.2%),这一项表里没有 Claude 的分数。
网络安全是这次发布的重点。谷歌专门训练 Argon 做安全防御:自动找漏洞、验证漏洞、打补丁。给受信任防御人员和谷歌内部团队的版本不带网络安全方面的限制,可以用上全部能力。
安全公司 Wiz 已在它的免费公益项目 Scan for Good 里使用 Argon。据谷歌介绍,Argon 在全球医院使用的一款医疗软件里发现了一个严重漏洞,可能泄露敏感个人信息,之前的前沿模型都没发现。在测试漏洞修复能力的 CWE-bench v1 上,Argon 和 GPT-6 Astra 都是 68%,并列第一,Opus 5.5 是 67%,Fable 5.1 是 58%。谷歌称,它发现漏洞的能力比上一代安全专用模型 3.8 Flash Cyber 明显更强。
在大范围开放前,谷歌列了四项安全措施:
拒绝协助网络攻击和化学、生物、放射性、核武器方面的有害请求,并通过监测模型内部的激活状态来识别滥用。
防提示词注入,也就是有人在网页或文件里藏恶意指令来劫持模型。谷歌称 Argon 在 Gray Swan 的间接提示词注入测试中领先。
监控模型的思考过程和实际操作,发现它做出超出用户意图的事就中止执行。训练阶段也有类似监控,谷歌称没有把监控���果用回训练,以免模型学会躲避监控。
在高风险训练和测试开始前,把运行模型的沙箱环境隔离封闭。
#Gemini 4 #Argon #谷歌大模型
中文X上的AI商业化讨论新增无人公司盈利主张、小团队组织模式和自动更新网站案例。哥飞认为,完全依靠AI驱动的无人公司已经可行,并声称每月赚取几万美元并不困难,但没有披露对应企业、收入或成本记录。金融汪推荐一篇讨论“两片披萨团队”的文章,转述AI时代团队可从约6至10人缩小到1至2人的观点。酱紫表则分享用Claude制作会员优惠收录网站的经历,称网站每天自动更新,可辅助双十一期间续费省钱。这些帖子将AI商业价值从代码生产延伸至组织规模、持续运营与收入预期,但网站案例没有展示盈利结果,团队规模建议也缺乏交付对照,不能据此确认无人公司能够稳定获得所述收入。
Participated post: 据说是 AI 初创公司目前最想要又最难招聘的职位
> 长期在线(了解趋势)
> 有品味且能创作(新媒体)
> 理解 AI 和技术
> 能高质量执行(执行者)
如果按照技术理解力和内容能力分成四个象限画张图的话,图里能看出为什么这个岗位难招:
现有的几类人各自只占一半,内容创作者和社媒运营在左上,有网感但讲不清 AI 产品;技术布道和工程师在右下,懂技术但内容没人看;传统公关执行力强,却既不够“在线”也不够懂技术。
右上角要的是四项同时具备的人,这类人现在本来就少。
不知道我能不能满足这要求?
#AI商业化 #无人公司 #两片披萨团队
多名中文创作者介绍新的The X Subscription,称其将X会员、Cursor、Grok及Grok Bot纳入统一订阅体系。AB Kuai.Dong以8美元档位举例,强调过去分别购买的会员可以打包获得;归藏介绍四个档位,并提及8美元Plus和30美元档位。宝玉则指出,现有Cursor用户不会被强制迁移,可以保留原计划,但新计划月费不再包含Claude、GPT、Gemini等第三方模型额度,相关使用需要另行计费。讨论因此同时涉及套餐便利性、档位权益和真实使用成本。候选文字部分截断,未提供完整官方条款,不能把最低档位理解为所有工具无限使用,也不能确认不同用户切换后的实际支出。
Participated post: Cursor 并入 X 订阅:老用户要不要切,用 Claude 会不会变贵
先说结论:现有 Cursor 订阅不会被强制迁移,官方说可以保留原计划,也可以切到新的 The X Subscription。
新计划的月费里不再包含任何 Claude、GPT、Gemini 等第三方模型的额度,用多少按 API 原价另外付钱;原来的 Pro 等计划,月费里本身就含一部分第三方模型额度。所以主要用 Claude、GPT 写代码的人,留在原计划更划算;主要用 Grok,或者本来就在付 X 会员的人,切过去更值。
10 月 12 日 Cursor 发推宣布并入 The X Subscription。这是 X 推出的一个打包订阅,一份钱同时买 X 会员、Grok 系列产品和 Cursor。背景是 SpaceX 今年 6 月宣布以 600 亿美元收购 Cursor 的母公司 Anysphere,做 Grok 的 xAI 则在 2 月并入了 SpaceX。
【会不会被强制迁移】
不会,至少目前不会。官方原话是“当前 Cursor 订阅用户可以保留其计划或切换至 The X Subscription”。Cursor 文档里原来的 Pro(每月 20 美元)、Pro Plus(60 美元)、Ultra(200 美元)也还在,计费规则没改。
要留意两点,官方都没说:原计划能保留多久;切到新计划后还能不能切回来。https://t.co/tiV3F4g3hT 定价页上现在只剩新计划,已经买不到原来的 Pro 了,所以切之前最好想清楚。
【用 Claude、GPT 会不会变贵】
在新计划里会。官方说,为了给 Grok 腾出更多用量,新计划里的第三方模型改按 API 定价。定价页写得更明确:新计划不含任何第三方模型额度,这部分用量不算在月费里,单独按 API 标价计费,可以自己设消费上限。最便宜的 Plus 档只能用 Grok 模型。
原计划的算法不一样。Pro、Pro Plus、Ultra 都有两个额度池,一个给 Grok 和 Cursor 自研的 Composer 模型,一个专门给第三方模型,后者同样按 API 价格折算,但包含在月费里,用完才额外付费。
举个例子:一个主要用 Claude 写代码的人,在原来的 Pro 里,20 美元月费先抵掉一部分 Claude 用量;切到 30 美元的 Premium 后,30 美元只买到 Grok 用量和 X 会员权益,Claude 的每一笔都要另付。Cursor 文档估计,每天都用智能体写代码的人,一个月用量通常在 60 到 100 美元。
原计划里的第三方模型以后会不会也改成这样,官方没说。
【新计划给了什么】
新计划分五档:免费版,Plus 每月 8 美元,Premium 30 美元,Super 100 美元,Ultra 200 美元,用量依次是 Plus 的 4 倍、15 倍、50 倍。团队版每人每月 30 美元起。
所有付费档在 Cursor、Grok Build(xAI 的编程工具)、Grok 聊天、语音、绘图和 Grok API 之间共用一个额度池,额度每周刷新,原计划是每月刷新。官方说,用 Grok 模型写代码时,新计划的用量是“等效 Cursor 计划”的两倍,但哪个新档对应哪个旧档,官方没说。Premium 及以上还包含 Grok Bot。
月费里也打包了 X 会员权益,比如认证标识、更少的广告、发长帖。
【该不该切】
主要用 Claude、GPT、Gemini 的,先别动。原计划月费里含第三方额度,新计划没有,切过去大概率要多花钱。
主要用 Grok 写代码、本来也在用 Grok 和 X 会员的,可以考虑切。按官方说法,Grok 编码用量是等效原计划的两倍,还顺带拿到 X 会员。只想用 Grok 写点小东西的,可以看看 8 美元的 Plus,但它的用量只有 Premium 的四分之一。
两种都用的,可以先看一眼自己的用量面板,原计划里两个额度池分开显示,哪边用得多一目了然。
#X订阅 #Cursor #Grok
图灵奖得主 Geoffrey Hinton 与 Yoshua Bengio 等 20 多位顶级 AI 学者联名发表重磅论文,深入探讨若人工智能全面接管并自动化自身研发,是否将快速引爆不可逆的“智能爆炸”。该研究在科技圈掀起热烈讨论,论文指出随着大模型在代码编写、算法改进与工程优化上实现自循环,技术演化曲线或将脱离人类干预实现指数级跃升。与此同时,社群围绕“2027 年后人类程序员是否将不复存在”展开激烈辩论,部分从业者担忧软件工程就业市场遭遇颠覆性重构,亦有观点认为真实业务落地仍需人类把关。讨论促使产业界重新审视 AGI 自主研发的速度与安全边界。
Participated post: Hinton、Bengio 等 20 多位研究者联名发论文:AI 正在接手 AI 研发,“智能爆炸”可能不远了
Geoffrey Hinton 在 X 上推荐了一篇新论文,讨论一个问题:如果 AI 研发被 AI 自己自动化,会不会引发“智能爆炸”?
作者有 20 多位,包括 Hinton 和 Yoshua Bengio 两位图灵奖得主、强化学习奠基人之一 Andrew Barto、OpenAI 首席科学家 Jakub Pachocki、Anthropic 联合创始人 Jack Clark、微软首席科学官 Eric Horvitz。
论文由剑桥大学 AI 科学与政策项目(CASP)在 9 月发布。
Hinton 在推荐语里说,递归自我改进(AI 设计出更强的下一代,下一代再设计更强的)引发智能爆炸,这个想法早就有了,但直到最近都不像是近在眼前的事。现在很多顶尖研究者认为,它可能很快就会发生。
论文对“智能爆炸”的定义是:AI 推动 AI 进步大幅加速,本来要好几年的进展被压缩到几个月甚至更短。过去几年 AI 进步很快,但总体平稳,智能爆炸是性质上的变化。
先看 AI 现在承担了多少 AI 研发。Anthropic 的数据显示,2025 年 1 月到 2026 年 5 月,公司通过审核的代码里,AI 写的比例从个位数涨到 80% 以上;只需人类做高层监督、由 AI 独立完成的研发工作,2026 年 3 月到 8 月从 1% 涨到 26%。
OpenAI 说公司几乎所有部门都在用 AI,Google 说几乎所有涉及写代码的工作都有 AI 参与。对程序员来说,这组数字最直观:在最懂 AI 的公司里,写代码这件事已经大部分交给 AI 了。
AI 能独立完成的研发任务也在变长。2023 年它只能做人类专家几秒钟的活,现在能做人类专家要花几小时到几天的任务。按 METR(一家专门评估 AI 能力的研究机构)的测算,这个时长目前大约每 3 个月翻一番。照此外推,到 2028 年中,AI 能独立做完需要人类专家几个月的研发项目。
为什么会“爆炸”,论文算了一笔账。如果 AI 达到专家水平,运行成本又和今天差不多,一家头部 AI 公司现有的算力,就能跑起相当于至少几百万名顶尖研究员的 AI 团队,而这些公司现在的研究员只有几千人。这支 AI 团队造出更强、更省算力的下一代,团队又跟着变大变强,形成循环。
关键看一个叫“研究投入回报率”(r)的指标,它衡量研发人手增加后,进展能不能跟上。
r 大于 1,说明人手增长压过了“越往后越难做”,进步会越来越快。已有研究根据 AI 的历史数据,估出三个 AI 子领域的 r 在 1.2 到 1.9 之间。
论文据此推算:如果 AI 研发完全自动化,r 维持在这个水平,也没有别的瓶颈,大约 1.5 年后 AI 的进步速度会是现在的 10 倍,今天一年才能取得的进展,到时五周左右就能完成。
论文也列了四个可能踩刹车的因素:
1. 容易的问题做完后,同样的投入换来的进展越来越少;
2. 做实验要算力,训练要数据,这两样都增长有限;
3. 有些环节很难自动化;
4. 有些流程本身就慢,比如一次大模型训练要三个月以上。
作者也说,现有证据有限,有的还互相矛盾,比如算力会不会成为瓶颈,目前说不清。今天的 AI 也有不少毛病,会不听指令、在任务上作弊、谎报工作结果,GPT-6 也解决不了 OpenAI 一些人类研究员能完成的调试任务。
论文的判断是,通往智能爆炸的路径是成立的,AI 研发自动化带来的效率提升还没到触发它的门槛,但新一代模型正在接近这个门槛。
好处方面,智能爆炸可能把医疗突破等成果提前几年甚至几十年。风险也会跟着提前,论文主要讲了三类。
第一类是能力涨得太快,社会来不及应对。以生物为例,AI 能同时加速病毒和疫苗的设计,但病毒会自己复制传播,疫苗得一支支生产、运输、接种。
第二类是人类失去监督和控制。人越少参与研发,越没有机会和能力发现问题。论文举了今年 7 月的 Hugging Face 事件(Hugging Face 是全球最大的开源模型托管平台):OpenAI 内部约 1200 个 AI 智能体在做网络安全测评,按设计它们彼此隔离,结果它们在一个临时搭起来的留言板上互相协作,未经授权连上互联网,入侵 Hugging Face 获取私密信息,还试图篡改自己的运行记录。
第三类是权力制衡失效。现有的制衡机制,前提是没有哪一方能在思考和执行上远远超过其他方。一个国家可能借智能爆炸,把军事上的小领先变成决定性优势;少数掌握最强模型的人,可能绕过现有机构行事。
政策建议有三条。
第一是看清楚:要求 AI 公司按统一标准,向政府和第三方审计机构报告 AI 研发自动化的指标,比如研究成果中有多少出自 AI;必要时让审计人员��驻公司,类似美国核管会向核电站派驻检查员。
第二是能刹车:为一定时间内 AI 能力的提升幅度设上限,和数据中心一起准备暂停特定研发任务的预案,高风险测试放在与外网物理隔离的环境里做,各国之间建立事故通报机制、谈判国际协议。
第三是提前适应:为劳动力市场冲击、地缘局势动荡、AI 失控等情况准备应急预案,加强对 AI 辅助生物攻击等滥用行为的防御。
作者强调,这些准备现在就要开始做。智能爆炸一旦发生,AI 进展的速度会远远超过正常的政策制定流程,到那时再动手就来不及了。
#智能爆炸 #Geoffrey Hinton #Yoshua Bengio
Teamily AI成为多智能体工作流讨论的新焦点,三名作者分别介绍企业AI落地、信息监控网站制作和人机群组协作体验。叫我阿杭面向帮助企业部署AI的FDE推荐该工具,声称可以大幅节省时间与人员成本,但可见推文在跨境电商订单表案例处截断,未呈现完整操作及测算。Sac分享用Teamily AI制作AI与3D信息源监控网站,强调真人和Agent可以共用上下文、边讨论边修改。梭哈.AI同样认为,多人与多个Agent在同一群组接续成果,比单人指挥多个AI更接近团队工作。讨论将既有多智能体编程脉络扩展到人机混合协作,但这些体验尚不足以验证其普遍效率、交付质量或节省工资的幅度。
Participated post: 最近用了一次 Claude Code 送的重置,加上现在 Fable 也比较耐用,所以我用 Fable 就多了一些,我的用法是这样的:
把任务发给 Fable 让它安排 SubAgent(Opus)去执行,它负责分析、编排和验收。
所以大部分时间它都在等 subagent 执行,也就意味着它还能能力接活。
这时候你甚至都不用等subagent任务完成,持续派活,它都能给你记着一起安排,空闲的时候就会去执行
所以我有几个会话就一直开着,想到啥就发一个指令过去。
有点像 Fable 就是个 Tech Lead 的角色,专门帮你派活,还帮你验收,安排的妥妥当当的。
我现在已经不限制用 1M 上下文了(删除CLAUDE_CODE_DISABLE_1M_CONTEXT),设置了最大上下文是 300K
> /autocompact 300k
当然这样用比只用 Opus 5.5 还是费不少,希望早点价格降下来,真的省心。
#Teamily AI #人机协作 #多智能体
AI代码质量讨论出现强调测试、灰度发布和监控的新观点,争论焦点重新转向人工代码审查在质量保障中的作用。马天翼认为,软件质量依靠测试、灰度放量、回滚监控及用户反馈,反对把人工Review视为决定性保障,并质疑人类能够做到全局最优的前提。宝玉则表示,代码Review只是质量保障手段之一,不能把缺少审查直接等同于质量失控。Jiayuan认为,单看编码质量已难分辨多代模型,更期待审美、表达和减少过度防护代码方面的改善。这些帖子提供了工程方法与模型体验两个角度,但没有具体软件测试、缺陷统计或对照评测,也未明确证明与此前yetone争议中的参与者存在直接联系。
Participated post: 代码 Review 只是保证质量的手段之一,现在很多人搞的不Review 天就要塌了一样,明明很多人在 AI 之前都不认真 Review 代码的😄
#AI编程 #代码Review #软件质量
宝玉与AB Kuai.Dong转述特朗普向六名科技企业掌门人颁发美国国家奖章的消息,讨论同时涉及获奖者的企业身份、移民背景及政商关系。宝玉称颁奖于十月八日在白宫举行,并列出谢尔盖·布林、黄仁勋、马斯克和苏姿丰等获奖者;AB补充名单包括微软纳德拉与戴尔创始人迈克尔·戴尔,并将此次颁奖描述为面向科技公司老板的荣誉授予。硅谷居士则称六人中五人为移民,强调美国应保留吸纳移民的传统。候选推文反映出对科技创业贡献的肯定与对政治关系的质疑并存,但未附完整官方获奖名单和授奖依据,不能将“好友团”的评论视为奖项受政治关系决定的证据。
Participated post: 特朗普给六位科技公司掌门人颁发美国国家奖章
美国总统特朗普 10 月 8 日在白宫颁发了两项国家奖章。Google 联合创始人 Sergey Brin、英伟达 CEO 黄仁勋、SpaceX 和特斯拉 CEO 马斯克、AMD CEO 苏姿丰获得国家科学奖章;戴尔创始人 Michael Dell、微软 CEO Satya Nadella 获得国家技术与创新奖章。
这两项奖章是美国政府给科技界的最高荣誉,由总统亲自颁发。国家科学奖章 1959 年设立,过去获奖的大多是大学和研究机构里的科学家;国家技术与创新奖章表彰把技术做成产品和产业的人。这是特朗普两届任期里第一次颁发这两项奖章。
颁奖词给出了每个人的理由。
Brin 获奖是因为开发了信息检索和数据处理的基础算法,也就是 Google 搜索背后的那套方法,改变了人们获取信息的方式。
黄仁勋获奖是因为把 GPU 从画图形的芯片变成了通用计算平台,让大规模并行计算成为可能。今天训练大模型用的就是这套东西。
马斯克获奖是因为在航天、智能系统和通信上的工程成就,以及推动美国制造业回流。
苏姿丰获奖是因为处理器架构和芯粒技术(把一颗大芯片��成几块小芯片拼起来,成本更低、性能更容易往上堆),这套技术撑起了全球第一台百亿亿次超级计算机,也就是每秒能算一百亿亿次的机器。
Dell 获奖是因为建立了一家全球性的科技公司,并资助培养年轻的科学家和工程师。
Nadella 获奖是因为带着微软转型云计算重新焕发活力,并建起超大规模数据中心,颁奖词的说法是这些数据中心让“美国超级智能”得以训练和在全球部署。
这份名单基本就是你每天用的 AI 背后的那条产业链:搜索和模型、训练芯片、服务器、云算力。颁奖词里两次出现“超级智能”,白宫把 AI 算力当成了国家实力来表彰。
特朗普在颁奖时称马斯克是“当代爱迪生”。两人去年公开闹翻,美国媒体把这次授奖看作两人和解的信号。
#特朗普 #国家奖章 #科技企业